Termo do glossário · · 5 min de leitura
Overfitting
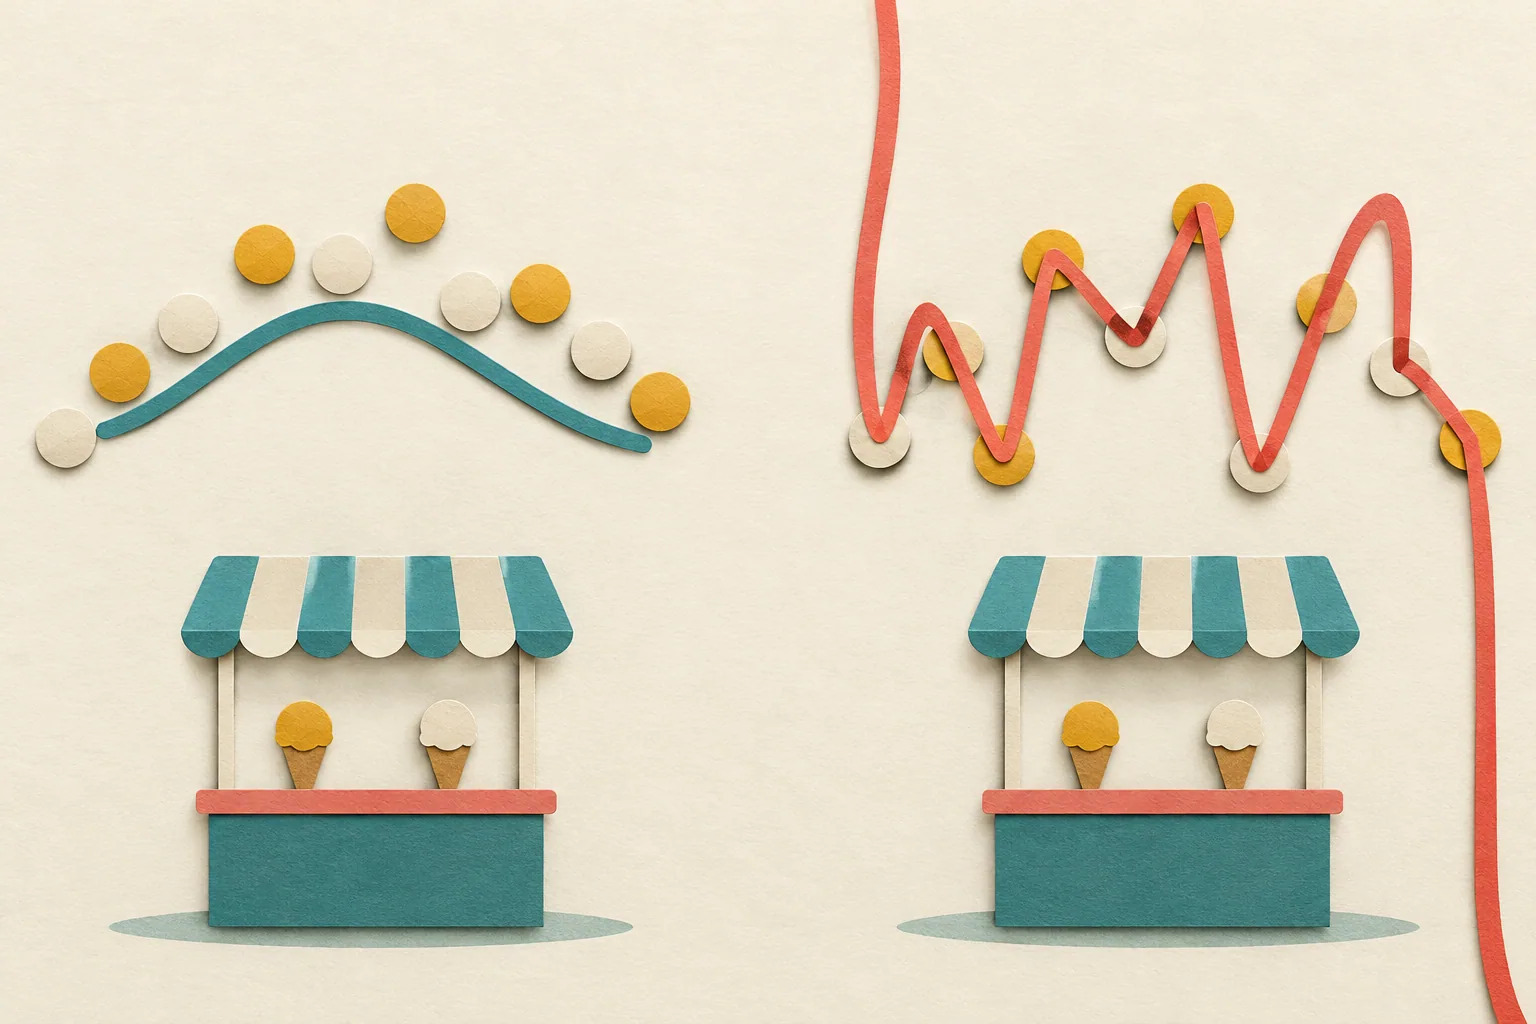
Você tem um quiosque de sorvete. Durante 10 dias, anotou em um caderno a temperatura ao meio-dia e o número de bolas vendidas. Quer tirar dessas anotações uma regra: amanhã vai fazer 24°C, quanto sorvete preparar?
A regra mais simples é uma linha reta: “cada grau a mais são algumas bolas a mais”. No exemplo desta nota, ela erra nos dias anotados tipicamente em 27,5 bolas, porque não vê que, no calor mais forte, as vendas caem. Pode-se então dar mais liberdade à regra e deixar a curva fazer voltas. A mais flexível das curvas testadas passa exatamente por todos os 10 pontos. O erro dela nos dias do caderno é 0.
Parece a regra perfeita. Só que os dias do caderno já passaram, e a regra precisa funcionar amanhã. Em 400 dias novos do mesmo quiosque, a curva “perfeita” erra tipicamente em 236,5 bolas. Uma curva moderadamente flexível, que se saía pior no caderno (10,9), erra nos dias novos em 16,8.
Overfitting é a situação em que um modelo tem um erro pequeno nos dados usados no treinamento e, em comparação com ele, um erro grande demais em dados novos do mesmo tipo (Goodfellow, Bengio e Courville, Deep Learning, §5.2). O modelo se ajustou a características do seu conjunto que não se repetem fora dele. O problema inverso se chama underfitting: a regra é simples demais para descrever bem até os dados que viu. É assim que se comporta a linha reta do nosso exemplo.
De onde vem essa diferença
Cada anotação do caderno é feita de duas coisas: uma regularidade (mais calor, portanto mais sorvete) e o acaso (justo naquele dia chegou uma excursão). A regra deve captar a primeira e deixar a segunda de fora. O modelo, porém, não sabe o que é o quê. Ele só vê pontos.
O quanto de acaso o modelo absorve depende da sua flexibilidade, chamada na literatura de capacity: a capacidade de se ajustar a muitas formas diferentes. A curva do exemplo é descrita por 2 a 10 números, escolhidos de acordo com os dados; a quantidade deles é o grau da curva mais um. Uma curva de grau 9 tem 10 desses números para 10 dias, então consegue acertar todos os pontos, com todo o acaso junto. Os autores do livro descrevem assim: um modelo muito flexível pode representar a relação correta, mas também uma infinidade de outras, que se ajustam igualmente bem aos dados de treinamento, e é pequena a chance de que escolha justamente aquela que vai funcionar adiante (§5.2).
O percurso típico é o seguinte: quando a flexibilidade cresce, o erro nos dados de treinamento diminui, e o erro em dados novos primeiro diminui e depois começa a crescer (§5.2, figura 5.3). Daí sai uma regra prática. Não se avalia um modelo nos dados com que ele treinou, e não se escolhe a flexibilidade pelo erro nesses dados, porque ele sempre apontará a maior. Uma parte dos dados é posta de lado: o validation set [Polski] serve para escolher os ajustes, e um test set separado, para a avaliação final (§5.3).
Confira você mesmo
Abaixo está o mesmo quiosque. Todos os números desta nota podem ser reproduzidos: depois de clicar em “Recomeçar”, veem-se 10 dias, e os experimentos 1–5 configuram os casos descritos.
Vale fazer duas coisas que um gráfico estático não mostra. Primeiro, ative “24 outros cadernos” e mude o grau: com grau baixo, as linhas cinza ficam próximas umas das outras; com grau alto, espalham-se para todos os lados, embora cada uma venha do mesmo quiosque. Segundo, arraste um ponto bem para cima. A curva de grau 2 se desloca só um pouco, e a curva de grau 9 se refaz em toda a extensão para acertá-lo.
O que ajuda
- Mais dados. Com 80 dias, a mesma curva de grau 9 erra tipicamente em 14,8 bolas no caderno e em 15,9 nos dias novos. A diferença quase desaparece, porque a curva já não consegue acertar todos os pontos (§5.2).
- Menos flexibilidade. Curva de grau 3 com 10 dias: 10,9 no caderno, 16,8 nos dias novos.
- Regularization, isto é, uma mudança na forma de treinar cujo objetivo é reduzir o erro em dados novos, e não nos de treinamento (§5.2.2). Um exemplo é a penalidade para coeficientes grandes, aparentada com o Weight decay [Polski]: a curva de grau 9 com penalidade λ = 0,01 erra em 5,8 no caderno e em 21,2 nos dias novos, em vez de 236,5.
Nenhum desses ajustes pode ser escolhido olhando apenas para o erro nos dados de treinamento.
Limitações
- É um exemplo próprio, com uma única grandeza de entrada e dados simulados. Aqui o acaso, sozinho, dá tipicamente 15 bolas de erro, e nenhuma regra fica abaixo disso nos dias novos.
- A forma “primeiro melhora, depois piora” é típica, não garantida. Os autores observam que, em redes profundas, é difícil até determinar a flexibilidade efetiva do modelo, porque ela depende também do algoritmo de treinamento (§5.2). O número de parâmetros de um LLM, portanto, não diz sozinho se o modelo sofre de overfitting.
- Um erro pequeno em dados novos vale para dados da mesma origem. Se o quiosque se mudar para a beira do mar, o caderno da cidade não promete nada.
Relações
- Weight decay [Polski] limita o tamanho dos pesos e é uma das formas de reduzir a diferença entre o erro nos dados de treinamento e nos novos.
- Grokking [Polski] descreve casos em que um modelo que parecia sofrer de overfitting passa, depois de um longo treinamento adicional, a funcionar bem em dados novos.
- Fine-tuning [Polski] em um conjunto pequeno exige o mesmo controle: dados separados, que o modelo não viu durante o treinamento.
- Catastrophic Forgetting [Polski] é outro problema: lá o modelo perde uma habilidade antiga depois de um novo treinamento, e aqui ele já de início generaliza mal para fora dos próprios dados de treinamento.