Terme du glossaire · · 6 min de lecture
Overfitting
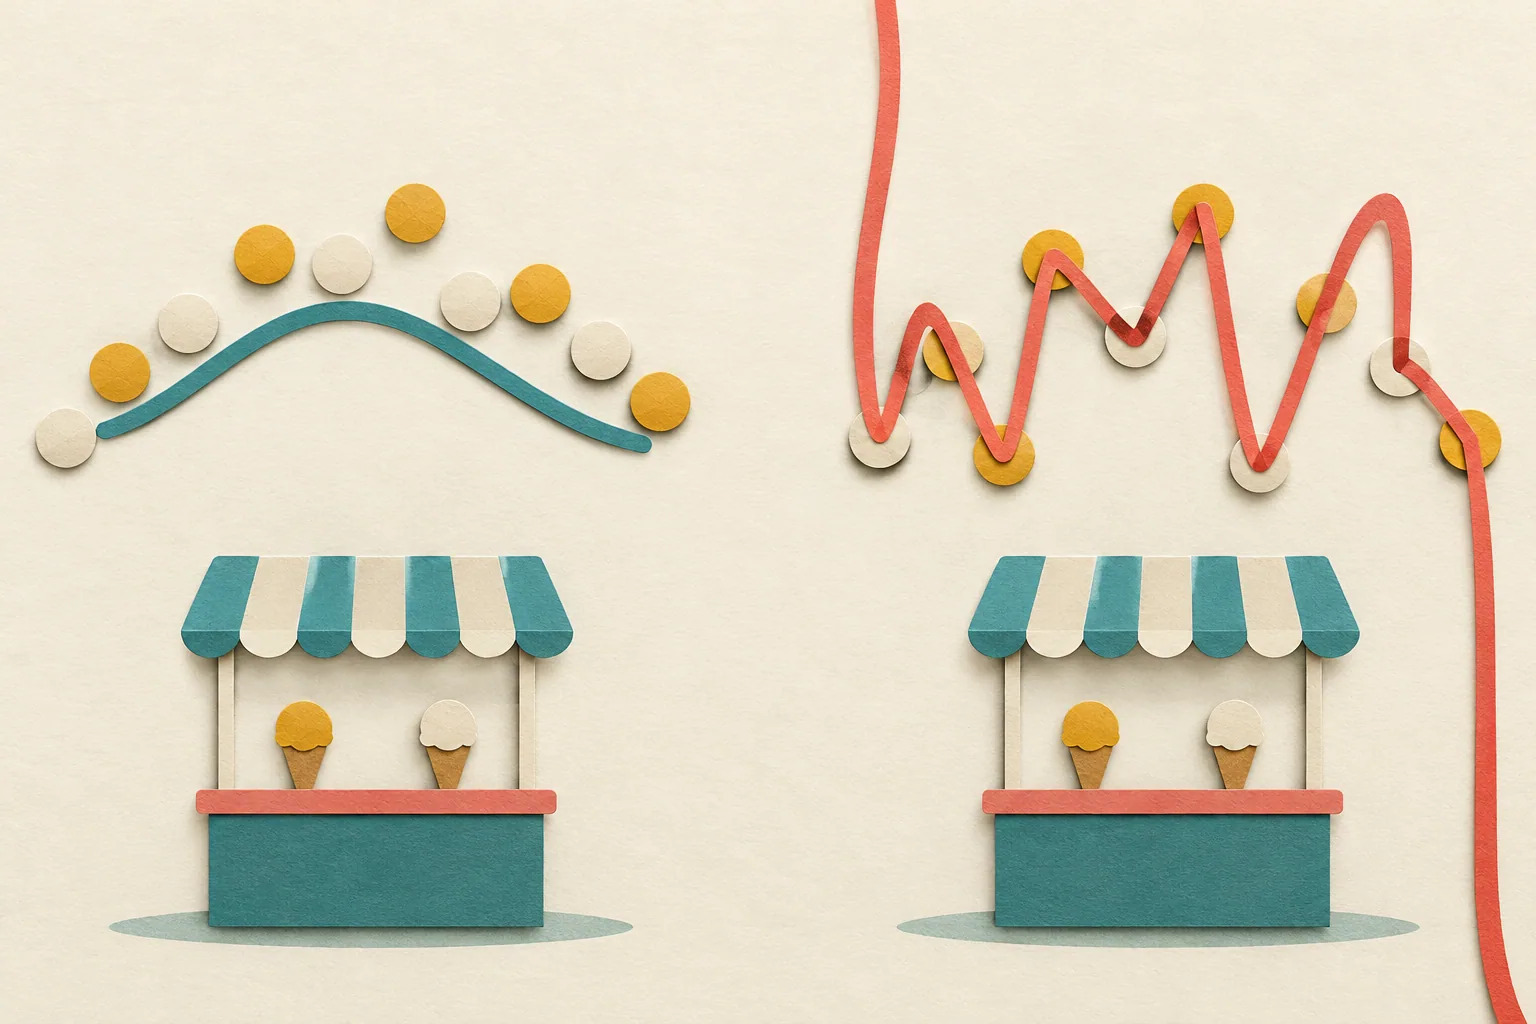
Vous tenez un stand de glaces. Pendant 10 jours, vous avez noté dans un carnet la température à midi et le nombre de boules vendues. Vous voulez tirer une règle de ces notes : demain, il fera 24 °C, combien de glaces faut-il préparer ?
La règle la plus simple est une droite : « chaque degré de plus, ce sont quelques boules de plus ». Dans l’exemple de cette note, elle se trompe typiquement de 27,5 boules sur les jours notés, car elle ne voit pas que les ventes baissent pendant les plus fortes chaleurs. On peut donc laisser plus de liberté à la règle et permettre à la courbe de tourner. La plus souple des courbes essayées passe exactement par les 10 points. Son erreur sur les jours du carnet vaut 0.
Elle a tout d’une règle parfaite. Sauf que les jours du carnet sont déjà passés, et que la règle doit servir demain. Sur 400 nouveaux jours du même stand, la courbe « parfaite » se trompe typiquement de 236,5 boules. Une courbe modérément souple, qui faisait moins bien sur le carnet (10,9), se trompe de 16,8 sur les nouveaux jours.
L’overfitting est la situation où un modèle a une petite erreur sur les données utilisées pour l’apprentissage et, en comparaison, une erreur trop grande sur de nouvelles données du même type (Goodfellow, Bengio et Courville, Deep Learning, §5.2). Le modèle s’est ajusté à des particularités de son jeu de données qui ne se répètent pas ailleurs. Le problème inverse s’appelle l’underfitting : la règle est trop simple pour bien décrire même les données qu’elle a vues. C’est ainsi que se comporte la droite de notre exemple.
D’où vient cet écart
Chaque ligne du carnet est faite de deux choses : une régularité (il fait plus chaud, donc plus de glaces) et du hasard (un car de touristes est justement passé). La règle doit saisir la première et laisser la seconde de côté. Mais le modèle ne sait pas distinguer l’une de l’autre. Il ne voit que des points.
La quantité de hasard que le modèle absorbe dépend de sa souplesse, appelée capacity dans la littérature : son aptitude à s’ajuster à de nombreuses formes différentes. Dans l’exemple, la courbe est décrite par 2 à 10 nombres que l’on ajuste aux données ; leur nombre est le degré de la courbe plus un. Une courbe de degré 9 dispose de 10 nombres pour 10 jours : elle peut donc toucher chaque point, avec tout le hasard qu’il contient. Les auteurs du manuel le décrivent ainsi : un modèle très souple peut représenter la bonne relation, mais aussi une foule d’autres qui collent tout aussi bien aux données d’apprentissage, et il y a peu de chances qu’il choisisse justement celle qui tiendra ensuite (§5.2).
Le déroulement typique est le suivant : quand la souplesse augmente, l’erreur sur les données d’apprentissage diminue, tandis que l’erreur sur les nouvelles données commence par diminuer, puis se met à augmenter (§5.2, figure 5.3). Il en découle une règle pratique. On n’évalue pas un modèle sur les données sur lesquelles il a appris, et on ne choisit pas la souplesse d’après l’erreur sur ces données, car celle-ci désignera toujours la plus grande. On met une partie des données de côté : le validation set [Polski] sert à choisir les réglages, et un test set distinct sert à l’évaluation finale (§5.3).
Essayez vous-même
Voici le même stand. Tous les chiffres de cette note peuvent être reproduits : un clic sur « Recommencer » affiche 10 jours, et les expériences 1 à 5 règlent les cas décrits.
Deux choses valent la peine d’être faites, qu’un graphique statique ne montre pas. D’abord, activez « 24 autres carnets » et faites varier le degré : quand il est bas, les lignes grises restent proches les unes des autres ; quand il est élevé, elles partent dans tous les sens, alors que chacune vient du même stand. Ensuite, faites glisser un point très haut. La courbe de degré 2 ne bougera qu’un peu, tandis que la courbe de degré 9 se reconstruira sur toute sa longueur pour l’atteindre.
Ce qui aide
- Plus de données. Avec 80 jours, la même courbe de degré 9 se trompe typiquement de 14,8 boules sur le carnet et de 15,9 sur les nouveaux jours. L’écart disparaît presque, car la courbe ne peut plus toucher chaque point (§5.2).
- Moins de souplesse. Courbe de degré 3 sur 10 jours : 10,9 sur le carnet, 16,8 sur les nouveaux jours.
- Regularization, c’est-à-dire une modification de la méthode d’apprentissage destinée à réduire l’erreur sur les nouvelles données, et non sur les données d’apprentissage (§5.2.2). Un exemple en est la pénalité pour les grands coefficients, apparentée au Weight decay [Polski] : la courbe de degré 9 avec une pénalité λ = 0,01 se trompe de 5,8 sur le carnet et de 21,2 sur les nouveaux jours, au lieu de 236,5.
Aucun de ces réglages ne peut être choisi en regardant uniquement l’erreur sur les données d’apprentissage.
Limites
- C’est un exemple personnel, avec une seule grandeur d’entrée et des données simulées. Le hasard seul donne ici typiquement 15 boules d’erreur, et aucune règle ne descendra plus bas sur les nouveaux jours.
- La forme « d’abord mieux, puis moins bien » est typique, pas garantie. Les auteurs soulignent que, dans les réseaux profonds, il est difficile ne serait-ce que d’établir la souplesse effective d’un modèle, car elle dépend aussi de l’algorithme d’apprentissage (§5.2). Le nombre de paramètres d’un LLM ne dit donc pas, à lui seul, si le modèle est surajusté.
- Une petite erreur sur de nouvelles données concerne des données de la même source. Si le stand déménage au bord de la mer, le carnet tenu en ville ne promet rien.
Notes liées
- Weight decay [Polski] limite la taille des poids et constitue l’un des moyens de réduire l’écart entre l’erreur sur les données d’apprentissage et l’erreur sur les nouvelles.
- Grokking [Polski] décrit des cas où un modèle qui semble surajusté se met, après un long entraînement supplémentaire, à bien fonctionner sur de nouvelles données.
- Fine-tuning [Polski] sur un petit jeu de données exige le même contrôle : des données distinctes, que le modèle n’a pas vues pendant l’apprentissage.
- Catastrophic Forgetting [Polski] est un autre problème : là, le modèle perd une ancienne compétence après un nouvel apprentissage ; ici, il se généralise mal dès le départ au-delà de ses propres données d’apprentissage.