शब्दावली का शब्द · · 5 मिनट का पाठ
Overfitting
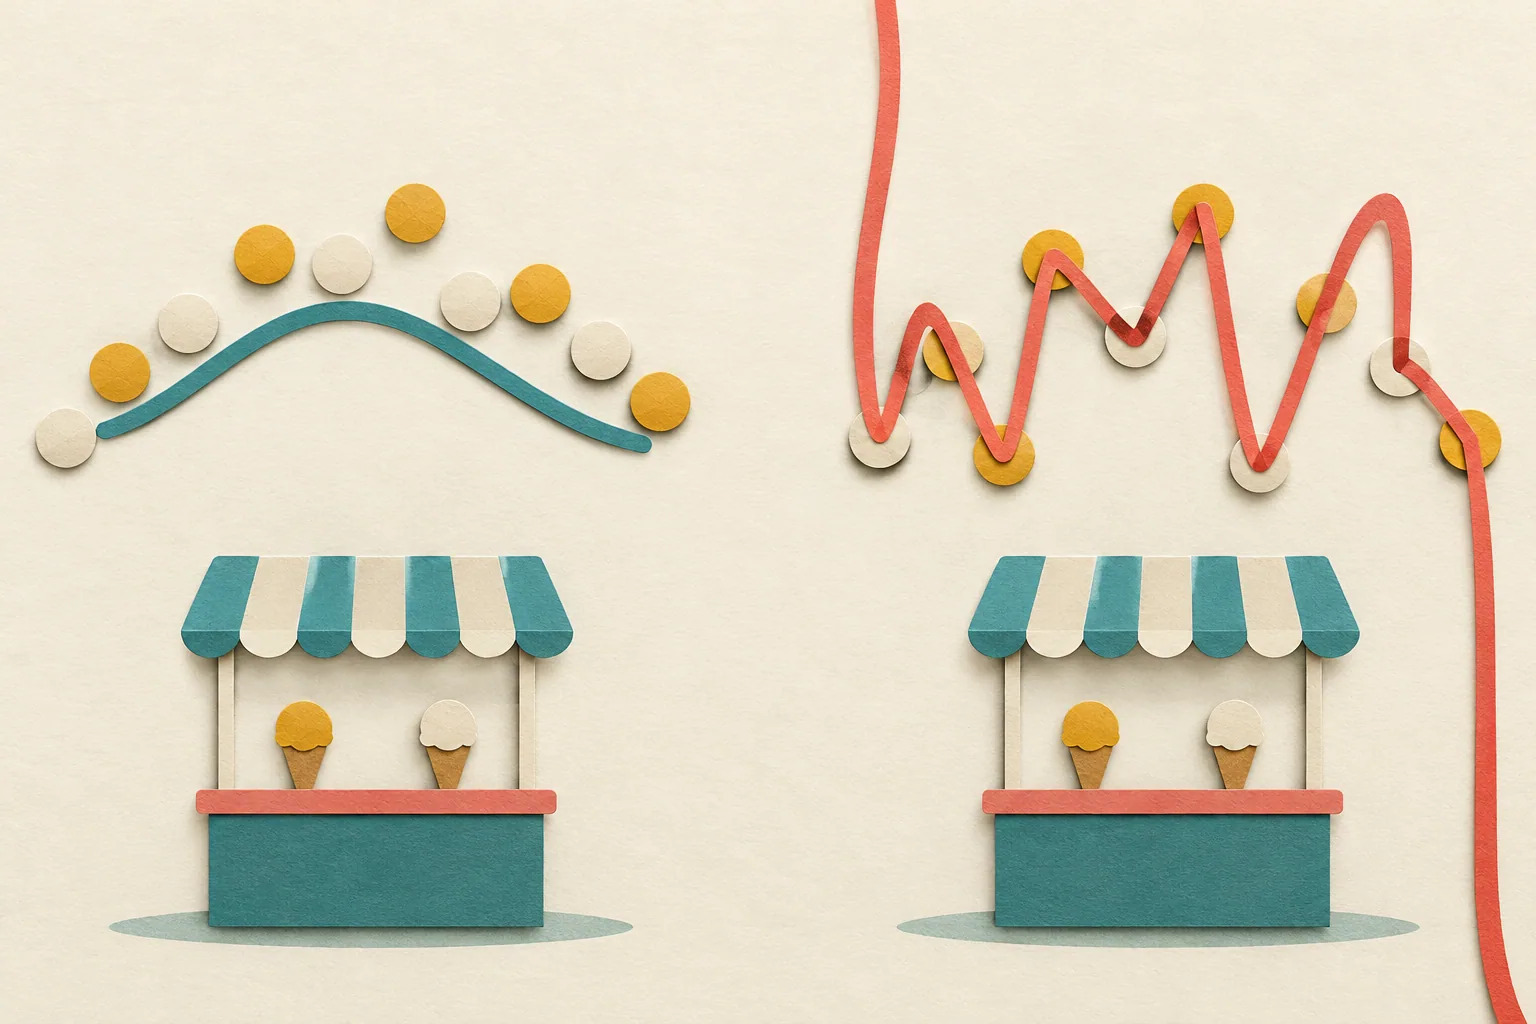
आप आइसक्रीम का एक स्टॉल चलाते हैं। 10 दिन तक आपने नोटबुक में दोपहर का तापमान और बिके हुए स्कूप की संख्या लिखी। आप इन notes से एक नियम बनाना चाहते हैं: कल 24°C रहने वाला है, कितनी आइसक्रीम तैयार रखी जाए?
सबसे सरल नियम एक सीधी रेखा है: "हर एक डिग्री ज़्यादा यानी कुछ स्कूप ज़्यादा"। इस note के उदाहरण में वह नोटबुक में दर्ज दिनों पर आम तौर पर 27.5 स्कूप से चूकता है, क्योंकि उसे यह नहीं दिखता कि सबसे तेज़ गर्मी में बिक्री गिर जाती है। तो नियम को ज़्यादा छूट दी जा सकती है और curve को मुड़ने दिया जा सकता है। आज़माए गए curves में सबसे लचीला curve ठीक सभी 10 बिंदुओं से होकर गुज़रता है। नोटबुक के दिनों पर उसकी error 0 है।
यह एकदम सही नियम जैसा दिखता है। बस इतना है कि नोटबुक के दिन बीत चुके हैं, और नियम को कल काम करना है। उसी स्टॉल के 400 नए दिनों पर यह "एकदम सही" curve आम तौर पर 236.5 स्कूप से चूकता है। मध्यम लचीलेपन वाला curve, जो नोटबुक पर ख़राब दिख रहा था (10.9), नए दिनों पर 16.8 से चूकता है।
Overfitting वह स्थिति है जिसमें model की error सीखने में इस्तेमाल हुए data पर छोटी होती है, और उसी तरह के नए data पर उसके मुकाबले बहुत बड़ी (Goodfellow, Bengio और Courville, Deep Learning, §5.2)। Model अपने data set की उन ख़ासियतों पर fit हो गया जो उसके बाहर दोहराई नहीं जातीं। उलटी मुश्किल को underfitting कहते हैं: नियम इतना सरल है कि उस data को भी ठीक से नहीं बता पाता जो उसने देखा है। हमारे उदाहरण की सीधी रेखा ऐसा ही बर्ताव करती है।
यह अंतर कहाँ से आता है
नोटबुक की हर entry दो चीज़ों से बनी है: नियमितता (गर्मी ज़्यादा, तो आइसक्रीम ज़्यादा) और संयोग (उस दिन संयोग से सैलानियों का एक दल आ गया)। नियम को पहली चीज़ पकड़नी है और दूसरी छोड़ देनी है। लेकिन model को नहीं पता कि क्या क्या है। उसे सिर्फ़ बिंदु दिखते हैं।
Model कितना संयोग सोख लेगा, यह उसके लचीलेपन से तय होता है, जिसे साहित्य में capacity कहते हैं: कई अलग-अलग शक्लों पर fit हो सकने की क्षमता। उदाहरण के curve को 2 से 10 संख्याएँ बताती हैं, जिन्हें data के हिसाब से चुना जाता है; उनकी गिनती curve की degree से एक ज़्यादा है। Degree 9 वाले curve के पास 10 दिनों के लिए ऐसी 10 संख्याएँ हैं, इसलिए वह हर बिंदु पर जा बैठ सकता है, सारे संयोग समेत। पाठ्यपुस्तक के लेखक इसे यूँ बताते हैं: बहुत लचीला model सही संबंध को तो दिखा सकता है, लेकिन ढेरों दूसरे संबंधों को भी, जो training data पर उतने ही अच्छे बैठते हैं, और इसकी संभावना कम है कि वह ठीक वही चुने जो आगे भी काम आए (§5.2)।
आम तौर पर सिलसिला ऐसा रहता है: लचीलापन बढ़ने पर training data पर error घटती है, जबकि नए data पर error पहले घटती है, फिर बढ़ने लगती है (§5.2, चित्र 5.3)। इससे एक व्यावहारिक नियम निकलता है। Model को उस data पर नहीं परखा जाता जिस पर उसने सीखा, और लचीलापन उस data की error देखकर नहीं चुना जाता, क्योंकि वह हमेशा सबसे ज़्यादा लचीलेपन की ओर इशारा करेगी। Data का एक हिस्सा अलग रख दिया जाता है: validation set [Polski] settings चुनने के काम आता है, और अलग test set अंतिम मूल्यांकन के (§5.3)।
ख़ुद जाँचिए
नीचे वही स्टॉल है। इस note की सारी संख्याएँ दोबारा निकाली जा सकती हैं: "शुरू से" पर click करने पर 10 दिन दिखते हैं, और प्रयोग 1–5 बताए गए मामलों को set कर देते हैं।
दो चीज़ें करके देखने लायक़ हैं, जो स्थिर chart नहीं दिखाता। पहली, "24 और नोटबुक" चालू कीजिए और degree बदलिए: कम degree पर धूसर रेखाएँ एक-दूसरे के पास रहती हैं, ऊँची degree पर हर तरफ़ बिखर जाती हैं, जबकि हर एक उसी स्टॉल से आई है। दूसरी, किसी एक बिंदु को खींचकर बहुत ऊपर ले जाइए। Degree 2 वाला curve बस थोड़ा-सा खिसकेगा, जबकि degree 9 वाला curve उस बिंदु पर पहुँचने के लिए अपनी पूरी लंबाई में बदल जाएगा।
क्या मदद करता है
- ज़्यादा data। 80 दिनों पर वही degree 9 वाला curve नोटबुक पर आम तौर पर 14.8 स्कूप से और नए दिनों पर 15.9 से चूकता है। अंतर लगभग मिट जाता है, क्योंकि curve अब हर बिंदु पर नहीं बैठ सकता (§5.2)।
- कम लचीलापन। 10 दिनों पर degree 3 वाला curve: नोटबुक पर 10.9, नए दिनों पर 16.8।
- Regularization, यानी training के तरीके में ऐसा बदलाव जिसका मक़सद नए data पर error घटाना है, training data पर नहीं (§5.2.2)। इसका एक उदाहरण बड़े coefficients पर penalty है, जो Weight decay [Polski] से जुड़ी हुई है: penalty λ = 0.01 के साथ degree 9 वाला curve नोटबुक पर 5.8 से और नए दिनों पर 21.2 से चूकता है, 236.5 की जगह।
इनमें से कोई भी setting सिर्फ़ training data की error देखकर नहीं चुनी जा सकती।
सीमाएँ
- यह मेरा अपना उदाहरण है, जिसमें एक ही input मात्रा और simulated data है। यहाँ सिर्फ़ संयोग ही आम तौर पर 15 स्कूप की error देता है, और नए दिनों पर कोई नियम इससे नीचे नहीं जाएगा।
- "पहले बेहतर, फिर बदतर" वाली शक्ल आम है, गारंटी नहीं। लेखक बताते हैं कि deep networks में model का असल लचीलापन तय करना भी मुश्किल है, क्योंकि वह training algorithm पर भी निर्भर करता है (§5.2)। इसलिए LLM के parameters की संख्या अकेले यह नहीं बताती कि model overfit है या नहीं।
- नए data पर छोटी error उसी स्रोत के data के बारे में है। अगर स्टॉल समुद्र किनारे चला जाए, तो शहर वाली नोटबुक किसी बात का वादा नहीं करती।
संबंधित विषय
- Weight decay [Polski] weights के आकार को सीमित करता है और training data तथा नए data की error के बीच का अंतर घटाने के तरीकों में से एक है।
- Grokking [Polski] उन मामलों को बताता है जिनमें overfit दिखने वाला model लंबी अतिरिक्त training के बाद नए data पर अच्छा काम करने लगता है।
- छोटे data set पर Fine-tuning [Polski] के लिए भी यही जाँच चाहिए: अलग data, जिसे model ने training के दौरान नहीं देखा।
- Catastrophic Forgetting [Polski] एक अलग समस्या है: वहाँ model नई training के बाद पुरानी क्षमता खो देता है, जबकि यहाँ वह शुरू से ही अपने training data के बाहर कमज़ोर चलता है।