Voce del glossario · · 5 min di lettura
Overfitting
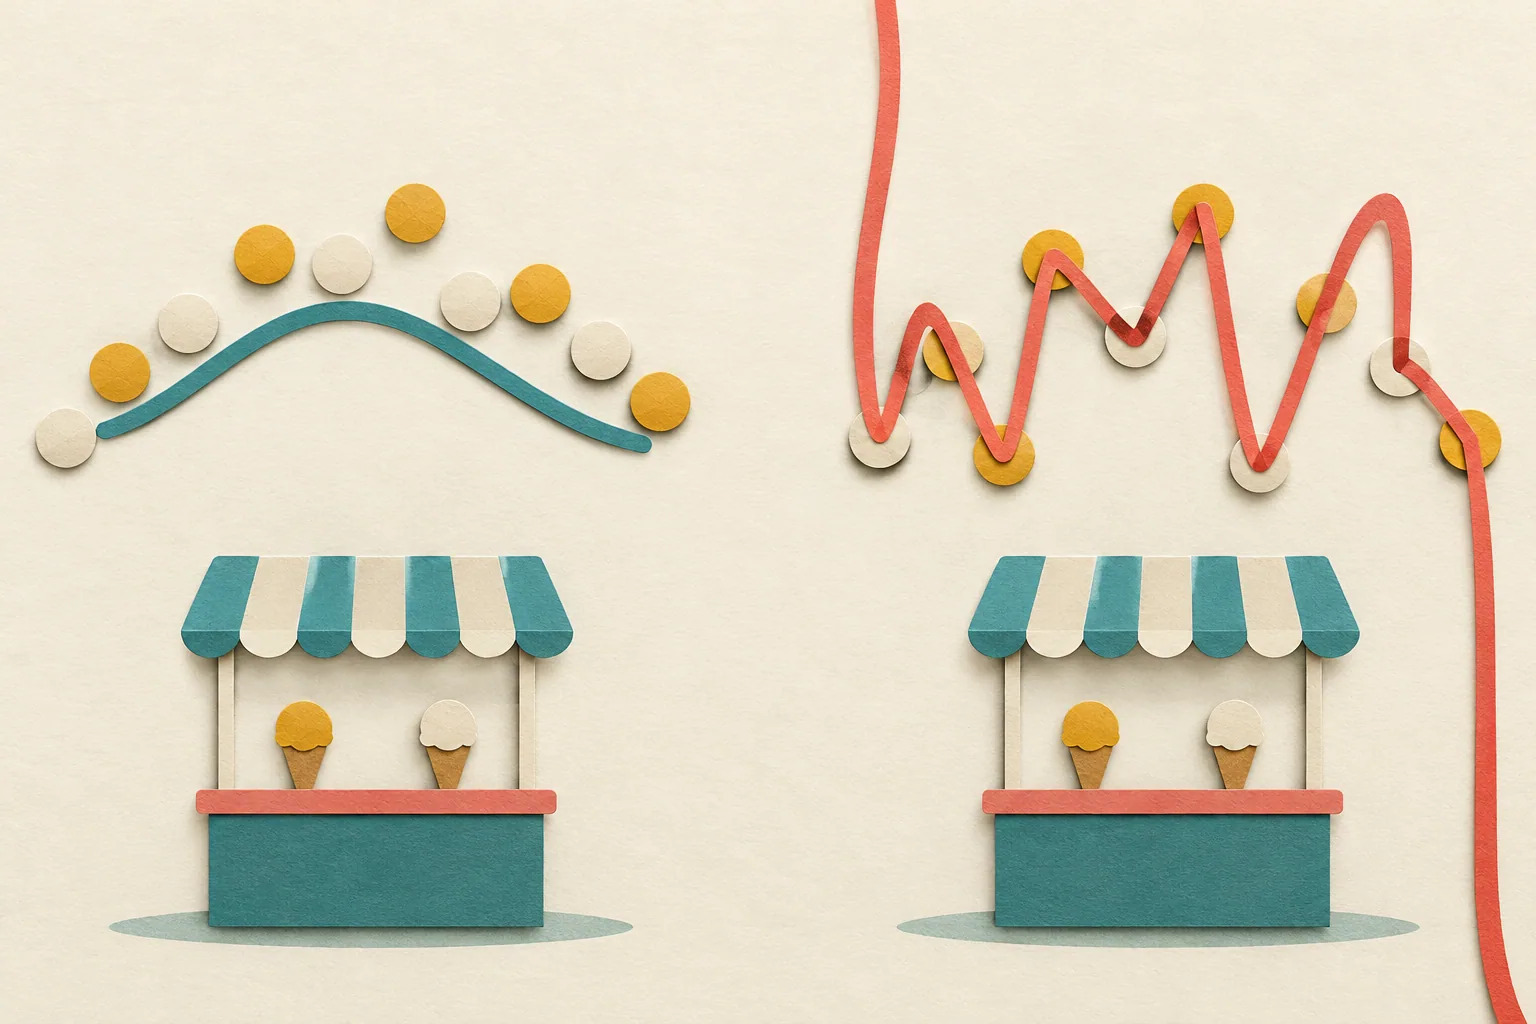
Gestisci un chiosco dei gelati. Per 10 giorni hai annotato su un quaderno la temperatura a mezzogiorno e il numero di palline vendute. Da questi appunti vuoi ricavare una regola: domani sono previsti 24°C, quanto gelato preparare?
La regola più semplice è una retta: «ogni grado in più vuol dire qualche pallina in più». Nell'esempio di questa nota, sui giorni annotati sbaglia tipicamente di 27,5 palline, perché non vede che nel caldo più intenso le vendite calano. Si può allora dare alla regola più libertà e permettere alla curva di piegarsi. La più flessibile delle curve provate passa esattamente per tutti e 10 i punti. Il suo errore sui giorni del quaderno è 0.
Sembra la regola perfetta. Solo che i giorni del quaderno sono già passati, e la regola deve funzionare domani. Su 400 nuovi giorni dello stesso chiosco la curva «perfetta» sbaglia tipicamente di 236,5 palline. Una curva moderatamente flessibile, che sul quaderno andava peggio (10,9), sui nuovi giorni sbaglia di 16,8.
L'overfitting è la situazione in cui un modello ha un errore piccolo sui dati usati per l'addestramento e, al confronto, un errore troppo grande su dati nuovi dello stesso tipo (Goodfellow, Bengio e Courville, Deep Learning, §5.2). Il modello si è adattato a caratteristiche del proprio insieme di dati che al di fuori di esso non si ripetono. Il problema opposto si chiama underfitting: la regola è troppo semplice per descrivere bene perfino i dati che ha visto. Così si comporta la retta del nostro esempio.
Da dove nasce questa differenza
Ogni annotazione del quaderno è fatta di due cose: una regolarità (fa più caldo, quindi più gelati) e il caso (proprio quel giorno è arrivata una gita). La regola deve cogliere la prima e tralasciare il secondo. Il modello però non sa che cosa sia l'una e che cosa l'altro. Vede soltanto dei punti.
Quanto caso il modello assorbirà dipende dalla sua flessibilità, che in letteratura si chiama capacity: la capacità di adattarsi a molte forme diverse. La curva dell'esempio è descritta da 2 a 10 numeri, che si scelgono in base ai dati; il loro numero è il grado della curva più uno. Una curva di grado 9 ha 10 di questi numeri per 10 giorni, quindi riesce a centrare ogni punto, con tutto il caso che contiene. Gli autori del manuale lo descrivono così: un modello molto flessibile può rappresentare la relazione giusta, ma anche una quantità di altre che si adattano altrettanto bene ai dati di addestramento, ed è poco probabile che scelga proprio quella che reggerà in seguito (§5.2).
L'andamento tipico è questo: al crescere della flessibilità l'errore sui dati di addestramento diminuisce, mentre l'errore sui dati nuovi prima diminuisce e poi comincia a crescere (§5.2, figura 5.3). Ne segue una regola pratica. Un modello non si valuta sui dati su cui è stato addestrato, e la flessibilità non si sceglie in base all'errore su quei dati, perché questo indicherà sempre la più alta. Una parte dei dati si mette da parte: il validation set [Polski] serve a scegliere le impostazioni e un test set separato alla valutazione finale (§5.3).
Prova tu stesso
Qui sotto c'è lo stesso chiosco. Tutti i numeri di questa nota si possono riprodurre: dopo aver cliccato «Ricomincia» si vedono 10 giorni, e gli esperimenti 1–5 impostano i casi descritti.
Vale la pena fare due cose che un grafico statico non mostra. Primo, attiva «Altri 24 quaderni» e varia il grado: con un grado basso le linee grigie restano vicine tra loro, con uno alto si disperdono in tutte le direzioni, anche se ognuna proviene dallo stesso chiosco. Secondo, trascina un punto molto in alto. La curva di grado 2 si sposterà solo di poco, mentre la curva di grado 9 si ricostruirà per tutta la sua lunghezza pur di centrarlo.
Che cosa aiuta
- Più dati. Con 80 giorni la stessa curva di grado 9 sbaglia tipicamente di 14,8 palline sul quaderno e di 15,9 sui nuovi giorni. La differenza quasi scompare, perché la curva non può più centrare ogni punto (§5.2).
- Meno flessibilità. Una curva di grado 3 su 10 giorni: 10,9 sul quaderno, 16,8 sui nuovi giorni.
- Regularization, cioè una modifica del modo di addestrare che mira a ridurre l'errore sui dati nuovi e non su quelli di addestramento (§5.2.2). Un esempio è la penalità per i coefficienti grandi, imparentata con il Weight decay [Polski]: la curva di grado 9 con penalità λ = 0,01 sbaglia di 5,8 sul quaderno e di 21,2 sui nuovi giorni, invece che di 236,5.
Nessuna di queste impostazioni si può scegliere guardando soltanto l'errore sui dati di addestramento.
Limiti
- È un esempio mio, con una sola grandezza in ingresso e dati simulati. Qui il solo caso produce tipicamente 15 palline di errore, e sui nuovi giorni nessuna regola scenderà più in basso.
- La forma «prima meglio, poi peggio» è tipica, non garantita. Gli autori osservano che nelle reti profonde è difficile perfino stabilire la flessibilità effettiva di un modello, perché dipende anche dall'algoritmo di addestramento (§5.2). Il numero di parametri di un LLM non dice quindi, da solo, se il modello è in overfitting.
- Un errore piccolo sui dati nuovi riguarda dati della stessa provenienza. Se il chiosco si trasferisce al mare, il quaderno della città non promette nulla.
Collegamenti
- Weight decay [Polski] limita la grandezza dei pesi ed è uno dei modi per ridurre la differenza tra l'errore sui dati di addestramento e quello sui dati nuovi.
- Grokking [Polski] descrive i casi in cui un modello che sembra in overfitting, dopo un lungo addestramento ulteriore, comincia a funzionare bene sui dati nuovi.
- Fine-tuning [Polski] su un insieme piccolo richiede lo stesso controllo: dati separati, che il modello non ha visto durante l'addestramento.
- Catastrophic Forgetting [Polski] è un problema diverso: lì il modello perde una vecchia capacità dopo un nuovo addestramento, qui fin dall'inizio si trasferisce male al di fuori dei propri dati di addestramento.