Overfitting
У тебя киоск с мороженым. 10 дней ты записывал в тетрадь температуру в полдень и число проданных шариков. Из этих записей ты хочешь вывести правило: завтра обещают 24°C, сколько мороженого приготовить?
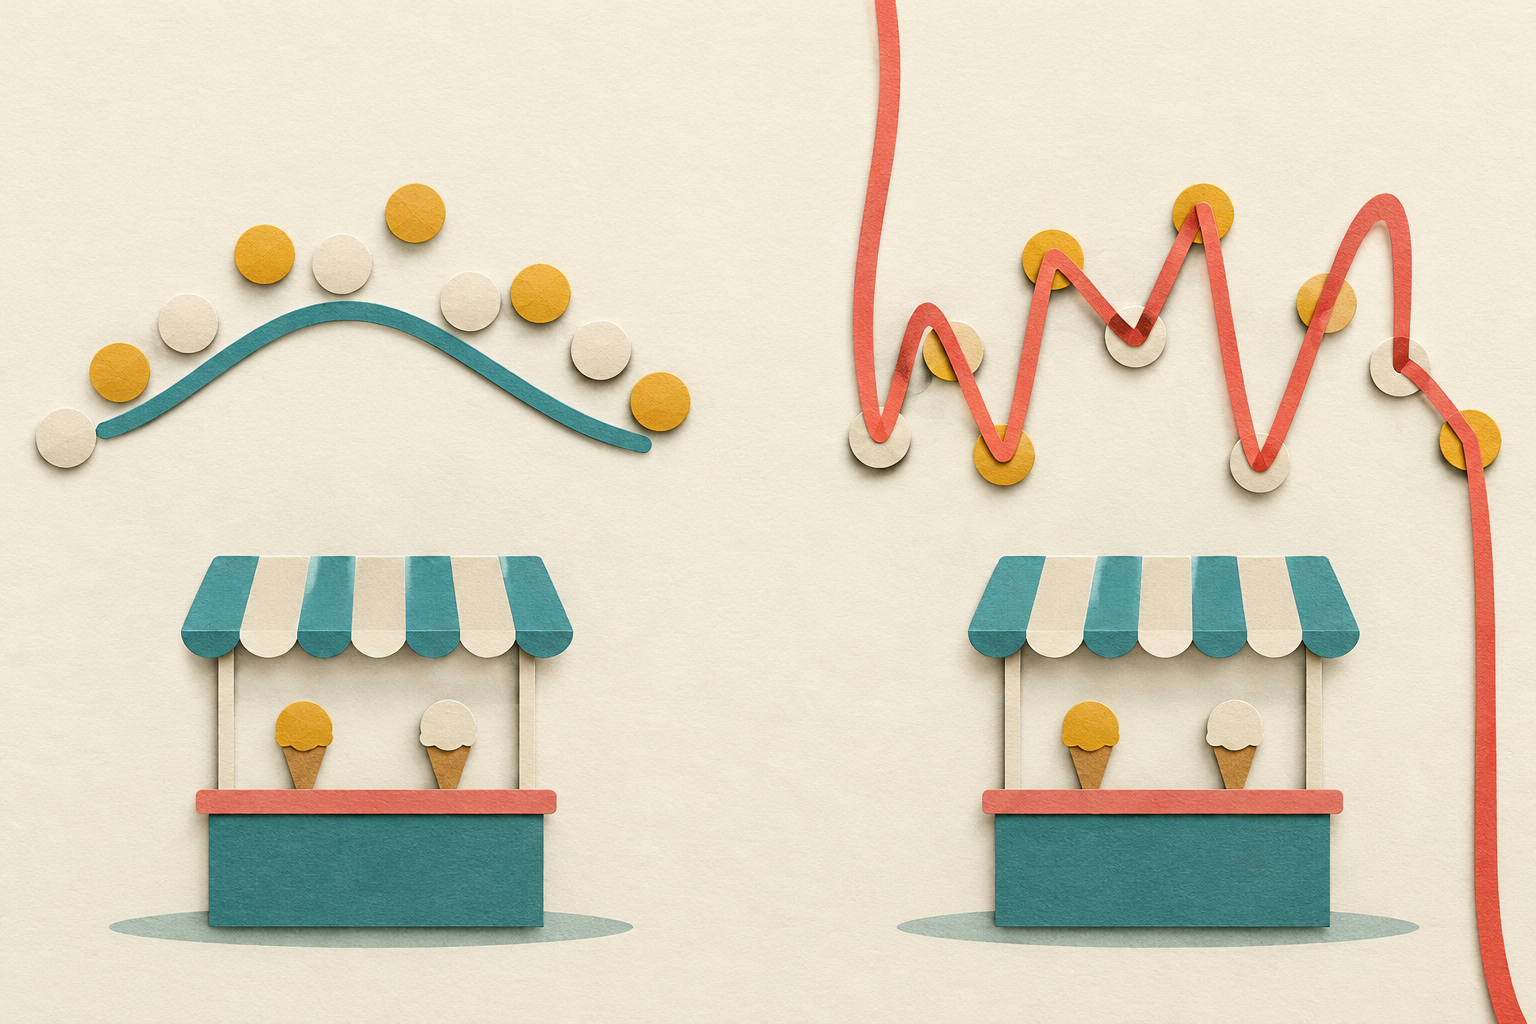
Самое простое правило — прямая линия: «каждый лишний градус — это несколько лишних шариков». В примере из этой заметки она ошибается на записанных днях обычно на 27,5 шарика, потому что не видит, что в самую сильную жару продажи падают. Значит, можно дать правилу больше свободы и позволить кривой изгибаться. Самая гибкая из опробованных кривых проходит точно через все 10 точек. Её ошибка на днях из тетради равна 0.
Выглядит это как идеальное правило. Только вот дни из тетради уже прошли, а правило должно работать завтра. На 400 новых днях из того же киоска «идеальная» кривая ошибается обычно на 236,5 шарика. Умеренно гибкая кривая, которая на тетради выглядела хуже (10,9), на новых днях ошибается на 16,8.
Overfitting — это ситуация, когда у модели маленькая ошибка на данных, использованных для обучения, а ошибка на новых данных того же рода слишком велика по сравнению с ней (Goodfellow, Bengio и Courville, Deep Learning, §5.2). Модель подстроилась под особенности своего набора, которые за его пределами не повторяются. Обратная беда называется underfitting: правило слишком простое, чтобы хорошо описать даже те данные, которые оно видело. Так ведёт себя прямая линия из нашего примера.
Откуда берётся эта разница
Каждая запись в тетради состоит из двух вещей: закономерности (теплее — значит, больше мороженого) и случайности (как раз приехала экскурсия). Правило должно уловить первую и пропустить вторую. Но модель не знает, что есть что. Она видит только точки.
Сколько случайности модель впитает, зависит от её гибкости, которую в литературе называют capacity: способности подстроиться под множество разных форм. Кривую в примере описывают от 2 до 10 чисел, которые подбираются под данные; их количество — это степень кривой плюс один. У кривой степени 9 таких чисел 10 на 10 дней, поэтому она может попасть в каждую точку, вместе со всей случайностью. Авторы учебника описывают это так: очень гибкая модель может представить правильную зависимость, но также и множество других, столь же хорошо подходящих к обучающим данным, и мала вероятность, что она выберет именно ту, которая оправдает себя дальше (§5.2).
Типичный ход событий такой: когда гибкость растёт, ошибка на обучающих данных уменьшается, а ошибка на новых данных сначала уменьшается, потом начинает расти (§5.2, рисунок 5.3). Отсюда следует практическое правило. Модель не оценивают на данных, на которых она училась, а гибкость не подбирают по ошибке на этих данных, потому что та всегда укажет на наибольшую. Часть данных откладывают в сторону: validation set служит для выбора настроек, а отдельный test set — для итоговой оценки (§5.3).
Проверь сам
Ниже — тот же киоск. Все числа из этой заметки можно воспроизвести: после нажатия «Сначала» видно 10 дней, а эксперименты 1–5 задают описанные случаи.
Стоит сделать две вещи, которых не показывает статичный график. Во-первых, включи «24 другие тетради» и меняй степень: при низкой серые линии держатся близко друг к другу, при высокой расходятся во все стороны, хотя каждая получена из того же киоска. Во-вторых, перетащи одну точку высоко вверх. Кривая степени 2 сдвинется лишь немного, а кривая степени 9 перестроится по всей длине, чтобы в неё попасть.
Что помогает
- Больше данных. При 80 днях та же кривая степени 9 ошибается обычно на 14,8 шарика на тетради и на 15,9 на новых днях. Разница почти исчезает, потому что кривая уже не может попасть в каждую точку (§5.2).
- Меньшая гибкость. Кривая степени 3 на 10 днях: 10,9 на тетради, 16,8 на новых днях.
- Regularization, то есть изменение способа обучения, которое должно уменьшить ошибку на новых данных, а не на обучающих (§5.2.2). Пример — штраф за большие коэффициенты, родственный Weight decay [Polski]: кривая степени 9 со штрафом λ = 0,01 ошибается на 5,8 на тетради и на 21,2 на новых днях, а не на 236,5.
Ни одну из этих настроек нельзя выбрать, глядя только на ошибку на обучающих данных.
Ограничения
- Это собственный пример с одной входной величиной и смоделированными данными. Сама случайность даёт здесь обычно 15 шариков ошибки, и ни одно правило не опустится ниже на новых днях.
- Форма «сначала лучше, потом хуже» типична, но не гарантирована. Авторы отмечают, что в глубоких сетях трудно даже установить фактическую гибкость модели, потому что она зависит ещё и от алгоритма обучения (§5.2). Поэтому число параметров LLM само по себе не говорит, переобучена ли модель.
- Маленькая ошибка на новых данных относится к данным из того же источника. Если киоск переедет к морю, городская тетрадь ничего не обещает.
Связанные заметки
- Weight decay [Polski] ограничивает величину весов и является одним из способов уменьшить разницу между ошибкой на обучающих и на новых данных.
- Grokking [Polski] описывает случаи, когда модель, выглядящая переобученной, после долгого дальнейшего обучения начинает хорошо работать на новых данных.
- Fine-tuning [Polski] на маленьком наборе требует того же контроля: отдельных данных, которых модель не видела при обучении.
- Catastrophic Forgetting [Polski] — другая проблема: там модель теряет прежнее умение после нового обучения, а здесь с самого начала плохо переносится за пределы собственных обучающих данных.