Overfitting
Prowadzisz budkę z lodami. Przez 10 dni zapisywałeś w zeszycie temperaturę w południe i liczbę sprzedanych gałek. Chcesz zrobić z tych notatek regułę: jutro ma być 24°C, ile lodów przygotować?
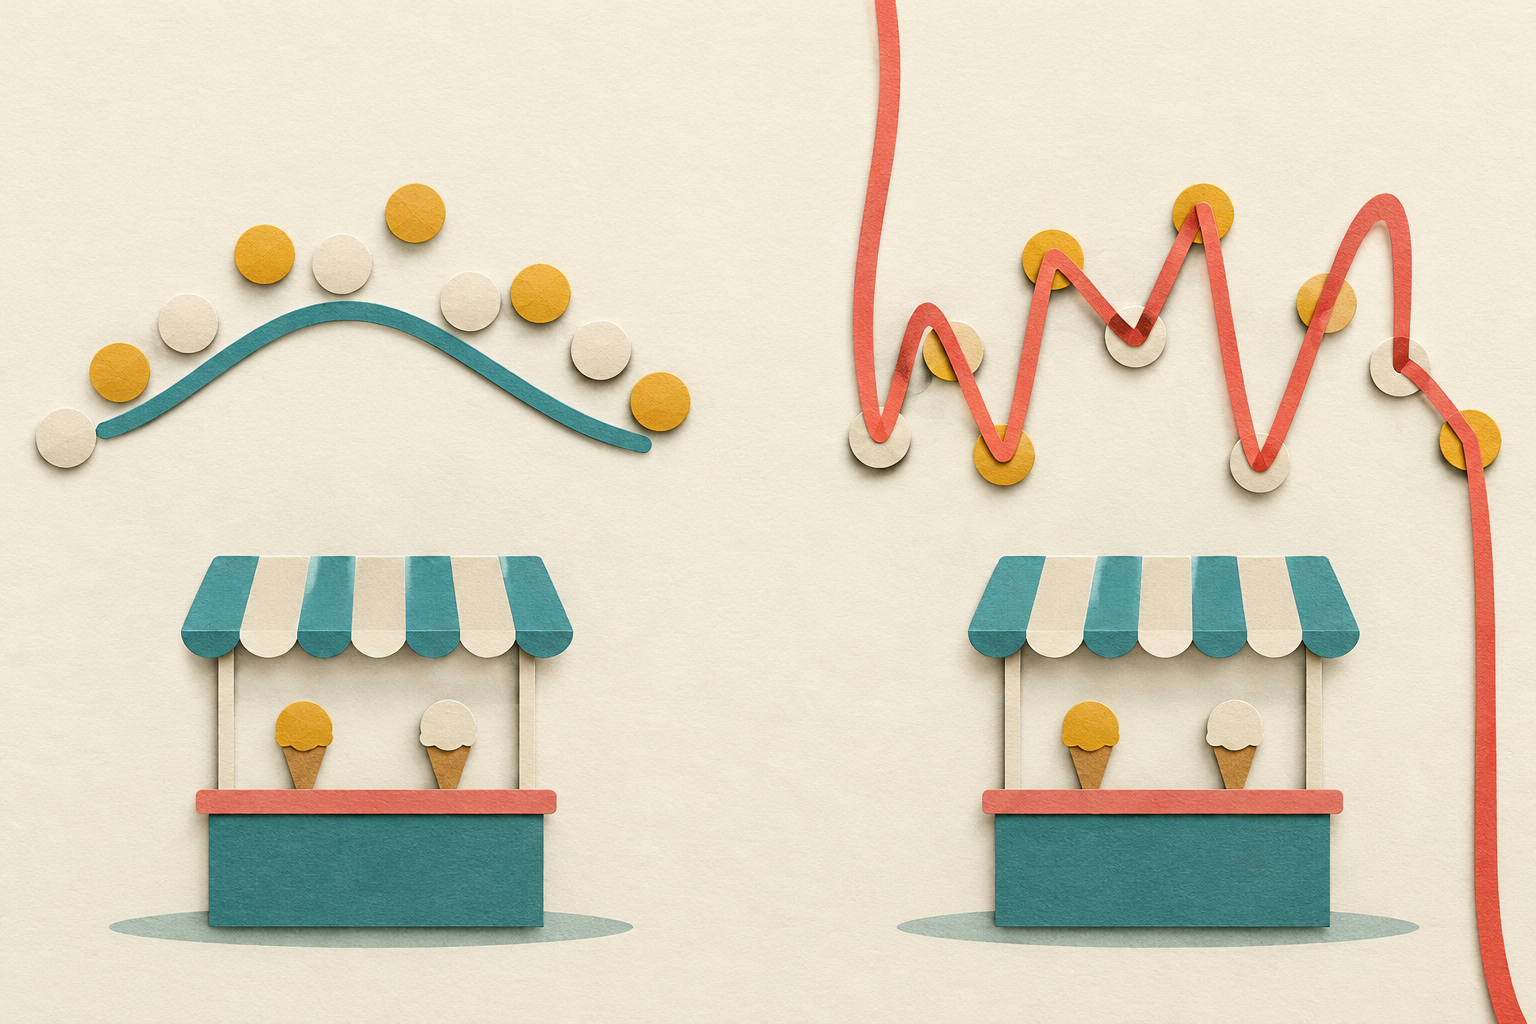
Najprostsza reguła to prosta linia: „każdy stopień więcej to kilka gałek więcej”. W przykładzie z tej notatki myli się ona na zapisanych dniach typowo o 27,5 gałki, bo nie widzi, że w największy upał sprzedaż spada. Można więc dać regule więcej swobody i pozwolić krzywej zakręcać. Najbardziej giętka z wypróbowanych krzywych przechodzi dokładnie przez wszystkie 10 punktów. Jej błąd na dniach z zeszytu wynosi 0.
Wygląda to na regułę idealną. Tyle że dni z zeszytu już minęły, a reguła ma działać jutro. Na 400 nowych dniach z tej samej budki „idealna” krzywa myli się typowo o 236,5 gałki. Umiarkowanie giętka krzywa, która na zeszycie wypadała gorzej (10,9), na nowych dniach myli się o 16,8.
Overfitting to sytuacja, w której model ma mały błąd na danych użytych do nauki, a zbyt duży w porównaniu z nim błąd na nowych danych tego samego rodzaju (Goodfellow, Bengio i Courville, Deep Learning, §5.2). Model dopasował się do cech swojego zbioru, które poza nim się nie powtarzają. Odwrotny kłopot nazywa się underfitting: reguła jest za prosta, żeby dobrze opisać nawet dane, które widziała. Tak zachowuje się prosta linia z naszego przykładu.
Skąd bierze się ta różnica
Każdy zapis w zeszycie składa się z dwóch rzeczy: prawidłowości (cieplej, więc więcej lodów) i przypadku (akurat przyjechała wycieczka). Reguła ma uchwycić pierwszą, a drugą pominąć. Model nie wie jednak, co jest czym. Widzi tylko punkty.
O tym, ile przypadku model wchłonie, decyduje jego giętkość, w literaturze nazywana capacity: zdolność dopasowania się do wielu różnych kształtów. Krzywą w przykładzie opisuje od 2 do 10 liczb, które dobiera się do danych; ich liczba to stopień krzywej plus jeden. Krzywa stopnia 9 ma 10 takich liczb na 10 dni, więc potrafi trafić w każdy punkt, razem z całym przypadkiem. Autorzy podręcznika opisują to tak: bardzo giętki model może przedstawić właściwą zależność, ale także mnóstwo innych, równie dobrze pasujących do danych uczących, i mała jest szansa, że wybierze akurat tę, która sprawdzi się dalej (§5.2).
Typowy przebieg jest następujący: gdy giętkość rośnie, błąd na danych uczących maleje, a błąd na nowych danych najpierw maleje, potem zaczyna rosnąć (§5.2, rysunek 5.3). Wynika z tego praktyczna zasada. Modelu nie ocenia się na danych, na których się uczył, a giętkości nie dobiera się według błędu na tych danych, bo ten zawsze wskaże największą. Część danych odkłada się na bok: validation set służy do wyboru ustawień, a osobny test set do końcowej oceny (§5.3).
Sprawdź sam
Poniżej jest ta sama budka. Wszystkie liczby z tej notatki można odtworzyć: po kliknięciu „Od początku” widać 10 dni, a eksperymenty 1–5 ustawiają opisane przypadki.
Warto zrobić dwie rzeczy, których nie pokazuje statyczny wykres. Po pierwsze, włącz „24 inne zeszyty” i zmieniaj stopień: przy niskim szare linie trzymają się blisko siebie, przy wysokim rozchodzą się na wszystkie strony, choć każda pochodzi z tej samej budki. Po drugie, przeciągnij jeden punkt wysoko w górę. Krzywa stopnia 2 przesunie się tylko trochę, a krzywa stopnia 9 przebuduje się na całej długości, żeby w niego trafić.
Co pomaga
- Więcej danych. Przy 80 dniach ta sama krzywa stopnia 9 myli się typowo o 14,8 gałki na zeszycie i o 15,9 na nowych dniach. Różnica prawie znika, bo krzywa nie może już trafić w każdy punkt (§5.2).
- Mniejsza giętkość. Krzywa stopnia 3 na 10 dniach: 10,9 na zeszycie, 16,8 na nowych dniach.
- Regularization, czyli zmiana sposobu uczenia, która ma zmniejszyć błąd na nowych danych, a nie na uczących (§5.2.2). Przykładem jest kara za duże współczynniki, spokrewniona z Weight decay: krzywa stopnia 9 z karą λ = 0,01 myli się o 5,8 na zeszycie i o 21,2 na nowych dniach, zamiast o 236,5.
Żadnego z tych ustawień nie da się wybrać, patrząc tylko na błąd na danych uczących.
Ograniczenia
- To własny przykład z jedną wielkością wejściową i symulowanymi danymi. Sam przypadek daje tu typowo 15 gałek błędu i żadna reguła nie zejdzie niżej na nowych dniach.
- Kształt „najpierw lepiej, potem gorzej” jest typowy, a nie gwarantowany. Autorzy zaznaczają, że w głębokich sieciach trudno nawet ustalić faktyczną giętkość modelu, bo zależy ona też od algorytmu uczenia (§5.2). Liczba parametrów LLM nie mówi więc sama, czy model jest przeuczony.
- Mały błąd na nowych danych dotyczy danych z tego samego źródła. Jeśli budka przeniesie się nad morze, zeszyt z miasta niczego nie obiecuje.
Powiązania
- Weight decay ogranicza wielkość wag i jest jednym ze sposobów na zmniejszenie różnicy między błędem na danych uczących i nowych.
- Grokking opisuje przypadki, w których model wyglądający na przeuczony po długim dalszym treningu zaczyna dobrze działać na nowych danych.
- Fine-tuning na małym zbiorze wymaga tej samej kontroli: osobnych danych, których model nie widział podczas nauki.
- Catastrophic Forgetting to inny problem: tam model traci dawną umiejętność po nowej nauce, a tu od początku słabo przenosi się poza własne dane uczące.