Overfitting
Du betreibst einen Eisstand. 10 Tage lang hast du in einem Heft die Temperatur am Mittag und die Zahl der verkauften Kugeln notiert. Aus diesen Notizen möchtest du eine Regel machen: Morgen sollen es 24°C werden, wie viel Eis solltest du vorbereiten?
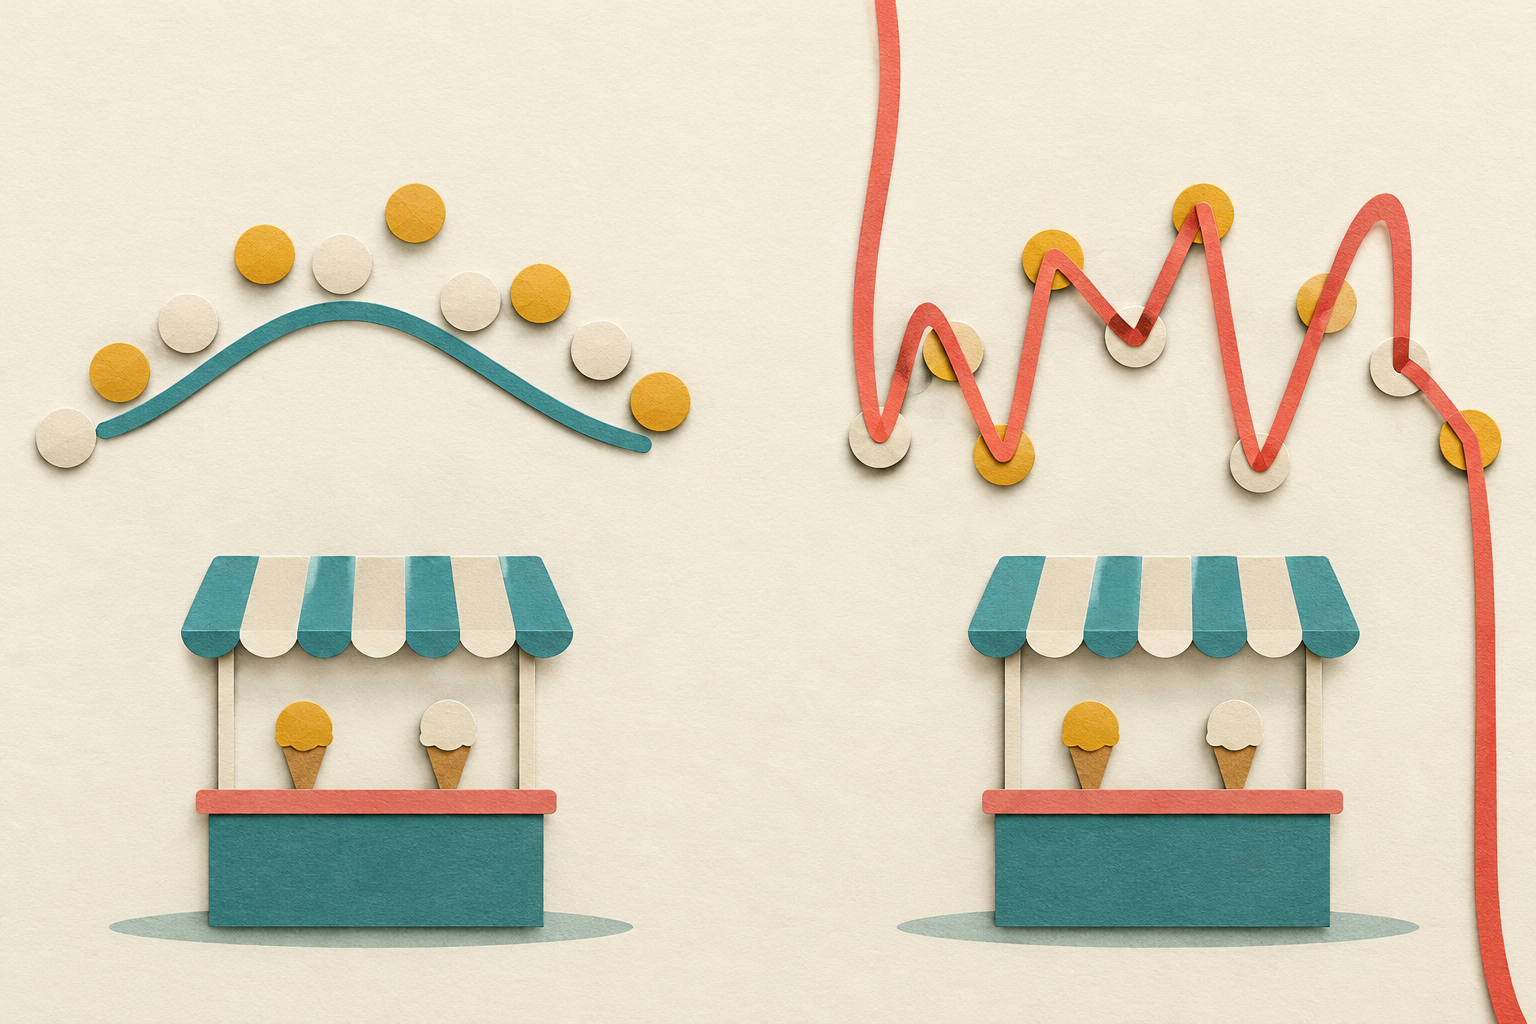
Die einfachste Regel ist eine gerade Linie: „Jedes Grad mehr bedeutet ein paar Kugeln mehr“. Im Beispiel aus dieser Notiz liegt sie an den notierten Tagen typischerweise um 27,5 Kugeln daneben, weil sie nicht sieht, dass der Verkauf bei der größten Hitze zurückgeht. Man kann der Regel also mehr Freiheit geben und der Kurve erlauben, sich zu biegen. Die flexibelste der ausprobierten Kurven geht genau durch alle 10 Punkte. Ihr Fehler an den Tagen aus dem Heft beträgt 0.
Das sieht nach einer perfekten Regel aus. Nur sind die Tage aus dem Heft schon vorbei, und die Regel soll morgen funktionieren. An 400 neuen Tagen desselben Eisstands liegt die „perfekte“ Kurve typischerweise um 236,5 Kugeln daneben. Eine mäßig flexible Kurve, die im Heft schlechter abschnitt (10,9), liegt an neuen Tagen um 16,8 daneben.
Overfitting ist die Situation, in der ein Modell einen kleinen Fehler auf den Daten hat, mit denen es gelernt hat, und einen im Vergleich dazu zu großen Fehler auf neuen Daten derselben Art (Goodfellow, Bengio und Courville, Deep Learning, §5.2). Das Modell hat sich an Eigenschaften seines Datensatzes angepasst, die sich außerhalb davon nicht wiederholen. Das umgekehrte Problem heißt underfitting: Die Regel ist zu einfach, um auch nur die Daten gut zu beschreiben, die sie gesehen hat. So verhält sich die gerade Linie aus unserem Beispiel.
Woher dieser Unterschied kommt
Jeder Eintrag im Heft besteht aus zwei Dingen: aus einer Regelmäßigkeit (wärmer, also mehr Eis) und aus Zufall (gerade ist eine Reisegruppe angekommen). Die Regel soll das Erste erfassen und das Zweite weglassen. Das Modell weiß aber nicht, was was ist. Es sieht nur Punkte.
Wie viel Zufall das Modell aufnimmt, entscheidet seine Flexibilität, in der Fachliteratur capacity genannt: die Fähigkeit, sich an viele verschiedene Formen anzupassen. Die Kurve im Beispiel wird durch 2 bis 10 Zahlen beschrieben, die an die Daten angepasst werden; ihre Anzahl ist der Grad der Kurve plus eins. Eine Kurve vom Grad 9 hat 10 solche Zahlen für 10 Tage, sie kann also jeden Punkt treffen, mitsamt dem ganzen Zufall. Die Autoren des Lehrbuchs beschreiben es so: Ein sehr flexibles Modell kann den richtigen Zusammenhang darstellen, aber auch eine Menge anderer, die genauso gut zu den Trainingsdaten passen, und die Chance ist klein, dass es gerade den auswählt, der sich später bewährt (§5.2).
Der typische Verlauf ist folgender: Wenn die Flexibilität wächst, sinkt der Fehler auf den Trainingsdaten, und der Fehler auf neuen Daten sinkt zuerst und beginnt dann zu steigen (§5.2, Abbildung 5.3). Daraus folgt eine praktische Regel. Ein Modell bewertet man nicht auf den Daten, mit denen es gelernt hat, und die Flexibilität wählt man nicht nach dem Fehler auf diesen Daten, denn der zeigt immer auf die größte. Einen Teil der Daten legt man beiseite: Das validation set dient zur Wahl der Einstellungen und ein eigenes test set zur abschließenden Bewertung (§5.3).
Probier es selbst aus
Unten ist derselbe Eisstand. Alle Zahlen aus dieser Notiz lassen sich nachstellen: Nach einem Klick auf „Von vorn“ siehst du 10 Tage, und die Experimente 1–5 stellen die beschriebenen Fälle ein.
Es lohnt sich, zwei Dinge zu tun, die ein statisches Diagramm nicht zeigt. Erstens: Schalte „24 andere Hefte“ ein und ändere den Grad: Bei einem niedrigen bleiben die grauen Linien nah beieinander, bei einem hohen laufen sie in alle Richtungen auseinander, obwohl jede vom selben Eisstand stammt. Zweitens: Zieh einen Punkt weit nach oben. Die Kurve vom Grad 2 verschiebt sich nur ein wenig, die Kurve vom Grad 9 baut sich dagegen auf ganzer Länge um, um ihn zu treffen.
Was hilft
- Mehr Daten. Bei 80 Tagen liegt dieselbe Kurve vom Grad 9 typischerweise um 14,8 Kugeln im Heft und um 15,9 an neuen Tagen daneben. Der Unterschied verschwindet fast, weil die Kurve nicht mehr jeden Punkt treffen kann (§5.2).
- Weniger Flexibilität. Kurve vom Grad 3 bei 10 Tagen: 10,9 im Heft, 16,8 an neuen Tagen.
- Regularization, also eine Änderung der Lernweise, die den Fehler auf neuen Daten verringern soll und nicht den auf den Trainingsdaten (§5.2.2). Ein Beispiel ist eine Strafe für große Koeffizienten, verwandt mit Weight decay: Die Kurve vom Grad 9 mit der Strafe λ = 0,01 liegt um 5,8 im Heft und um 21,2 an neuen Tagen daneben, statt um 236,5.
Keine dieser Einstellungen lässt sich wählen, wenn man nur auf den Fehler auf den Trainingsdaten schaut.
Einschränkungen
- Das ist ein eigenes Beispiel mit einer einzigen Eingangsgröße und simulierten Daten. Der Zufall allein ergibt hier typischerweise 15 Kugeln Fehler, und keine Regel kommt an neuen Tagen darunter.
- Die Form „erst besser, dann schlechter“ ist typisch, aber nicht garantiert. Die Autoren merken an, dass es bei tiefen Netzen schwer ist, die tatsächliche Flexibilität eines Modells überhaupt zu bestimmen, weil sie auch vom Lernalgorithmus abhängt (§5.2). Die Zahl der Parameter eines LLM sagt also für sich allein nicht, ob das Modell überangepasst ist.
- Ein kleiner Fehler auf neuen Daten gilt für Daten aus derselben Quelle. Wenn der Eisstand ans Meer umzieht, verspricht das Heft aus der Stadt nichts.
Verbindungen
- Weight decay begrenzt die Größe der Gewichte und ist eine der Möglichkeiten, den Unterschied zwischen dem Fehler auf Trainingsdaten und auf neuen Daten zu verringern.
- Grokking beschreibt Fälle, in denen ein Modell, das überangepasst wirkt, nach langem weiterem Training anfängt, auf neuen Daten gut zu funktionieren.
- Fine-tuning auf einem kleinen Datensatz verlangt dieselbe Kontrolle: eigene Daten, die das Modell beim Lernen nicht gesehen hat.
- Catastrophic Forgetting [Polski] ist ein anderes Problem: Dort verliert das Modell eine alte Fähigkeit nach neuem Lernen, hier überträgt es sich von Anfang an schlecht über die eigenen Trainingsdaten hinaus.