Overfitting
Tienes un puesto de helados. Durante 10 días has apuntado en un cuaderno la temperatura a mediodía y el número de bolas vendidas. Quieres sacar de esas notas una regla: mañana habrá 24°C, ¿cuánto helado hay que preparar?
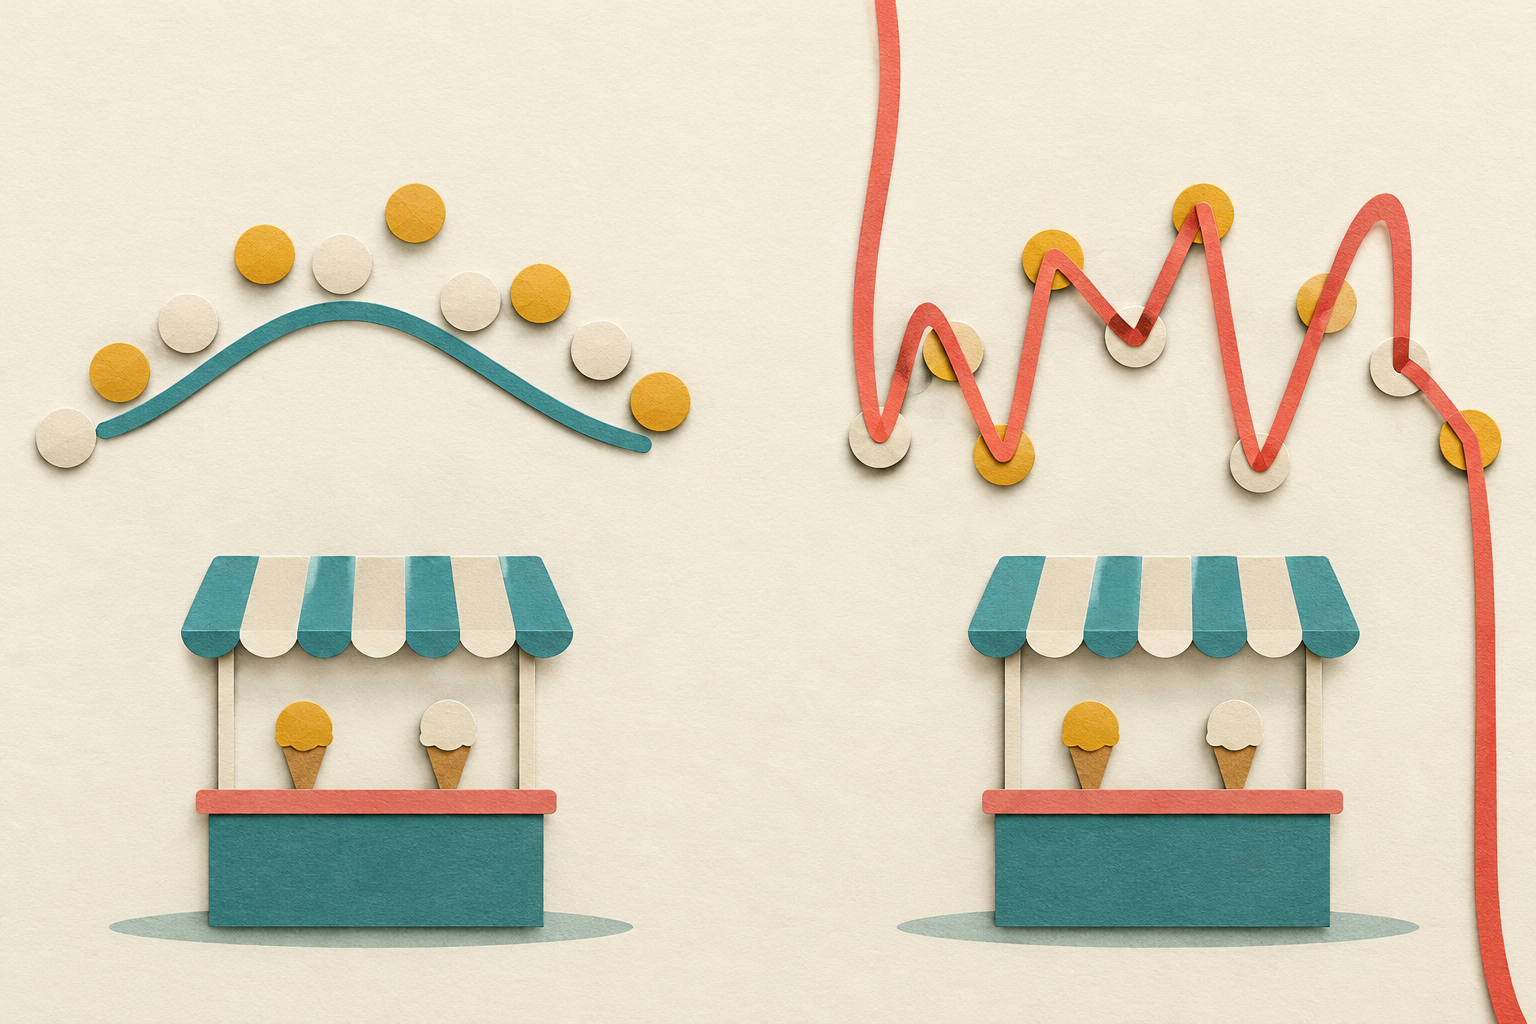
La regla más sencilla es una línea recta: «cada grado más son unas cuantas bolas más». En el ejemplo de esta nota, en los días apuntados suele equivocarse en 27,5 bolas, porque no ve que con el calor más fuerte las ventas bajan. Así que se le puede dar más libertad a la regla y dejar que la curva haga giros. La más flexible de las curvas probadas pasa exactamente por los 10 puntos. Su error en los días del cuaderno es 0.
Parece la regla perfecta. Solo que los días del cuaderno ya han pasado y la regla tiene que funcionar mañana. En 400 días nuevos del mismo puesto, la curva «perfecta» suele equivocarse en 236,5 bolas. Una curva moderadamente flexible, que en el cuaderno salía peor (10,9), en los días nuevos se equivoca en 16,8.
Overfitting es la situación en la que un modelo tiene un error pequeño en los datos usados para aprender y, en comparación con él, un error demasiado grande en datos nuevos del mismo tipo (Goodfellow, Bengio y Courville, Deep Learning, §5.2). El modelo se ha ajustado a rasgos de su conjunto de datos que fuera de él no se repiten. El problema contrario se llama underfitting: la regla es demasiado simple para describir bien incluso los datos que ha visto. Así se comporta la línea recta de nuestro ejemplo.
De dónde sale esa diferencia
Cada apunte del cuaderno se compone de dos cosas: una regularidad (hace más calor, así que se vende más helado) y el azar (justo ese día llegó una excursión). La regla tiene que captar la primera y dejar fuera la segunda. Pero el modelo no sabe qué es cada cosa. Solo ve puntos.
Cuánto azar absorbe el modelo depende de su flexibilidad, que en la literatura se llama capacity: la capacidad de ajustarse a muchas formas distintas. La curva del ejemplo se describe con entre 2 y 10 números que se eligen según los datos; su cantidad es el grado de la curva más uno. Una curva de grado 9 tiene 10 de esos números para 10 días, así que puede acertar en cada punto, con todo su azar incluido. Los autores del manual lo describen así: un modelo muy flexible puede representar la relación correcta, pero también muchísimas otras que encajan igual de bien con los datos de entrenamiento, y es poco probable que elija justo la que seguirá funcionando después (§5.2).
El recorrido típico es el siguiente: cuando la flexibilidad aumenta, el error en los datos de entrenamiento disminuye, y el error en datos nuevos primero disminuye y luego empieza a crecer (§5.2, figura 5.3). De ahí sale una norma práctica. Un modelo no se evalúa con los datos con los que aprendió, y la flexibilidad no se elige según el error en esos datos, porque ese error siempre señalará la mayor. Una parte de los datos se aparta: el validation set sirve para elegir los ajustes y un test set separado, para la evaluación final (§5.3).
Compruébalo tú mismo
Aquí abajo está el mismo puesto. Todos los números de esta nota se pueden reproducir: al pulsar «Desde el principio» se ven 10 días, y los experimentos 1–5 preparan los casos descritos.
Vale la pena hacer dos cosas que un gráfico estático no muestra. Primero, activa «Otros 24 cuadernos» y cambia el grado: con uno bajo, las líneas grises se mantienen cerca unas de otras; con uno alto, se separan en todas direcciones, aunque todas vienen del mismo puesto. Segundo, arrastra un punto muy hacia arriba. La curva de grado 2 se moverá solo un poco, y la de grado 9 se reconstruirá en toda su longitud para acertar en él.
Qué ayuda
- Más datos. Con 80 días, la misma curva de grado 9 suele equivocarse en 14,8 bolas en el cuaderno y en 15,9 en los días nuevos. La diferencia casi desaparece, porque la curva ya no puede acertar en cada punto (§5.2).
- Menos flexibilidad. Curva de grado 3 con 10 días: 10,9 en el cuaderno, 16,8 en los días nuevos.
- Regularization, es decir, un cambio en la forma de aprender que busca reducir el error en los datos nuevos y no en los de entrenamiento (§5.2.2). Un ejemplo es la penalización por coeficientes grandes, emparentada con Weight decay: la curva de grado 9 con penalización λ = 0,01 se equivoca en 5,8 en el cuaderno y en 21,2 en los días nuevos, en lugar de en 236,5.
Ninguno de estos ajustes se puede elegir mirando solo el error en los datos de entrenamiento.
Limitaciones
- Es un ejemplo propio, con una sola magnitud de entrada y datos simulados. El azar por sí solo da aquí un error típico de 15 bolas, y ninguna regla bajará de ahí en los días nuevos.
- La forma «primero mejor, luego peor» es típica, no está garantizada. Los autores señalan que en las redes profundas es difícil incluso determinar la flexibilidad real del modelo, porque depende también del algoritmo de aprendizaje (§5.2). Por eso el número de parámetros de un LLM no dice por sí solo si el modelo está sobreajustado.
- Un error pequeño en datos nuevos se refiere a datos de la misma fuente. Si el puesto se traslada a la orilla del mar, el cuaderno de la ciudad no promete nada.
Relaciones
- Weight decay limita el tamaño de los pesos y es una de las formas de reducir la diferencia entre el error en los datos de entrenamiento y en los nuevos.
- Grokking describe casos en los que un modelo que parece sobreajustado empieza, tras un largo entrenamiento adicional, a funcionar bien con datos nuevos.
- Fine-tuning con un conjunto pequeño exige el mismo control: datos aparte que el modelo no haya visto durante el aprendizaje.
- Catastrophic Forgetting [Polski] es otro problema: allí el modelo pierde una habilidad antigua tras un aprendizaje nuevo, y aquí desde el principio se traslada mal fuera de sus propios datos de entrenamiento.