Aprendizaje por refuerzo
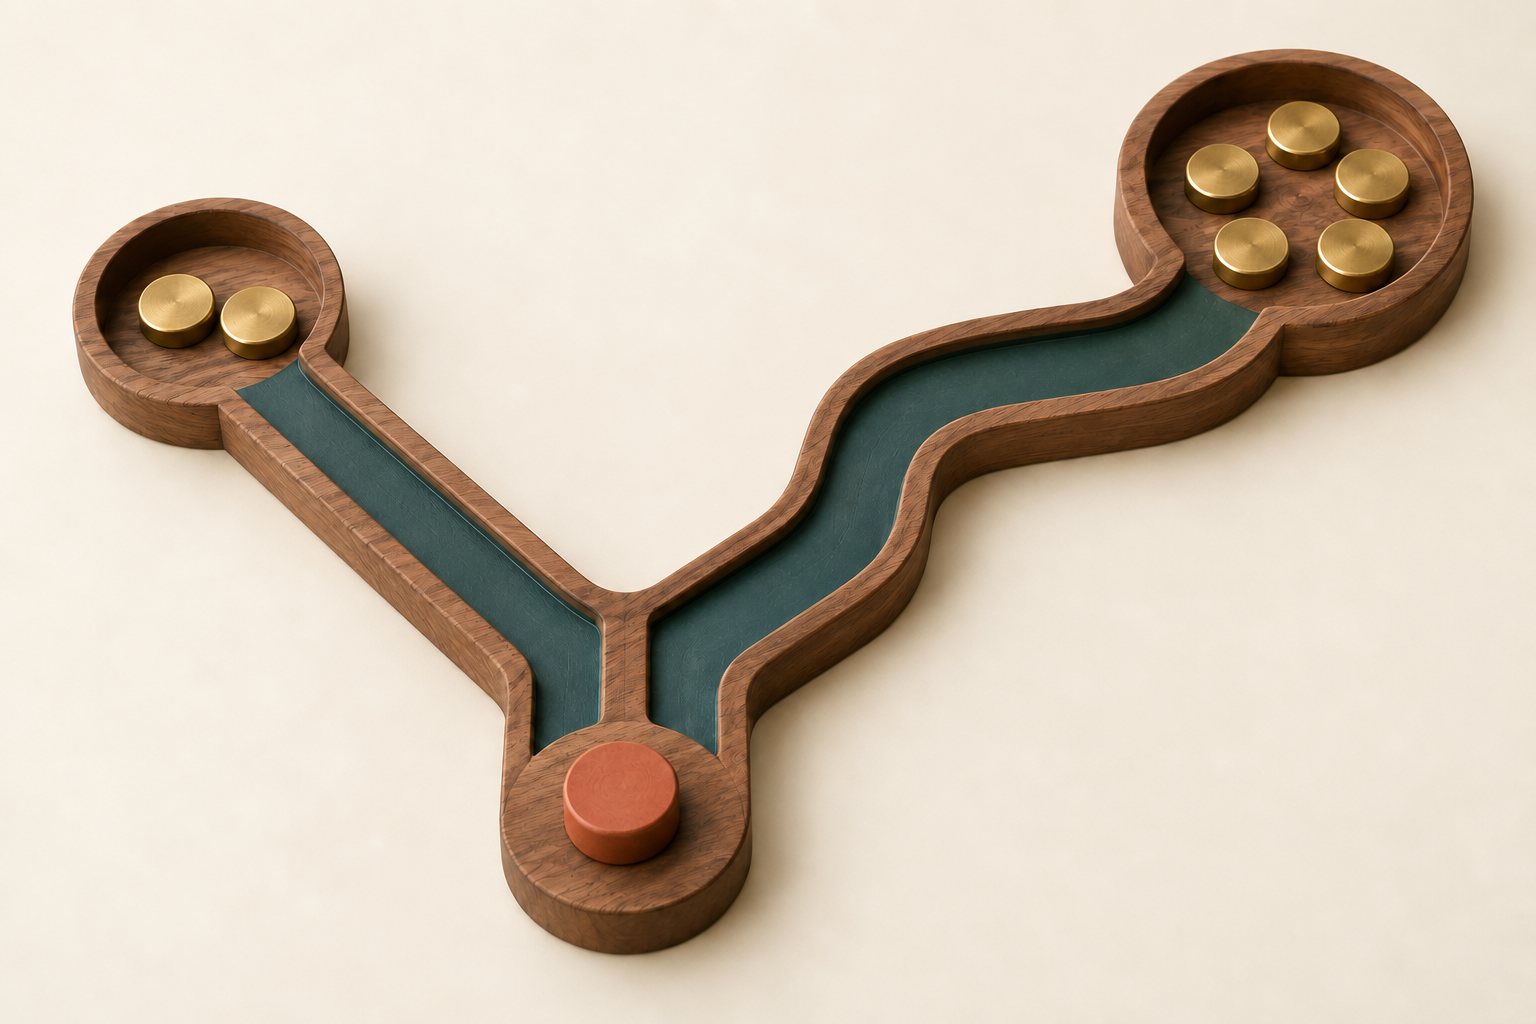
Quieres enseñar a un programa a ganar en un juego pequeño. En una bifurcación puede elegir la ruta A, recoger dos monedas de inmediato y terminar el segundo turno sin monedas nuevas. La ruta B no da nada en el primer turno, pero lleva a cinco monedas en el segundo. La regla «elige lo que más da ahora» señala A, aunque B produce un mejor resultado tras dos turnos. Tampoco tienes un conjunto de respuestas preparadas que indique el movimiento correcto en cada situación. En cambio, el programa puede jugar partidas y comprobar sus resultados.
Reinforcement Learning (RL) es el aprendizaje de una estrategia de acción a partir de experiencias y evaluaciones numéricas de los efectos de las acciones. El objetivo es aumentar la recompensa total esperada: el resultado que la estrategia produce en promedio tras muchos intentos. La recompensa no tiene por qué aparecer inmediatamente después de la decisión. Así describe el problema la guía oficial Spinning Up, parte 1, «Key Concepts and Terminology», «Reward and Return» y «The RL Problem».
Qué obtiene el programa de una partida
En nuestro juego, el agente es el programa que elige la ruta y el entorno es el juego que ejecuta el movimiento y concede las monedas. El programa recibe una observación, es decir, la información disponible sobre la situación, como la posición en el tablero. La policy es su regla para elegir acciones; también puede determinar las probabilidades de elegir distintos movimientos.
Después del intento A, el programa registra el resultado «2, luego 0». El intento B da «0, luego 5». El algoritmo de aprendizaje usa esas experiencias para mejorar la policy, por ejemplo, eligiendo B más a menudo en esta bifurcación. Es una descripción del objetivo, no una receta universal de actualización. Hay que relacionar el resultado 5 con la elección anterior de B. Si el programa siempre elige A, no recoge información sobre B; por eso el aprendizaje suele exigir probar también acciones menos conocidas.
El juego inventado tiene resultados fijos y dos turnos. En un entorno más difícil, el mismo movimiento puede tener efectos distintos, por lo que importa el resultado esperado y un éxito aislado no demuestra haber encontrado una buena estrategia. Comparar dos sumas conocidas tampoco constituye todavía aprendizaje.
En Behavioral cloning, el programa aprende a imitar acciones de ejemplos. En RL, la información que orienta el aprendizaje es la evaluación de los efectos. En los modelos de lenguaje, la acción puede ser generar una respuesta y la recompensa una evaluación de su corrección o utilidad. RLHF [Polski] usa para ello información procedente de personas.
Un límite importante: RL mejora el resultado según la recompensa elegida. Si los puntos premian eludir las reglas en lugar de completar la tarea, el agente puede aprender Reward hacking [Polski]. Más puntos no tienen por qué significar el comportamiento que realmente buscábamos.
Apuesta por una ruta y comprueba el segundo turno
En este experimento comparas el objetivo de dos estrategias, no entrenas a un agente. Elige una ruta y descubre el resultado posterior. El deslizador cambia la importancia de la recompensa futura, no el número de monedas recogidas.
Calculamos el return, es decir, el resultado de todo el intento: primera recompensa + γ × segunda recompensa. El símbolo γ (gamma) es el peso de la recompensa futura. Con γ = 1, contamos íntegramente ambos turnos: A da 2 y B da 5. Con γ = 0,2, obtenemos A = 2 y B = 1. Es un objetivo distinto para evaluar el mismo juego. Aquí se permiten los valores límite γ = 0 y 1 porque el intento termina después de dos turnos; no es una secuencia infinita de recompensas. Fuente del formalismo: Spinning Up, «Reward and Return».
Utilizo contenido generado por IA como parte de mi proceso diario de aprendizaje.