Empaquetado de secuencias
Enseñas al modelo a escribir respuestas breves para clientes: «Muchas gracias», «No» y «Sí». Tras dividirlas en fragmentos de texto, es decir, tokens, suponemos que los ejemplos tienen 3, 2 y 2 posiciones, incluyendo el marcador de final de cada texto. Si guardas cada uno en una fila separada de ocho posiciones, solo siete de las 24 contienen datos. El resto es padding: un relleno que iguala las longitudes, pero no es contenido que haya que aprender. ¿Cómo aprovechar las posiciones libres?
Sequence Packing coloca varios ejemplos en una única secuencia de entrada para reducir el relleno durante el entrenamiento. En nuestro ejemplo, los tres caben en una fila de ocho posiciones: siete con datos y una vacía. No se han creado respuestas nuevas; ha cambiado su disposición. La documentación de TRL 0.29.0, SFT Trainer, sección «Packing» describe esta función.
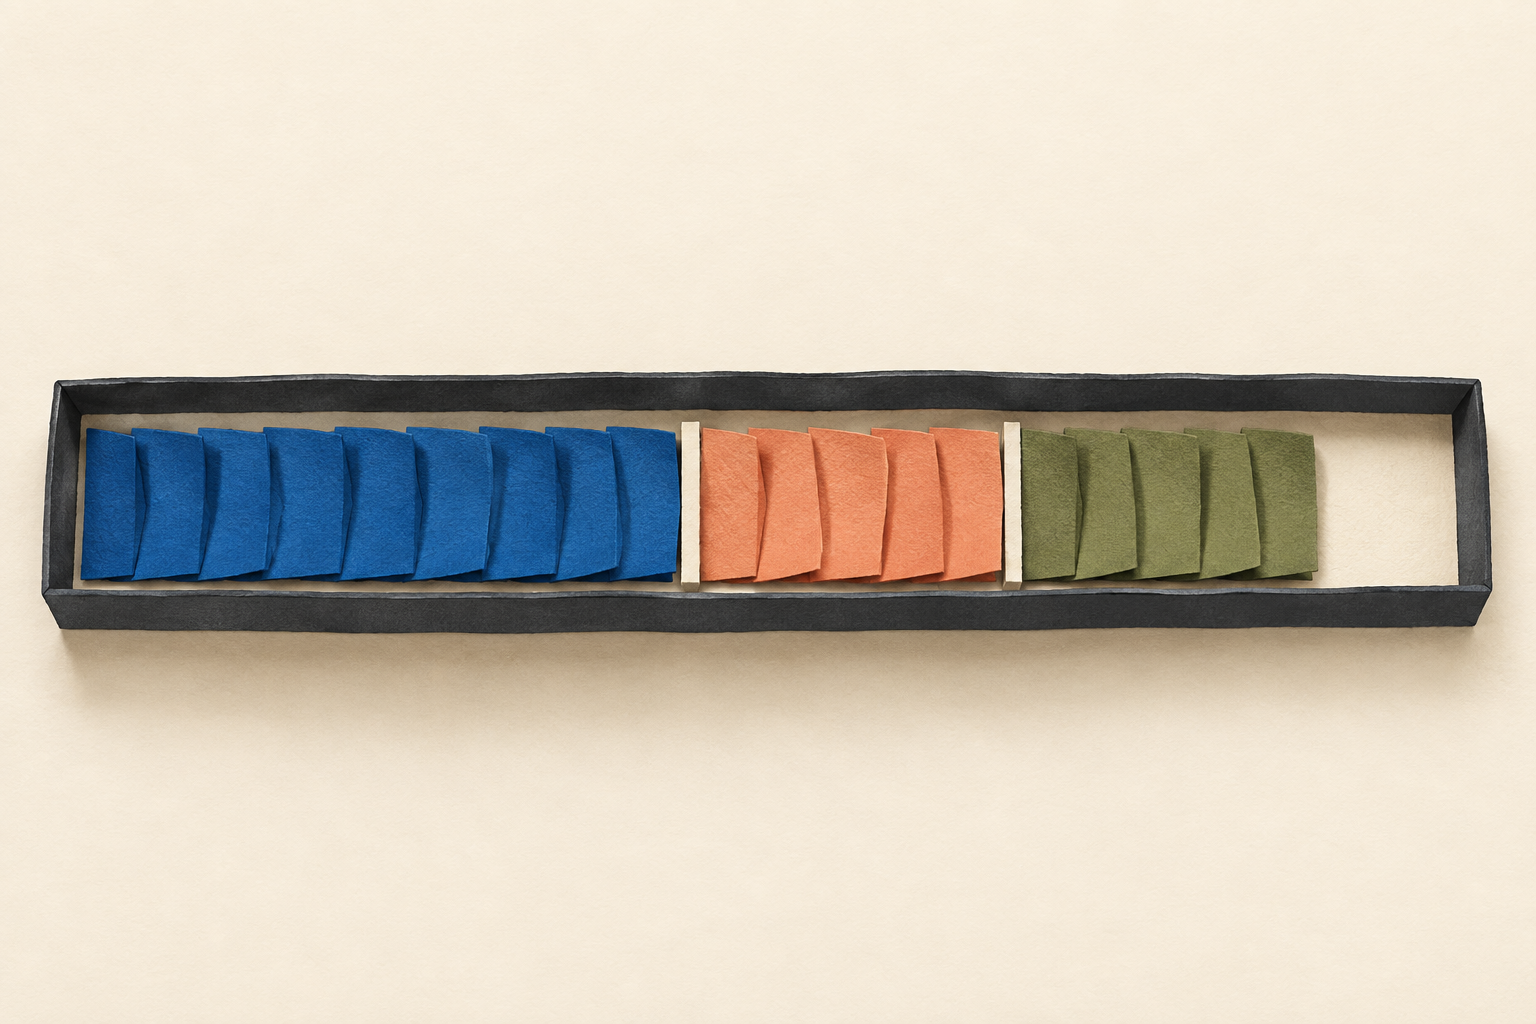
Las ocho posiciones son una simplificación propia, no el tamaño predeterminado de una fila en TRL. Un lote habitual de ejemplos puede alinearse solo con el texto más largo; agrupar longitudes similares también reduce el espacio desperdiciado. Attention Is All You Need, §5.1, ya describe esta agrupación. El número de posiciones vacías no determina por sí solo la aceleración: también depende de cómo se ejecutan los cálculos.
Una fila compartida no tiene por qué ser una conversación compartida
Quieres que «No» siga siendo un ejemplo independiente, no una continuación de «Muchas gracias». El marcador de final es solo un token. El bloqueo habitual de acceso al futuro —Causal Masking— sigue permitiendo que un texto posterior lea el anterior dentro de la misma fila.
Para conservar la independencia, los cálculos tienen que conocer los límites de los ejemplos y bloquear el acceso a través de ellos. También hay que cuidar por separado la evaluación del error: no enseñar a predecir el primer token de «No» desde el final del texto anterior. La selección de posiciones evaluadas es Loss masking; omitir la penalización de una posición no bloquea su lectura.
En concreto, en el código de TRL 0.29.0: DataCollatorForLanguageModeling y la configuración de BFD packing, las longitudes de los ejemplos sirven para reconstruir los límites y los comienzos se omiten en la evaluación del error. Esta ejecución exige una implementación compatible de attention, el mecanismo que usa otras posiciones del texto; el código advierte de fugas de información con una configuración no compatible. Es una condición de esa solución concreta, no una propiedad de todo packing.
Comprueba dos cosas por separado
Activa el empaquetado y después desactiva la separación del acceso. Las posiciones seguirán ahorradas, pero B1 podrá usar el ejemplo A anterior. Los cuadrados representan tokens de final; A1, B1, etc. son fragmentos de texto hipotéticos. La demostración muestra las conexiones permitidas sin simular respuestas del modelo. La variante «filas completas» revela la ausencia de ahorro cuando todos los ejemplos ya llenan ocho posiciones cada uno.
Las estrategias difieren en cómo tratan los textos largos. En TRL 0.29.0, función pack_dataset, bfd ajusta ejemplos enteros a los huecos libres, pero recorta el exceso de un ejemplo demasiado largo; wrapped puede cortar el texto por la mitad. Por eso hay que comprobar tanto los datos conservados como los límites. Packing organiza las entradas del entrenamiento, incluido Fine-tuning, la adaptación adicional del modelo mediante ejemplos. No aumenta la longitud máxima de texto que admite el modelo.