Reinforcement Learning
Chcesz nauczyć program wygrywać w małej grze. Na rozwidleniu może wybrać drogę A, zebrać dwie monety od razu i zakończyć drugą turę bez nowych monet. Droga B w pierwszej turze nie daje nic, ale w drugiej prowadzi do pięciu monet. Reguła „wybieraj to, co daje najwięcej teraz” wskazuje A, choć po dwóch turach lepszy wynik daje B. Nie masz też zbioru gotowych odpowiedzi wskazujących właściwy ruch w każdej sytuacji. Program może natomiast rozgrywać partie i sprawdzać ich wyniki.
Reinforcement Learning (RL) to uczenie strategii działania na podstawie doświadczeń i liczbowych ocen skutków działań. Celem jest zwiększanie oczekiwanej łącznej nagrody: wyniku, jaki strategia przynosi przeciętnie w wielu próbach. Nagroda nie musi pojawić się natychmiast po decyzji. Tak opisuje problem oficjalny Spinning Up, część 1, „Key Concepts and Terminology”, „Reward and Return” oraz „The RL Problem”.
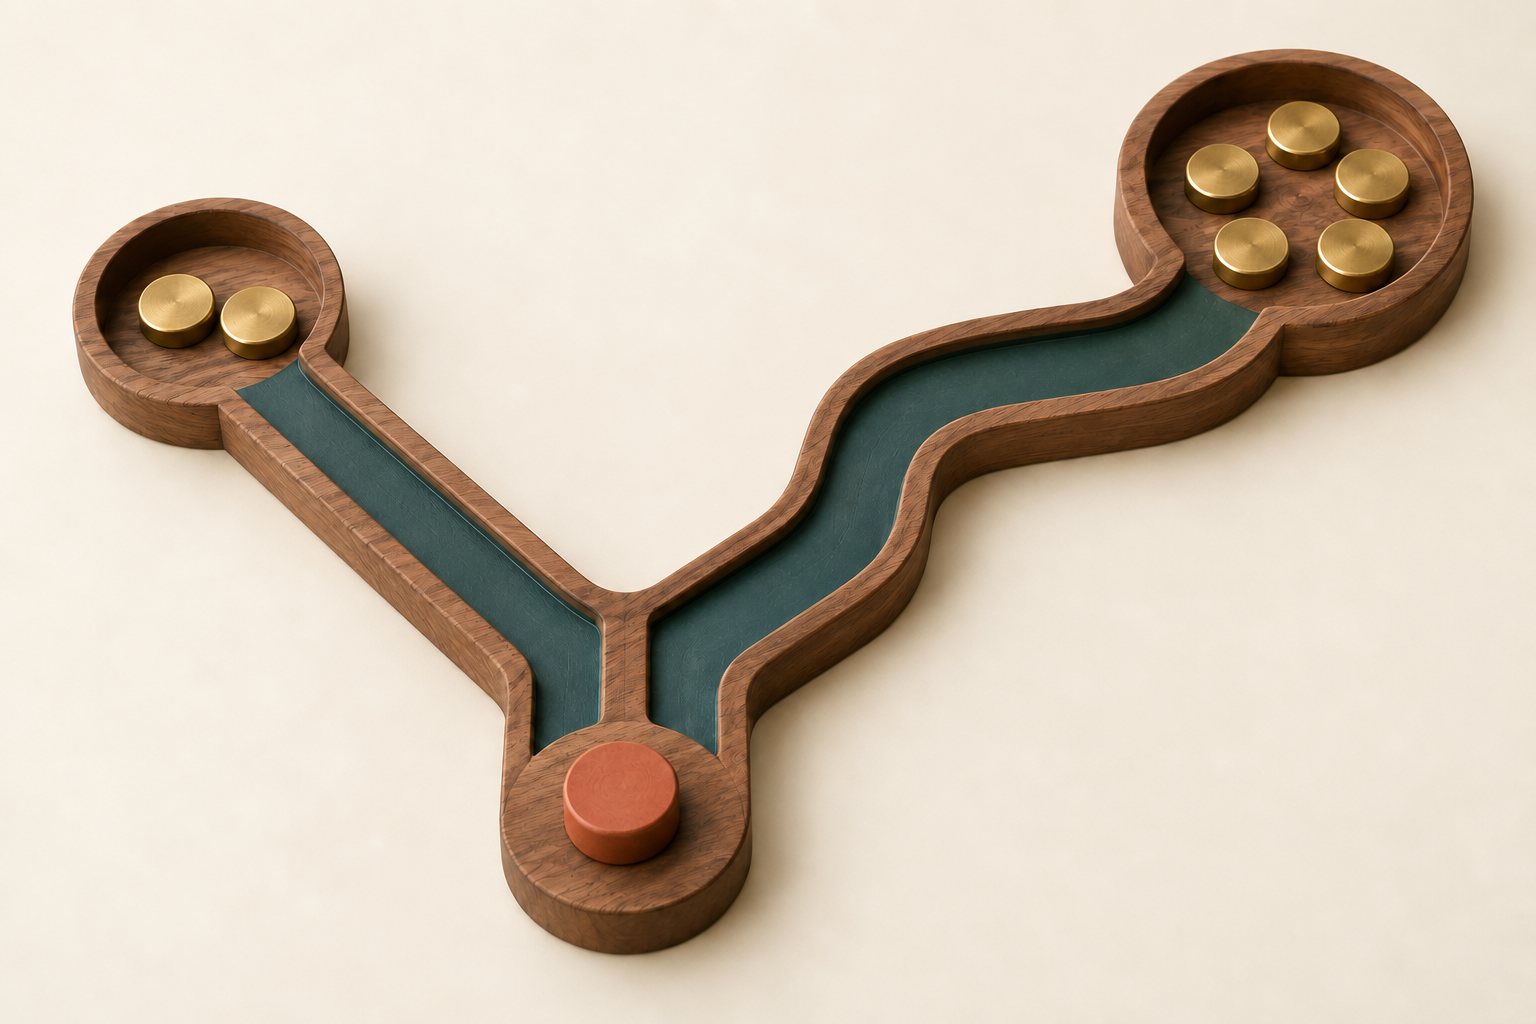
Co program wyciąga z rozegranej partii
W naszej grze agent to program wybierający drogę, a środowisko to gra, która wykonuje ruch i przyznaje monety. Program dostaje obserwację, czyli dostępne informacje o sytuacji, na przykład położenie na planszy. Policy jest jego regułą wyboru działań; może także określać szanse wyboru różnych ruchów.
Po próbie A program zapisuje wynik „2, potem 0”. Próba B daje „0, potem 5”. Algorytm uczenia wykorzystuje takie doświadczenia, aby poprawić policy, na przykład częściej wybierać B na tym rozwidleniu. To opis celu, nie jedna uniwersalna recepta aktualizacji. Wynik 5 trzeba powiązać z wcześniejszym wyborem B. Jeśli program zawsze wybiera A, nie zbierze informacji o B; dlatego uczenie często wymaga próbowania także mniej znanych działań.
Wymyślona gra ma stałe wyniki i dwie tury. W trudniejszym środowisku ten sam ruch może przynosić różne skutki, dlatego liczy się oczekiwany wynik, a pojedynczy sukces nie dowodzi znalezienia dobrej strategii. Samo porównanie dwóch znanych sum również nie jest jeszcze uczeniem.
W Behavioral cloning program uczy się naśladować działania z przykładów. W RL informacją kierującą uczeniem jest ocena skutków. W modelach językowych działaniem może być wygenerowanie odpowiedzi, a nagrodą ocena jej poprawności lub przydatności. RLHF wykorzystuje do tego informacje pochodzące od ludzi.
Ważna granica: RL poprawia wynik według przyjętej nagrody. Jeśli punkty premiują obchodzenie zasad zamiast zadania, agent może wyuczyć się Reward hacking. Więcej punktów nie musi oznaczać zachowania, na którym naprawdę nam zależało.
Obstaw drogę, potem sprawdź drugą turę
W tym eksperymencie porównujesz cel dwóch strategii, nie trenujesz agenta. Wybierz drogę i odsłoń późniejszy wynik. Suwak zmienia znaczenie przyszłej nagrody, nie liczbę zebranych monet.
Liczymy return, czyli wynik całej próby: pierwsza nagroda + γ × druga nagroda. Symbol γ (gamma) jest wagą przyszłej nagrody. Przy γ = 1 liczymy obie tury w pełni: A daje 2, B daje 5. Przy γ = 0,2 otrzymujemy A = 2, B = 1. To inny cel oceny tej samej gry. Graniczne γ = 0 i 1 są tutaj dozwolone, bo próba kończy się po dwóch turach; nie jest to nieskończony ciąg nagród. Źródło formalizmu: Spinning Up, „Reward and Return”.
Wykorzystuję treści generowane przez AI jako część mojego codziennego procesu nauki.