TypeSafe wydało Jev. Model do klasyfikacji i ocen liczbowych
TypeSafe AI udostępniło Jev 15 września 2026 roku, początkowo we wczesnym dostępie. To model do zadań, w których program potrzebuje wyboru kategorii lub oceny liczbowej: przypisania zgłoszenia do działu, oceny dokumentu albo wyboru dalszej czynności. Korzysta się z niego przez API z kluczem konta TypeSafe, a także przez Vercel AI Gateway. Vercel oferuje obecnie bezpłatne wywołania w promocji kończącej się 25 września. Niski koszt takich wywołań może uzasadniać częstsze sprawdzanie pracy agentów, pod warunkiem zmierzenia, jakie błędy Jev przepuszcza.
Według oficjalnej specyfikacji Jev 1.13 milion tokenów wejścia kosztuje 0,042 dolara, a za wyjście nie ma opłaty. Model przyjmuje wyłącznie tekst: do 64 tys. tokenów łącznie na żądanie, przy dodatkowym limicie 32 tys. na dane i najdłuższe pojedyncze pytanie. Zwraca wartości o ustalonym typie, bez swobodnego tekstu. Producent publikuje też opis ograniczeń wersji 1.13, w tym podatności na instrukcje umieszczone w ocenianych danych.
Równoległe pytania do jednego dokumentu
Aplikacja przesyła dane w polu state oraz zestaw pytań. Choice wybiera jedną z podanych opcji i zwraca prawdopodobieństwa wszystkich odpowiedzi. Score ocenia materiał według opisanych poziomów, a Noul podaje prawdopodobieństwo odpowiedzi „tak”. Dwa pierwsze typy mają dodatkowe pole confidence, opisujące skupienie prawdopodobieństw na poszczególnych odpowiedziach.
Według dokumentacji interfejsu pytania są oceniane równolegle i niezależnie na tych samych danych. Jeżeli drugie pytanie wymaga wyniku pierwszego, aplikacja musi wykonać kolejne żądanie. Można natomiast od razu zapytać o dział obsługi, pilność i charakter problemu, a potem połączyć odpowiedzi regułami zapisanymi w kodzie.
Producent wiąże oszczędność z obliczaniem odpowiedzi równolegle, bez generowania kolejnych tokenów zależnych od poprzednich. Swój trening nazywa RLCD, czyli uczeniem przez wzmacnianie ukierunkowanym na kalibrację decyzji. Kalibracja oznacza, że przypisywane prawdopodobieństwa powinny odpowiadać częstości poprawnych odpowiedzi. Według współzałożyciela TypeSafe, Diogo Almeidy, cytowanego przez TechCrunch, trening wykorzystuje wyłącznie dane syntetyczne.
Oficjalne testy procesów biznesowych
Benchmark TypeSafe obejmuje obsługę incydentów bezpieczeństwa, ocenę przebiegu pracy agenta, faktury i obsługę klientów. Wariant workflow rozdziela zadanie między pytania do modelu a reguły programu. Wariant prompt przekazuje instrukcję całego procesu modelowi.
Wynik jest zgodnością z odpowiedziami referencyjnymi wyprowadzonymi z GPT-6 Astra i Claude Fable 5.1 przy wysokim wysiłku rozumowania. Pozostałe konfiguracje używają domyślnych ustawień dostawców. To pomiar względem ocen modeli, bez niezależnego klucza poprawnych decyzji. Średnia nadaje równą wagę każdemu z czterech procesów.
Model w wariancie workflow | Zgodność z odpowiedzią referencyjną | Koszt przypadku | Czas przypadku |
|---|---|---|---|
| Jev | 67,8% | ok. 0,0004 USD | ok. 0,4 s |
| OpenAI Terra | 67,9% | 0,0304 USD | 10,1 s |
| OpenAI Sol | 74,1% | 0,0836 USD | 23,3 s |
To wartości zaokrąglone w interaktywnym zestawieniu producenta, które oznacza modele jako Terra i Sol bez datowanych identyfikatorów wersji. Modele językowe korzystają z adaptera TypeSafe, który wymaga odpowiedzi i prawdopodobieństw zgodnych z jego interfejsem. Taki warunek zwiększa ich koszt względem zwracania samej etykiety.
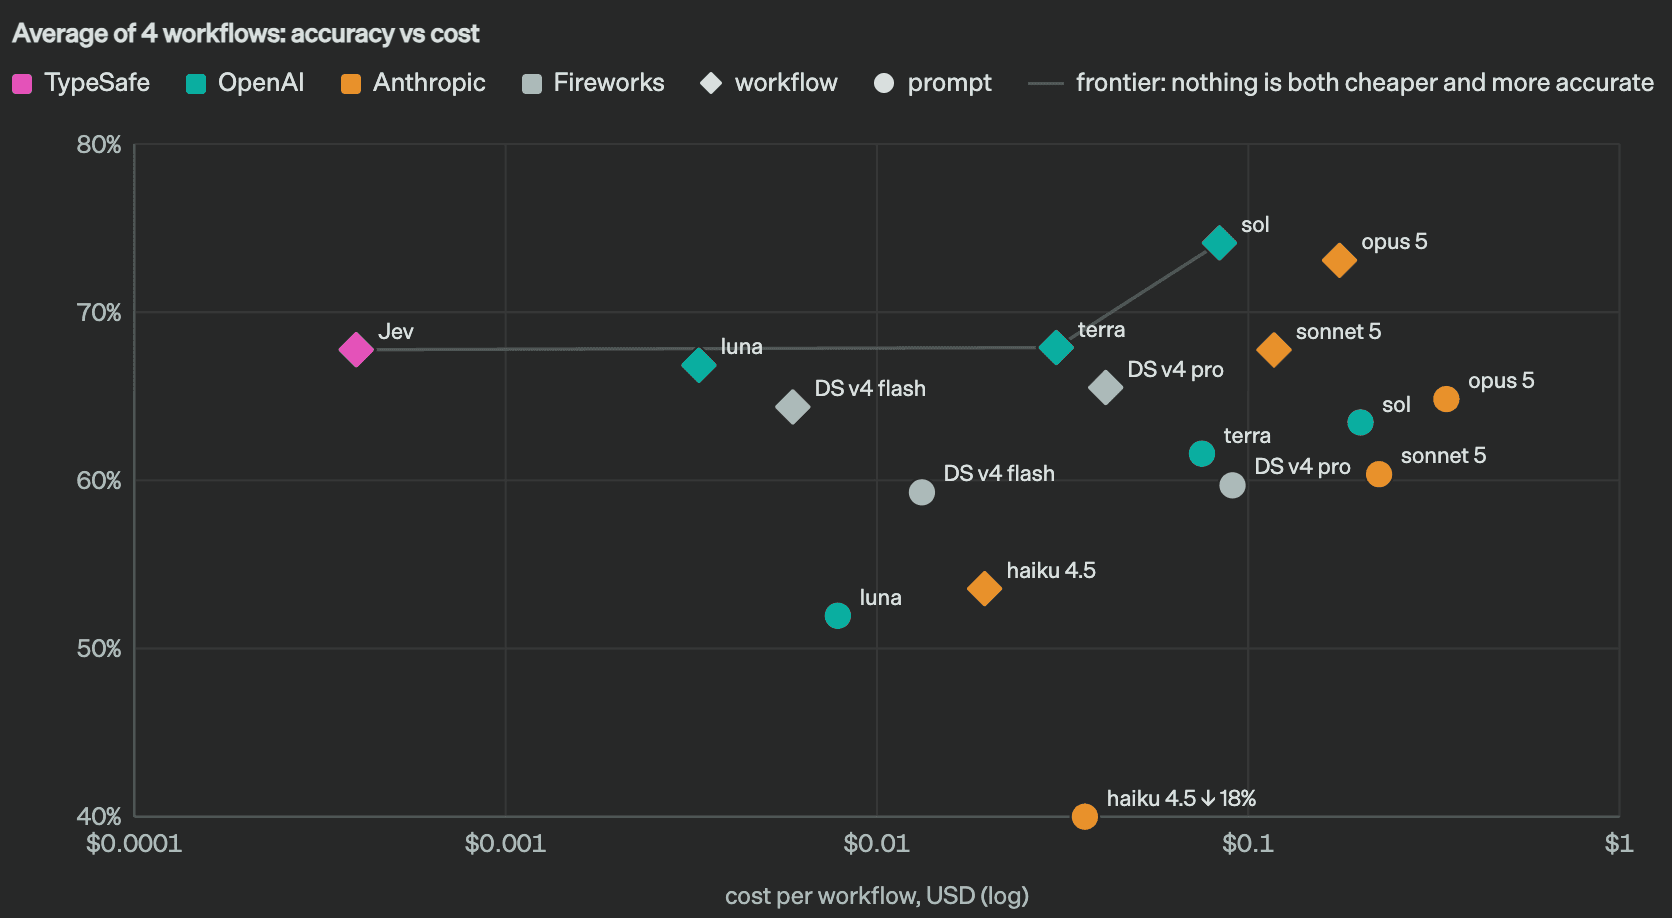
Źródło: TypeSafe AI. Średnia zgodność z ocenami modeli referencyjnych w czterech procesach względem kosztu w USD, na osi logarytmicznej. Romby oznaczają podział pracy między kod i model; kółka, instrukcję całego procesu w jednym poleceniu.
Niezależne pomiary klasyfikacji i kontroli tekstu
AY Automate wykonało 19 września po jednym przebiegu na 791 przykładach. Jev działał jako typesafe/jev-1.13-20260917 przez OpenRouter. Konkurenci otrzymali ścisły schemat JSON, temperaturę 0, wysiłek minimal i limit 300 tokenów odpowiedzi. Każdy przykład stanowił osobne żądanie; uruchamiano cztery równolegle na model. Etykiety kategorii nie miały dodatkowych opisów.
| Zadanie | Jev | GPT-5.4 nano | GPT-5.6 Terra |
|---|---|---|---|
| Banking77: 8 kategorii, 160 wiadomości | 83,8% | 90,0% | 89,4% |
| Banking77: 77 kategorii, 231 wiadomości | 78,8% | 78,4% | 84,0% |
| Wykrywanie wstrzykniętych instrukcji: 400 tekstów | 87,0% | 80,8% | 86,8% |
Tabela liczy nieudane wywołania jako błędne. Przy progu 0,5 Jev przeoczył 52 ze 170 tekstów z atakiem, nie oznaczając błędnie żadnego z 230 nieszkodliwych. Mediana czasu dla wszystkich zadań wyniosła 0,33 s dla Jev, 1,15 s dla nano i 1,17 s dla Terry. Tysiąc decyzji w zadaniu z ośmioma kategoriami kosztowało odpowiednio około 0,0151, 0,0704 i 0,6089 dolara. Wyniki pochodzą z jednego przebiegu przez OpenRouter na publicznych danych; nieznana jest ich obecność w treningu. AY Automate sprzedaje usługi automatyzacji, ale nie wdrożyło wtedy Jev u klientów.
Every przeprowadziło mniejszy test redakcyjny: cztery kryteria oceny zastosowano do 12 syntetycznych fragmentów. Jev wykrył sześć z siedmiu celowo wprowadzonych usterek, a Fable 5.1 z wysokim wysiłkiem rozumowania wszystkie siedem. Mediany czasu wyniosły 0,35 i 8,83 s na fragment. To doświadczenie firmy rozwijającej produkty i usługi AI, na niewielkiej próbce przygotowanej przez jej CEO. Pokazuje konkretny kompromis między czasem a wykrywaniem błędów, bez podstaw do ogólnego rankingu modeli.
Gwarancja formatu i błędne decyzje
TypeSafe pokazuje osobny wykres błędów formatu odpowiedzi i wywołań narzędzi. Widoczne przy Jev 0% wynika z konstrukcji interfejsu. Producent wyraźnie zaznacza, że nie jest to wynik pomiaru. Dane dla modeli językowych pochodzą z OpenRouter, gdzie trudniejsze żądania mogą trafiać do innych modeli. Zestawienie nie porównuje ich na identycznych przykładach.
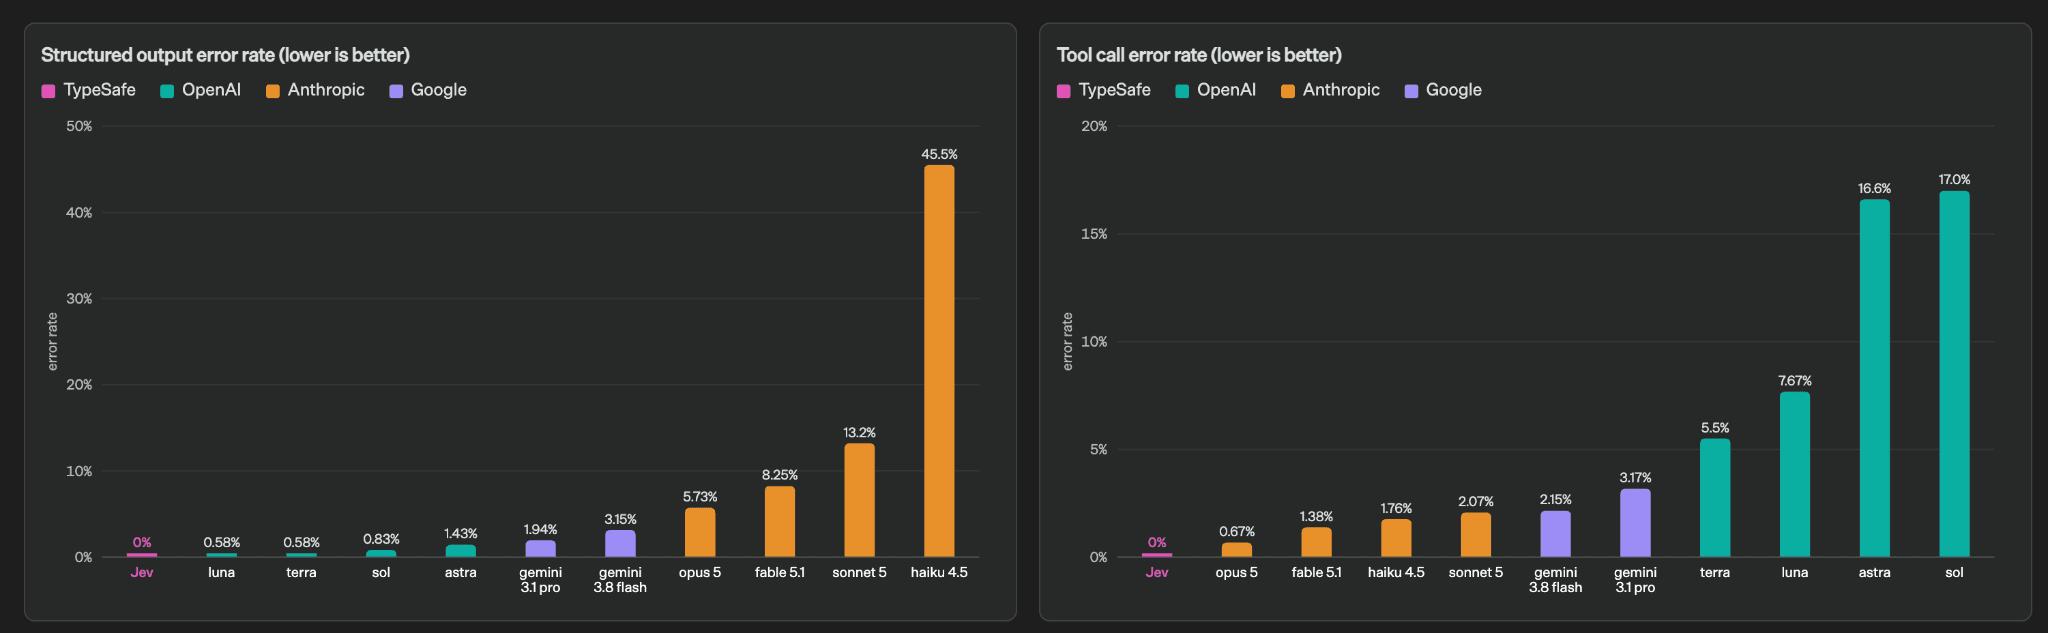
Źródło: TypeSafe AI. Odsetki błędów formatu w danych OpenRouter. Wartość 0% dla Jev jest deklarowaną gwarancją zgodności ze schematem, a nie zmierzoną trafnością decyzji ani skutecznością zabezpieczeń.
Jev 1.13 ma udokumentowane problemy z liczeniem, porównywaniem dat, złożonymi negacjami i nadmiarem nieistotnych danych. Producent pokazuje również rozbieżności między pytaniem tak/nie a wyborem spośród dwóch etykiet. Progu wyznaczonego dla jednego sposobu pytania nie należy automatycznie przenosić na drugi.
Dane w state mogą zawierać polecenia nakłaniające model do określonej klasyfikacji. TypeSafe przyznaje, że takie treści mogą zmienić odpowiedź. Jeżeli aplikacja na podstawie oceny Jev uruchamia narzędzie, jej kod musi osobno sprawdzić uprawnienia do tej operacji, również gdy model zwróci odpowiedź allow.
Progi działania i warunki wdrożenia
Pole confidence jest statystyką obliczaną z prawdopodobieństw odpowiedzi. Wysoka wartość oznacza, że model zdecydowanie wskazuje pewne opcje; nie stanowi pomiaru skuteczności na danych danej firmy. Przed automatycznym wykonywaniem czynności trzeba dobrać próg na oznaczonych przykładach i sprawdzić go na oddzielnym zbiorze, uwzględniając koszt błędnej akceptacji i błędnego odrzucenia. Przypadki poniżej progu można kierować do człowieka albo innego modelu.
Dokumentacja TypeSafe podaje, że Jev działa najlepiej po angielsku. Dla polskich zgłoszeń potrzebny jest więc osobny pomiar. Warto przypiąć jev-1.13.0, ponieważ aliasy jev-latest i jev-preview mogą z czasem wskazać inną wersję. Podane limity wynoszą 1200 żądań na minutę i 250 tys. tokenów na sekundę, lecz firma zastrzega ich bieżące zmiany. Deklaruje też niewykorzystywanie zapytań i odpowiedzi klientów do treningu; brak retencji danych oferuje w warunkach dla przedsiębiorstw.
Źródła
Źródła pierwotne
- TypeSafe: komunikat o premierze Jev i oficjalne wykresy
- TypeSafe: wersje, ceny i limity modelu
- TypeSafe: pytania i odpowiedzi API
- TypeSafe: znaczenie pola confidence
- TypeSafe: ograniczenia Jev 1.13
- TypeSafe: metodologia i wyniki Workflow evals
- Vercel: dostęp do Jev przez AI Gateway
Niezależne analizy i relacje
- AY Automate: porównanie na 791 przykładach wraz z kodem i wynikami
- Every: testy Jev opisane przez Mike’a Taylora
- TechCrunch: rozmowa z Almeidą
Wykorzystuję treści generowane przez AI jako część mojego codziennego procesu nauki.