Reinforcement Learning
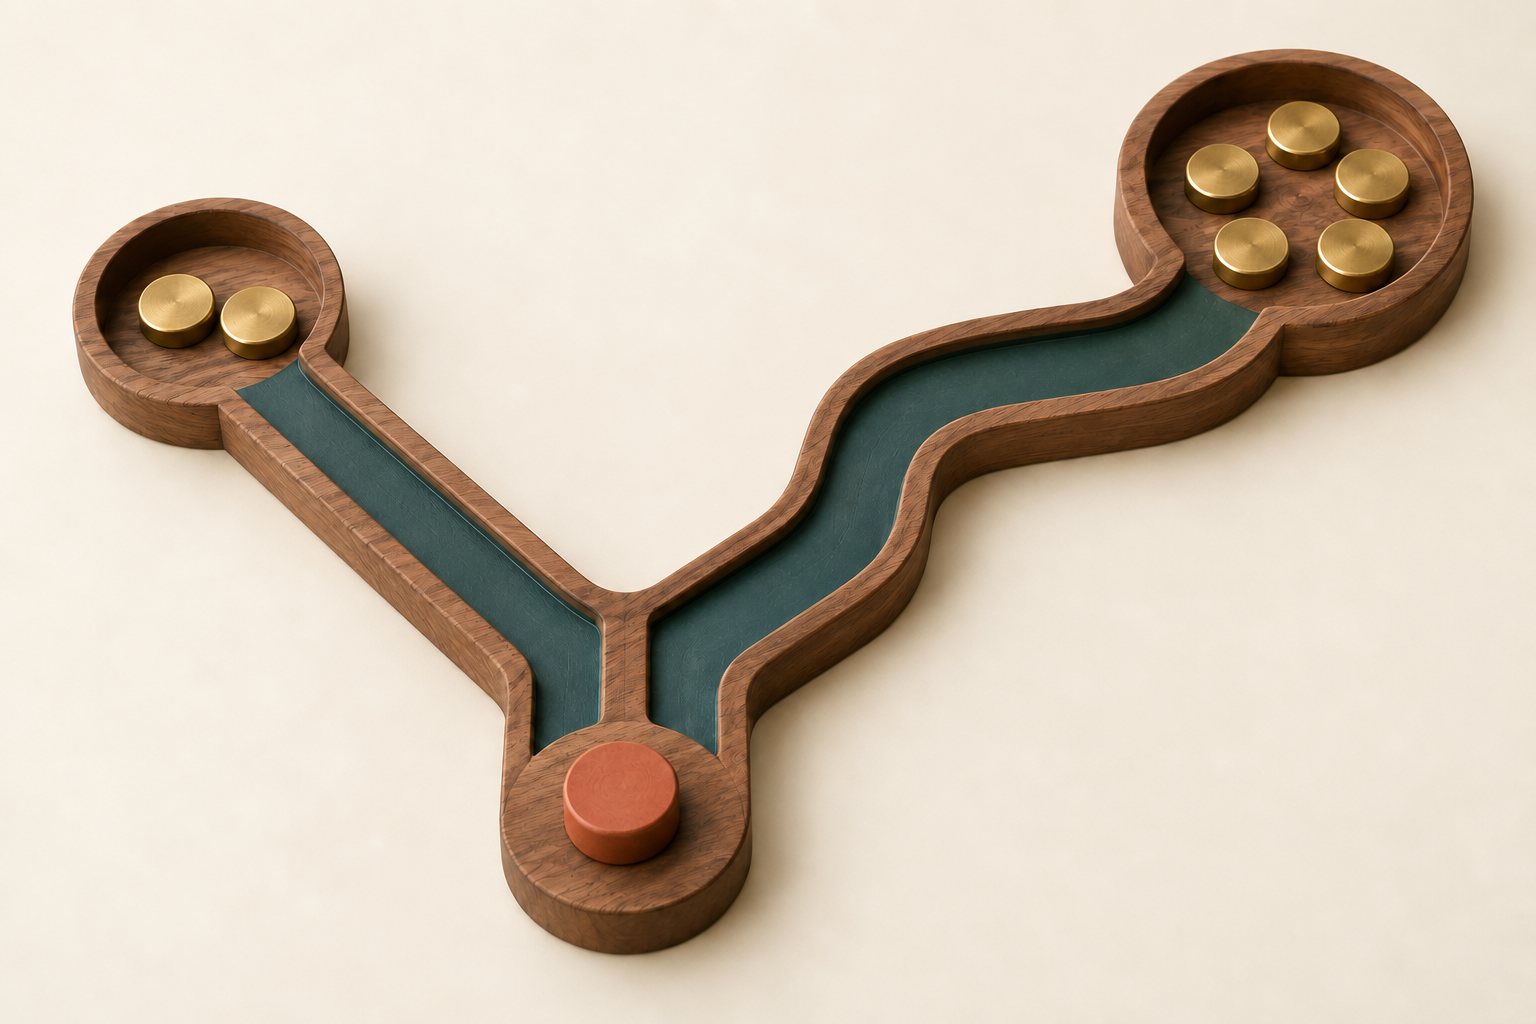
Du möchtest einem Programm beibringen, ein kleines Spiel zu gewinnen. An einer Weggabelung kann es Weg A wählen, sofort zwei Münzen sammeln und die zweite Runde ohne neue Münzen beenden. Weg B gibt in der ersten Runde nichts, führt aber in der zweiten zu fünf Münzen. Die Regel „wähle, was jetzt am meisten bringt“ zeigt auf A, obwohl B nach zwei Runden das bessere Ergebnis liefert. Du hast auch keinen fertigen Antwortdatensatz, der in jeder Situation den richtigen Zug vorgibt. Das Programm kann jedoch Partien spielen und ihre Ergebnisse prüfen.
Reinforcement Learning (RL) ist das Lernen einer Handlungsstrategie anhand von Erfahrungen und numerischen Bewertungen der Aktionsfolgen. Ziel ist, die erwartete Gesamtbelohnung zu erhöhen: das Ergebnis, das eine Strategie im Mittel über viele Versuche erzielt. Die Belohnung muss nicht sofort nach der Entscheidung erscheinen. So beschreibt das offizielle Spinning Up, Teil 1, „Key Concepts and Terminology“, „Reward and Return“ und „The RL Problem“, das Problem.
Was das Programm aus einer gespielten Partie lernt
In unserem Spiel ist der Agent das Programm, das den Weg wählt, und die Umgebung ist das Spiel, das den Zug ausführt und Münzen vergibt. Das Programm erhält eine Beobachtung, also verfügbare Informationen zur Situation, etwa die Position auf dem Brett. Die Policy ist seine Regel zur Aktionsauswahl; sie kann auch die Wahrscheinlichkeiten unterschiedlicher Züge festlegen.
Nach Versuch A speichert das Programm das Ergebnis „2, dann 0“. Versuch B ergibt „0, dann 5“. Der Lernalgorithmus nutzt solche Erfahrungen zur Verbesserung der Policy, etwa um an dieser Gabelung häufiger B zu wählen. Das beschreibt das Ziel, nicht ein universelles Aktualisierungsrezept. Das Ergebnis 5 muss mit der früheren Entscheidung für B verknüpft werden. Wählt das Programm immer A, sammelt es keine Informationen über B; deshalb erfordert das Lernen oft auch das Ausprobieren weniger bekannter Aktionen.
Das erfundene Spiel hat feste Ergebnisse und zwei Runden. In einer schwierigeren Umgebung kann derselbe Zug unterschiedliche Folgen haben; deshalb zählt das erwartete Ergebnis, und ein einzelner Erfolg beweist keine gute Strategie. Auch das bloße Vergleichen zweier bekannter Summen ist noch kein Lernen.
Beim Behavioral Cloning lernt das Programm, Aktionen aus Beispielen nachzuahmen. Bei RL ist die Bewertung der Folgen die Information, die das Lernen lenkt. In Sprachmodellen kann die Aktion das Erzeugen einer Antwort sein, die Belohnung eine Bewertung ihrer Richtigkeit oder Nützlichkeit. RLHF [Polski] nutzt dafür Informationen von Menschen.
Eine wichtige Grenze: RL verbessert das Ergebnis nach der festgelegten Belohnung. Belohnen die Punkte das Umgehen von Regeln statt der Aufgabe, kann der Agent Reward Hacking [Polski] lernen. Mehr Punkte müssen nicht das Verhalten bedeuten, das wir tatsächlich erreichen wollten.
Wähle einen Weg und prüfe dann die zweite Runde
In diesem Experiment vergleichst du das Ziel zweier Strategien; du trainierst keinen Agenten. Wähle einen Weg und decke das spätere Ergebnis auf. Der Regler verändert die Bedeutung der zukünftigen Belohnung, nicht die Zahl gesammelter Münzen.
Wir berechnen den Return, also das Ergebnis des gesamten Versuchs: erste Belohnung + γ × zweite Belohnung. Das Symbol γ (Gamma) ist das Gewicht der zukünftigen Belohnung. Bei γ = 1 zählen wir beide Runden vollständig: A ergibt 2, B ergibt 5. Bei γ = 0,2 erhalten wir A = 2, B = 1. Das ist ein anderes Bewertungsziel für dasselbe Spiel. Die Grenzwerte γ = 0 und 1 sind hier zulässig, weil der Versuch nach zwei Runden endet; es ist keine unendliche Belohnungsfolge. Quelle des Formalismus: Spinning Up, „Reward and Return“.
Ich nutze KI-generierte Inhalte als Teil meines täglichen Lernprozesses.