Sequence Packing
Du trainierst ein Modell, kurze Antworten an Kunden zu schreiben: „Vielen Dank“, „Nein“ und „Ja“. Nach der Aufteilung in Textstücke, also Tokens, haben die Beispiele hier vereinfachend 3, 2 und 2 Positionen, einschließlich einer Endmarkierung für jeden Text. Wenn du jedes in einer eigenen Zeile mit acht Plätzen speicherst, enthalten von 24 Plätzen nur sieben Daten. Der Rest ist Padding — Füllmaterial, das die Längen angleicht, aber kein zu lernender Inhalt ist. Wie lassen sich die freien Plätze nutzen?
Sequence Packing ordnet mehrere Beispiele in einer Eingabefolge an, um das Padding beim Training zu verringern. In unserem Beispiel passen alle drei in eine einzige Zeile mit acht Positionen: sieben Plätze mit Daten, einer leer. Es sind keine neuen Antworten entstanden; ihre Anordnung hat sich geändert. Diese Rolle beschreibt die TRL-Dokumentation 0.29.0, SFT Trainer, Abschnitt „Packing“.
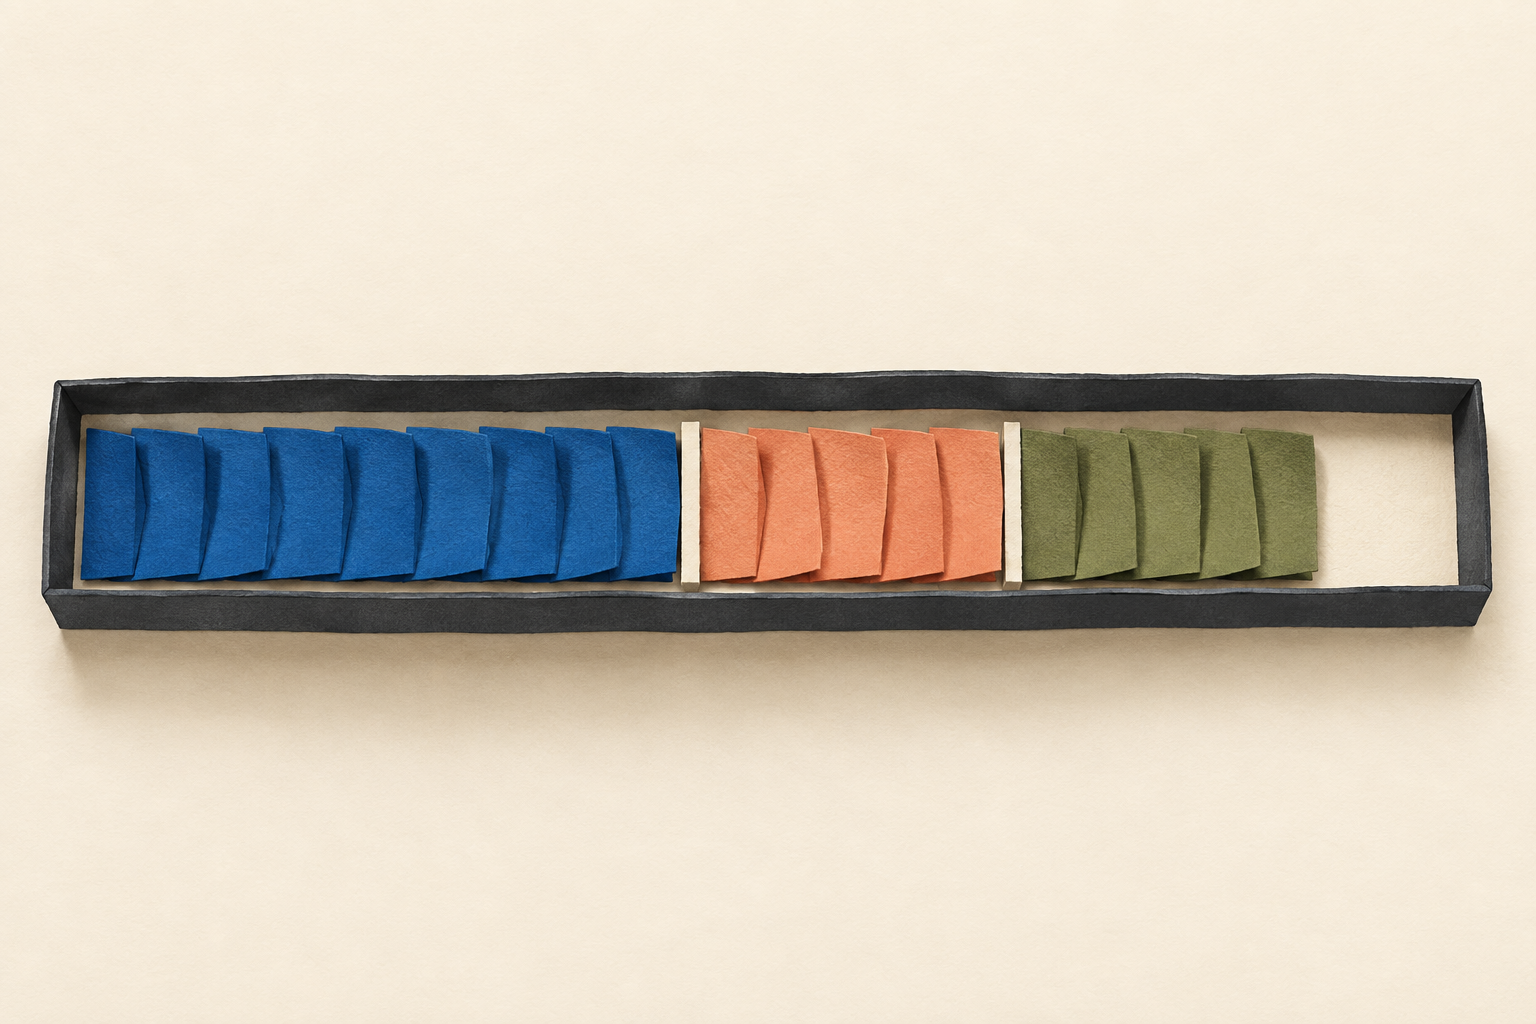
Acht Plätze sind eine eigene Vereinfachung, keine voreingestellte Zeilengröße in TRL. Ein gewöhnlicher Batch kann nur auf die Länge des längsten Textes aufgefüllt werden; das Gruppieren ähnlicher Längen verringert ebenfalls ungenutzten Platz. Bereits Attention Is All You Need, §5.1, beschreibt diese Gruppierung. Die Zahl leerer Plätze allein bestimmt die Beschleunigung nicht: Sie hängt auch von der Ausführung der Berechnungen ab.
Eine gemeinsame Zeile muss kein gemeinsames Gespräch sein
Du möchtest, dass „Nein“ ein unabhängiges Beispiel bleibt und keine Fortsetzung von „Vielen Dank“ wird. Die Endmarkierung selbst ist nur ein Token. Die gewöhnliche Sperre des Blicks in die Zukunft — Causal Masking — erlaubt späterem Text weiterhin, früheren Text derselben Zeile zu lesen.
Um die Unabhängigkeit zu bewahren, müssen die Berechnungen die Beispielgrenzen kennen und den Zugriff über diese Grenzen hinweg blockieren. Die Fehlerbewertung muss separat kontrolliert werden: Die Vorhersage des ersten Tokens von „Nein“ aus dem Ende des vorherigen Textes darf nicht trainiert werden. Die Auswahl bewerteter Positionen ist Loss Masking; das Auslassen einer Strafe für eine Position blockiert das Lesen dieser Position nicht.
Konkret dienen im Code von TRL 0.29.0: DataCollatorForLanguageModeling und BFD-Packing-Konfiguration die Beispiellängen der Rekonstruktion der Grenzen, und die Anfänge werden von der Fehlerbewertung ausgenommen. Dieser Ablauf benötigt eine kompatible Attention-Implementierung — den Mechanismus zur Nutzung anderer Textpositionen; der Code warnt bei einer nicht unterstützten Konfiguration vor durchsickernden Informationen. Das ist eine Bedingung dieses konkreten Verfahrens, keine Eigenschaft jedes Packings.
Prüfe zwei getrennte Dinge
Aktiviere das Packing und deaktiviere anschließend die Trennung der Zugriffe. Die Platzersparnis bleibt erhalten, aber B1 kann das frühere Beispiel A nutzen. Quadrate bezeichnen Endtokens; A1, B1 und so weiter sind beispielhafte Textstücke. Die Demonstration zeigt erlaubte Verbindungen, ohne Modellantworten zu simulieren. Die Variante „volle Zeilen“ zeigt die fehlende Ersparnis, wenn bereits alle Beispiele jeweils acht Plätze füllen.
Die Strategien unterscheiden sich im Umgang mit langen Texten. In TRL 0.29.0, Funktion pack_dataset, passt bfd ganze Beispiele in freie Plätze ein, schneidet aber den Überhang eines zu langen Beispiels ab; wrapped kann den Text mittendrin teilen. Deshalb müssen sowohl die erhaltenen Daten als auch die Grenzen geprüft werden. Packing ordnet Eingaben für das Training, einschließlich Fine-tuning — der weiteren Anpassung eines Modells anhand von Beispielen. Es vergrößert nicht die maximale Textlänge, die das Modell verarbeiten kann.