Anthropic wydało Claude Haiku 5.5
7 października 2026 Anthropic udostępniło Claude Haiku 5.5, nowy mały model do klasyfikowania, odczytywania dokumentów i wykonywania krótkich zadań pomocniczych. Jest dostępny w aplikacjach Claude oraz przez API, także u dostawców chmury. Stawki za krótkie zapytania spadły dziesięciokrotnie względem Haiku 4.5, a model otrzymał większy kontekst i regulowany poziom rozumowania. To istotna zmiana dla aplikacji wykonujących wiele podobnych operacji, choć oszczędność zależy od długości zapytania i liczby tokenów potrzebnych do odpowiedzi.
Karta systemowa Haiku 5.5 pokazuje duży postęp względem poprzednika, ale pozwala też dokładniej odczytać wyniki premierowe. W teście obsługi komputera 72,4% oznacza średni wynik za wykonane etapy; wszystkie etapy zadania model ukończył w 37,1% prób. Większość wyników uzyskano przy najwyższym poziomie rozumowania, a nie przy ustawieniu domyślnym API.
Dostęp, kontekst i narzędzia
Strona produktu wymienia użytkowników Free, Pro, Max, Team i Enterprise oraz aplikacje internetowe, iOS i Android. Haiku 5.5 działa też w Claude Code. Programiści mogą używać claude-haiku-5-5 w Claude API, Claude Platform on AWS, Google Cloud i Microsoft Foundry; Amazon Bedrock stosuje identyfikator anthropic.claude-haiku-5-5.
Według specyfikacji API model przyjmuje tekst i obrazy, odpowiada tekstem oraz obsługuje wywoływanie narzędzi. Ma 1 mln tokenów kontekstu i limit 128 tys. tokenów wyjściowych. W Message Batches API limit wyjścia można zwiększyć do 300 tys. tokenów przez wersję beta z nagłówkiem output-300k-2026-03-24; nie jest to limit zwykłego żądania synchronicznego. Na Claude API i Google Cloud sterowanie komputerem wymaga nowego zestawu computer_toolset_20260801, a obsługę stron internetowych zapewnia browser_toolset_20260801.
Haiku 5.5 dobiera rozumowanie adaptacyjnie. Parametr output_config.effort oferuje poziomy od low do max, a domyślny poziom API to medium. Wyższe ustawienie może poprawić wynik, ale wydłuża pracę i zwiększa zużycie tokenów. Nie oznacza to, że każde proste zapytanie wymaga długiego rozumowania: przy niższym ustawieniu model może je pominąć.
Dwa progi cenowe i ponowne liczenie tokenów
Poniższe stawki Claude Platform dotyczą miliona tokenów w USD. Odczyt pamięci podręcznej oznacza ponowne wykorzystanie wcześniej przetworzonej części promptu. Dokumentacja cen Haiku 5.5 rozdziela opłaty według długości wejścia.
Zobacz także: Prefix Caching — ponowne użycie obliczeń wspólnego początku promptu.
| Rodzaj tokenów | Haiku 5.5: prompt do 100 tys. | Haiku 5.5: prompt powyżej 100 tys. | Haiku 4.5 |
|---|---|---|---|
| Wejście | 0,10 | 0,50 | 1,00 |
| Wyjście | 0,50 | 2,50 | 5,00 |
| Odczyt pamięci podręcznej | 0,01 | 0,05 | 0,10 |
| Zapis pamięci podręcznej na 5 minut | 0,125 | 0,625 | 1,25 |
Po przekroczeniu progu rośnie również stawka za odpowiedź. Przetwarzanie wsadowe daje 50% rabatu na wejście i wyjście. Tokeny rozumowania wchodzą do rozliczanego wyjścia, więc niski cennik nie określa jeszcze kosztu ukończenia zadania.
Instrukcja migracji podaje, że ten sam tekst zajmuje w nowym tokenizerze około 30% więcej tokenów niż w Haiku 4.5; dokładna różnica zależy od treści. Trzeba ponownie policzyć prompty i limity odpowiedzi, również dlatego, że zapytanie może trafić do droższego przedziału. Deklarowane przez Anthropic średnie obniżenie kosztu o około 75% dotyczy jego rozkładu obciążeń, a nie gwarantowanej oszczędności każdej aplikacji.
Przy tej samej premierze firma obniżyła odczyt pamięci podręcznej Sonnet 5.5 z 0,20 do 0,10 USD za milion tokenów. Zapowiedziała też miesięczne środki na API dla Max i Team. Warunki programu przewidują 100 USD dla Max 5x, 200 USD dla Max 20x oraz wspólną pulę Team zależną od miejsc, do 500 USD. Środki wygasają na końcu cyklu, wymagają powiązania organizacji Claude Platform i nie zwiększają limitów abonamentu ani nie obejmują API innych dostawców chmury.
Obsługa komputera: wynik częściowy i pełne ukończenie
Anthropic przetestowało Haiku 5.5 na 82 zadaniach z podzbioru offline OSWorld 2.1. Agent korzystał z maszyny Ubuntu, zrzutów ekranu, myszy i klawiatury, bez internetu, przy rozdzielczości 1080p i limicie 500 działań. Przy max, w pięciu próbach na zadanie, Haiku uzyskał 72,4% wyniku częściowego i 37,1% pełnych ukończeń. Sonnet 5.5 miał odpowiednio 83,9% i 48,8%. Karta systemowa, sekcja 8.9.3.
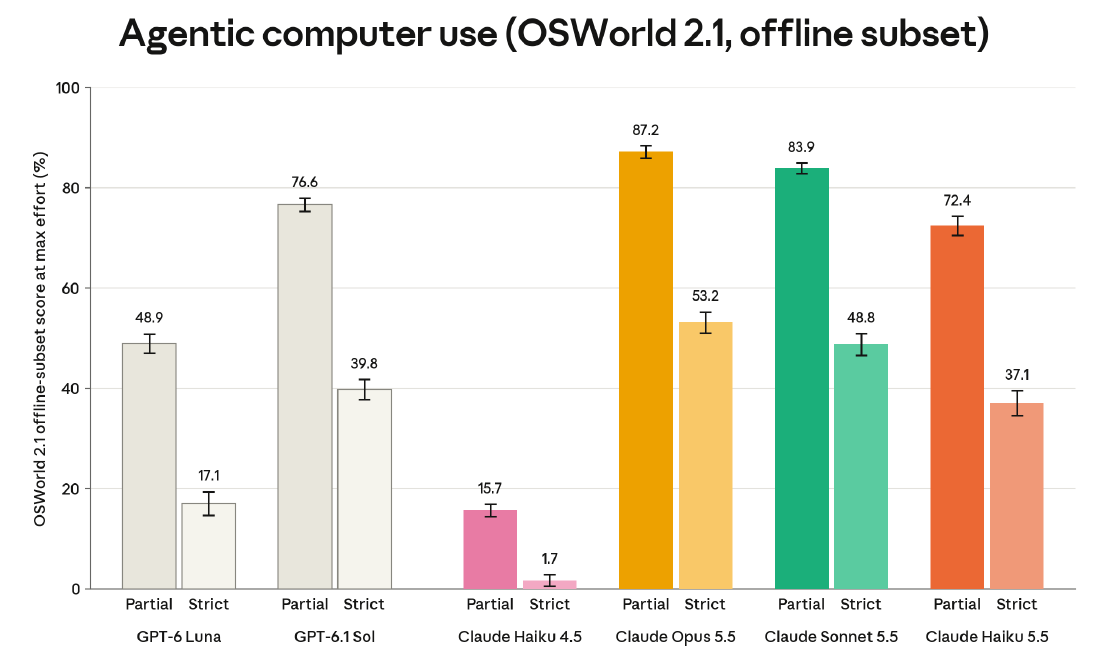
Źródło: Anthropic, karta Haiku 5.5, rys. 8.9.3.A. Dwa słupki pokazują wynik częściowy i odsetek prób spełniających wszystkie kryteria; przedziały ufności 95%, pięć prób na zadanie. Modele pracowały przy max, poza Haiku 4.5 ze stałym budżetem rozumowania. Anthropic testowało GPT przez API OpenAI z jego mechanizmem skracania kontekstu; Haiku 4.5 nie korzystał ze skracania po stronie serwera.
Nowe wyniki pozostałych modeli ponownie zmierzono na tym samym podzbiorze. Nie należy zestawiać ich bezpośrednio ze starszymi wynikami obejmującymi wszystkie 108 zadań ani z OSWorld-Verified. Wynik częściowy nagradza postęp nawet wtedy, gdy agent nie doprowadzi operacji do końca; przy automatyzacji zadań wymagających wszystkich etapów bliższą miarą jest pełne ukończenie.
Kodowanie i praca z dokumentami przy różnych poziomach rozumowania
W Terminal-Bench 4.0 Haiku 5.5 uzyskał 39,2% ±1,9 punktu procentowego błędu standardowego, wobec 0% dla Haiku 4.5 i 70,6% dla Sonnet 5.5. Haiku 5.5 i 4.5 miały po dziesięć prób na każde z 66 zadań; Sonnet miał pięć. Wszystkie działały w Claude Code --bare, przy max dla nowych modeli i budżecie 63 999 tokenów rozumowania dla Haiku 4.5. Haiku 5.5 pracował bez internetu, z wcześniej przygotowanymi zasobami. Jego filtry zatrzymały 12 z 660 prób i każdą zaliczono jako porażkę. Sonnet mógł przekazać część zablokowanych żądań innemu modelowi, więc warunki wdrożeniowe nie były identyczne. Karta, sekcja 8.4.
W FrontierCode 1.1 Main Cognition zmierzyło 46,4% dla Haiku 5.5 przy max. Sonnet 5.5 osiągnął 46,2% przy max, ale 52,1% przy xhigh. Main obejmuje 100 trudniejszych zadań z pełnego zestawu 150, z pięcioma próbami na zadanie. Ocena sprawdza działanie i jakość zmian w repozytorium, karząc także wyjście poza zakres. Modele Claude pracowały w Claude Code, a GPT w Codex — różnych programach prowadzących agenta.
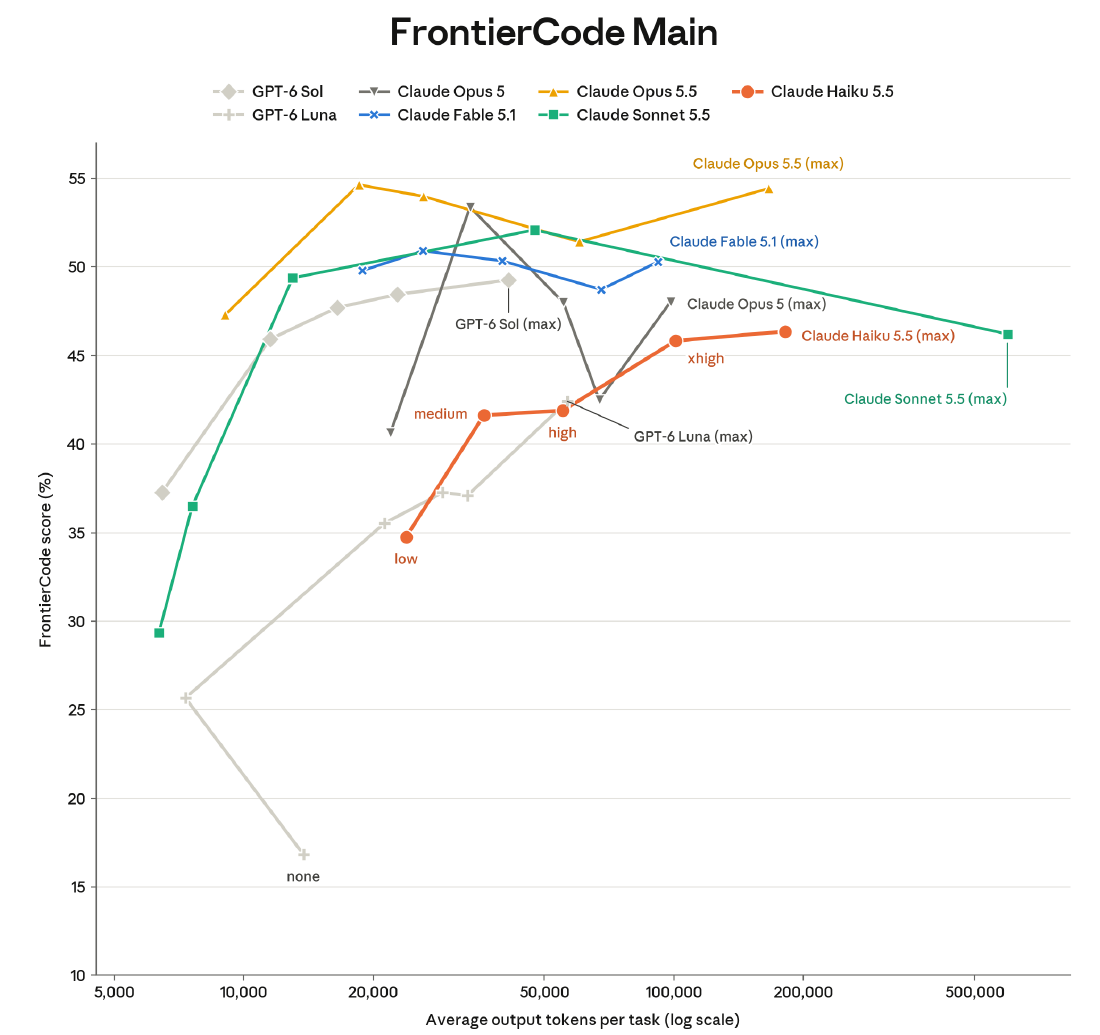
Źródło: Anthropic, karta Haiku 5.5, rys. 8.3.A; pomiary Cognition. Oś pionowa: wynik procentowy, od 10%; pozioma: średnie tokeny wyjściowe na zadanie, w skali logarytmicznej. Punkty odpowiadają poziomom rozumowania. Claude działał w Claude Code, GPT w Codex. Brak przedziałów niepewności; liczba tokenów wyjściowych nie jest pełnym kosztem zadania.
W GDPval-AA v2.1, oceniającym dokumenty, prezentacje i inne rezultaty pracy zawodowej, Artificial Analysis uzyskało dla Haiku 5.5 1620 Elo przy max, ale 1277 przy domyślnym medium, przy około dziesięciokrotnie mniejszej liczbie tokenów wyjściowych. W AA-Briefcase v1.1 odpowiednie wartości to 1578 i 1372. Karta przypisuje oba pomiary Artificial Analysis; są opublikowane w sekcjach 8.10.2–8.10.3. Elo jest oceną z porównań rezultatów, nie odsetkiem rozwiązanych zadań. Analiza The Frontier pokazuje, które wyniki premierowe wymagają zmiany domyślnego ustawienia API.
Niezależne pomiary i ograniczenia pierwszych testów
Artificial Analysis podaje dla Haiku 5.5 przy max 43 punkty w Intelligence Index v4.3.2, średni koszt 0,21 USD na zadanie indeksu i tempo generowania 244,2 tokena na sekundę przez API Anthropic. Metodologia łączy dziesięć ocen, przede wszystkim anglojęzycznych i tekstowych. To osobny zestaw i rachunek niż testy Anthropic. Tempo generowania mierzy etap po rozpoczęciu strumienia odpowiedzi; nie jest czasem od wysłania zapytania do otrzymania gotowego wyniku.
Josef Waples z DataCamp porównał oba Haiku na 24 fakturach, wymagając decyzji o zapłacie, wstrzymaniu lub zwrocie według podanych reguł. Oba modele odpowiedziały poprawnie na wszystkie przypadki. Przebieg Haiku 5.5 kosztował 0,0098 USD, a Haiku 4.5 — 0,25 USD. Nowy model działał przy high, poprzednik z budżetem 16 tys. tokenów rozumowania. Ten niewielki test dokumentuje oszczędność w jednej konfiguracji; nie dowodzi ogólnej przewagi trafności ani stałej relacji kosztów. DataCamp sprzedaje szkolenia z użycia tych narzędzi i przedstawia test w materiale edukacyjnym.
Filtry bezpieczeństwa i odmowy bez modelu zastępczego
Karta Haiku 4.5 opisywała wdrożenie pod standardem ASL-2 i automatyczne testy mające wykluczyć potrzebę silniejszych zabezpieczeń biologicznych. Karta 5.5 stosuje nowszy podział ryzyka: Anthropic traktuje model jako spełniający progi CB-1 i Autonomy-1, związane z możliwą pomocą w nadużyciach chemicznych i biologicznych oraz autonomicznym działaniem w wrażliwych systemach. Nie stwierdza przekroczenia CB-2 ani Autonomy-2. Ponieważ zmieniły się ramy oceny i zestawy zadań, same nazwy progów nie tworzą porównywalnej skali wzrostu ryzyka.
Haiku 5.5 ma filtry blokujące określone szkodliwe zastosowania cybernetyczne i biologiczne. Ograniczenia cybernetyczne są szersze niż u Haiku 4.5, ale węższe niż u Sonnet 5.5. Uprawnione organizacje mogą ubiegać się o szerszy dostęp w programach weryfikacji. W produktach Anthropic i jego API blokada nie przełącza żądania na inny model. Wyniki cybernetycznych zdolności w karcie mierzono z wyłączonymi filtrami, więc nie opisują zwykłego dostępu publicznego.
W teście Shade dotyczącym złośliwych instrukcji ukrytych w otoczeniu kodu atakujący miał po 200 prób w 40 scenariuszach. Bez dodatkowych sond wykrywających takie instrukcje przełamał Haiku 5.5 w sześciu scenariuszach; z sondami — w żadnym. W teście obsługi komputera dwa ataki z 2800 prób nadal się powiodły. Są to wyniki konkretnych testów, a nie gwarancja bezpiecznej pracy na dowolnych plikach lub stronach. Większość ocen bezpieczeństwa wykonało Anthropic; zarówno karta 4.5, jak i karta 5.5 opisują ograniczenie części ocen ryzyka do metod automatycznych.
Producent odnotował też częstsze nieuzasadnione odmowy w automatycznym audycie zachowania niż u wszystkich modeli z tego porównania, w tym Haiku 4.5. Wynik jest inny w osobnym teście pojedynczych nieszkodliwych zapytań, gdzie 5.5 poprawił się względem poprzednika. Zakres testu ma więc znaczenie również przy ocenie nadmiernego blokowania.
Migracja aplikacji z Haiku 4.5
Instrukcja migracji wymaga więcej niż podmiany identyfikatora. Ręczny budget_tokens trzeba zastąpić adaptacyjnym rozumowaniem, usunąć nieobsługiwane ustawienia próbkowania oraz końcową wiadomość asystenta przeznaczoną do kontynuowania przez model. Klient powinien wybierać bloki odpowiedzi według type, ponieważ przed tekstem mogą pojawić się bloki rozumowania. Te tokeny wchodzą do max_tokens; zbyt niski limit może zakończyć żądanie jeszcze przed tekstową odpowiedzią.
Aplikacja musi też obsłużyć stop_reason: "refusal" i aktualne zestawy narzędzi. Przechowywane bloki rozumowania są związane z kontem, które je wytworzyło, oraz poprzednią historią rozmowy. Przeniesienie ich do innego konta lub zmiana wcześniejszych wiadomości wymaga uwzględnienia nowych reguł API. Przy ocenie migracji trzeba zmierzyć koszt i trafność na własnych zadaniach przy docelowym poziomie rozumowania, a osobno policzyć odmowy i zapytania przekraczające próg 100 tys. tokenów.
Źródła
Źródła pierwotne
- Anthropic: premiera Claude Haiku 5.5 i dostępność w aplikacjach.
- Anthropic: karta systemowa Haiku 5.5 i karta Haiku 4.5.
- Claude Platform: specyfikacja i ceny oraz instrukcja migracji.
- Claude Help Center: miesięczne środki na API dla Max i Team.
- Artificial Analysis: wyniki Haiku 5.5 przy max, metodologia Intelligence Index i metodologia pomiarów szybkości.
Niezależne analizy i relacje
- Josef Waples, DataCamp: funkcje, ceny i własny test 24 faktur.
- The Frontier: progi cenowe, poziomy rozumowania i warunki benchmarków.
Wykorzystuję treści generowane przez AI jako część mojego codziennego procesu nauki.