Sequence Packing
Uczysz model pisać krótkie odpowiedzi klientom: „Dziękuję bardzo”, „Nie” i „Tak”. Po podziale na kawałki tekstu, czyli tokeny, przykłady mają umownie 3, 2 i 2 pozycje, wliczając znacznik końca każdego tekstu. Jeśli każdy zapisujesz w osobnym wierszu o ośmiu miejscach, z 24 miejsc tylko siedem zawiera dane. Reszta to padding — wypełnienie, które wyrównuje długości, lecz nie jest treścią do nauczenia. Jak wykorzystać wolne miejsca?
Sequence Packing układa kilka przykładów w jednym ciągu wejściowym, aby ograniczyć wypełnienie podczas treningu. W naszym przykładzie wszystkie trzy mieszczą się w jednym ośmiopozycyjnym wierszu: siedem miejsc z danymi, jedno puste. Nie powstały nowe odpowiedzi; zmieniło się ich ułożenie. Taką rolę opisuje dokumentacja TRL 0.29.0, SFT Trainer, sekcja „Packing”.
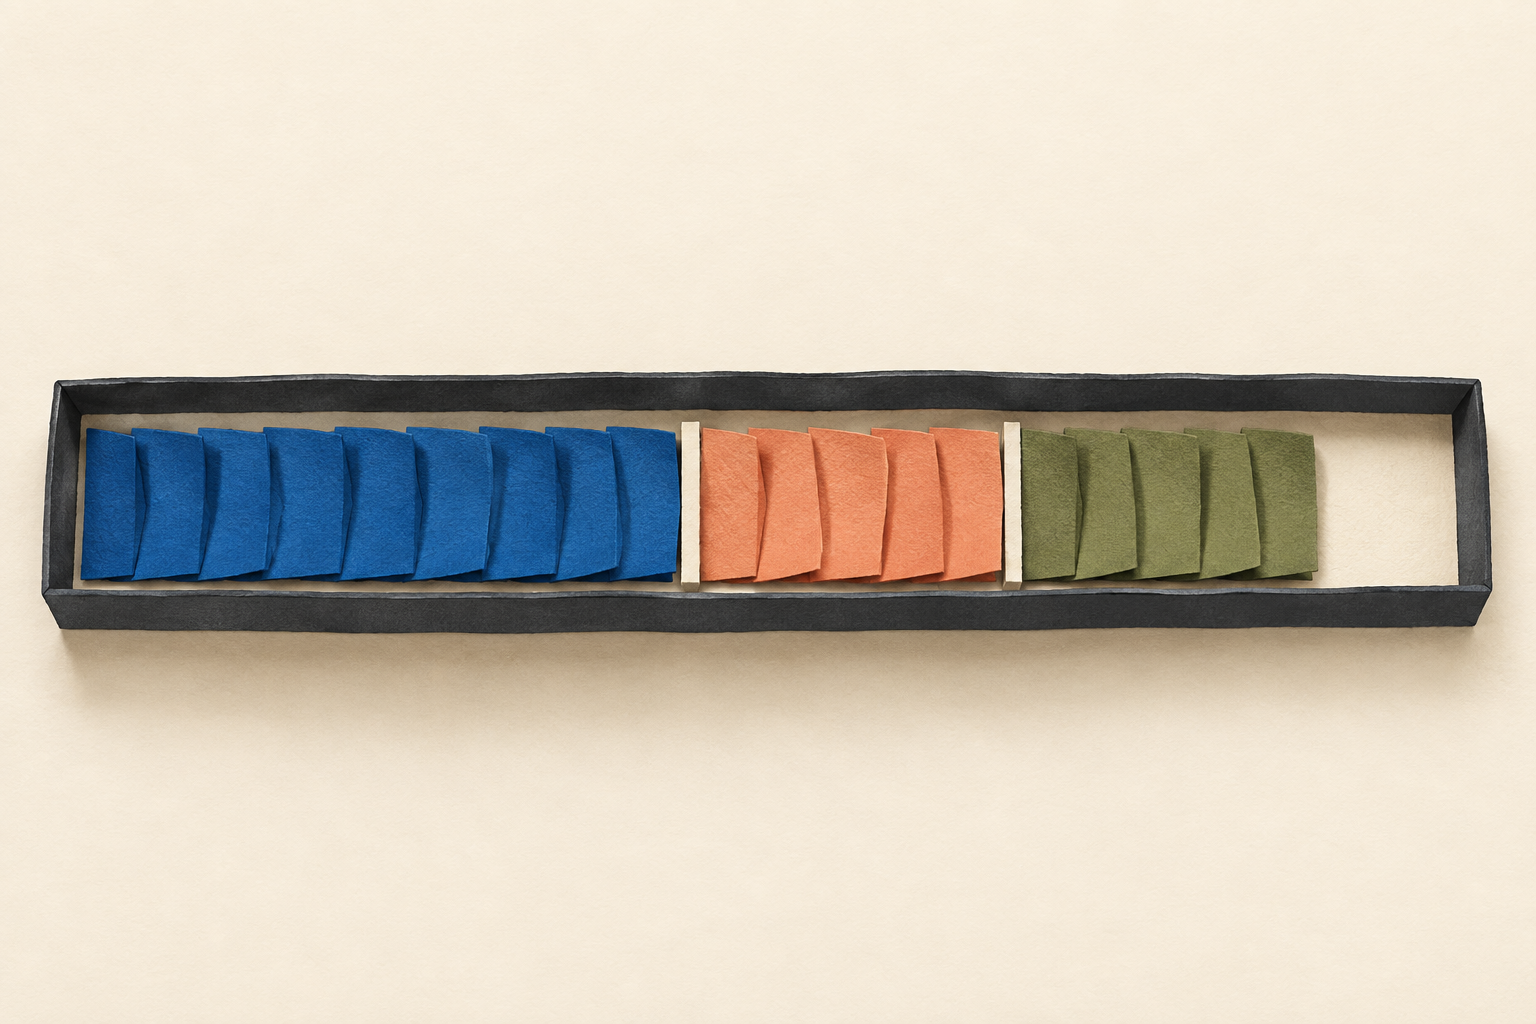
Osiem miejsc to własne uproszczenie, nie domyślny rozmiar wiersza w TRL. Zwykła porcja przykładów może być wyrównana tylko do najdłuższego tekstu; grupowanie podobnych długości także zmniejsza straty miejsca. Już Attention Is All You Need, §5.1, opisuje takie grupowanie. Liczba pustych miejsc sama nie wyznacza przyspieszenia: zależy ono również od sposobu wykonywania obliczeń.
Wspólny wiersz nie musi oznaczać wspólnej rozmowy
Chcesz, żeby „Nie” pozostało niezależnym przykładem, a nie dalszym ciągiem „Dziękuję bardzo”. Sam znacznik końca jest tylko tokenem. Zwykła blokada podglądania przyszłości — Causal Masking — nadal pozwala późniejszemu tekstowi czytać wcześniejszy w tym samym wierszu.
Żeby zachować niezależność, obliczenia muszą znać granice przykładów i blokować dostęp przez te granice. Osobno trzeba dopilnować oceny błędu: nie uczyć przewidywania pierwszego tokena „Nie” z końca poprzedniego tekstu. Wybór ocenianych pozycji to Loss masking; pominięcie kary za pozycję nie blokuje jej czytania.
Konkretnie w kodzie TRL 0.29.0: DataCollatorForLanguageModeling i konfiguracji BFD packing długości przykładów służą odtworzeniu granic, a początki są pomijane w ocenie błędu. Ten przebieg wymaga zgodnej implementacji attention — mechanizmu korzystania z innych pozycji tekstu; kod ostrzega przed przenikaniem informacji przy nieobsługiwanej konfiguracji. To warunek konkretnego rozwiązania, nie własność każdego packing.
Sprawdź dwie osobne rzeczy
Włącz pakowanie, a następnie wyłącz rozdzielenie dostępu. Miejsca pozostaną oszczędzone, ale B1 będzie mogło korzystać z wcześniejszego przykładu A. Kwadraty oznaczają tokeny końca; A1, B1 itd. to umowne kawałki tekstu. Demonstracja pokazuje dozwolone połączenia, bez symulowania odpowiedzi modelu. Wariant „pełne wiersze” ujawnia brak oszczędności, gdy wszystkie przykłady już wypełniają po osiem miejsc.
Strategie różnią się zachowaniem długich tekstów. W TRL 0.29.0, funkcja pack_dataset, bfd dopasowuje całe przykłady do wolnych miejsc, lecz obcina nadmiar zbyt długiego przykładu; wrapped może przeciąć tekst w środku. Dlatego trzeba sprawdzić zarówno zachowane dane, jak i granice. Packing porządkuje wejścia do uczenia, w tym Fine-tuning — dalszego dostosowywania modelu na przykładach. Nie powiększa maksymalnej długości tekstu obsługiwanej przez model.