Anthropic wydało Claude Sonnet 5.5
28 września 2026 Anthropic udostępniło Claude Sonnet 5.5 w aplikacjach Claude, przez API oraz na platformach AWS, Google Cloud i Microsoft. Nowy model kosztuje w API tyle samo co Sonnet 5, ale uzyskuje wyższe wyniki w wielu zadaniach programistycznych. Przy najwyższym poziomie rozumowania może jednak zużyć więcej tokenów i kosztować więcej za ukończone zadanie. Karta systemowa Sonnet 5.5 opisuje warunki testów i zabezpieczenia wdrożenia.
Dostęp, ceny i zmiany w API
Model claude-sonnet-5-5 przyjmuje tekst i obrazy, odpowiada tekstem oraz obsługuje narzędzia. Limit kontekstu to 1 mln tokenów, a zwykłe żądanie może wygenerować do 128 tys. tokenów. Przetwarzanie wsadowe pozwala w wersji beta zwiększyć limit wyjścia do 300 tys. tokenów. Specyfikacja Claude Platform podaje stawki za milion tokenów: 2 USD za wejście, 10 USD za wyjście, 2,50 USD za zapis pięciominutowego bufora promptu i 0,20 USD za odczyt. Godzinny zapis kosztuje 4 USD. Anthropic deklaruje także dostępność opcji bez przechowywania danych.
Komunikat Anthropic potwierdza dostępność w aplikacjach i u wymienionych dostawców chmury, ale nie rozpisuje przypisania Sonnet 5.5 do poszczególnych abonamentów Claude. Domyślny poziom rozumowania wynosi medium w aplikacjach i Claude Code oraz high w API. Pięć poziomów, od low do max, zmienia czas pracy i liczbę tokenów, a więc także rachunek za zadanie.
Przy migracji z Sonnet 5 sama zmiana identyfikatora modelu nie wystarczy każdej aplikacji. Instrukcja Anthropic wymienia parametr between_tools do wyłączenia rozumowania przed pierwszym użyciem narzędzia, błąd przy wymuszeniu wywołania narzędzia i brak obsługi starszej wersji narzędzia sterowania komputerem w Claude API oraz Google Cloud. Bloki rozumowania są powiązane z modelem i historią rozmowy; własny mechanizm skracania tej historii wymaga sprawdzenia przed wdrożeniem.
Wyniki kodowania zależą od poziomu rozumowania i programu agenta
W zestawieniu Anthropic Sonnet 5.5 osiągnął 70,6% w Terminal-Bench 4.0 przy max, wobec 10,3% dla Sonnet 5 i 66,4% dla Opusa 5.5 przy xhigh. Test obejmował 66 zadań w Claude Code --bare, bez połączeń z internetem; nowe modele miały po pięć prób na zadanie. Zabezpieczenia były włączone. Żądania przekazane zastępczemu Sonnet 5 dotyczyły 1,5% przebiegów Sonnet 5.5. Błąd standardowy jego wyniku wynosił 2,5 punktu procentowego, więc różnica względem Opusa 5.5 nie daje tu pewnej przewagi. Karta systemowa, sekcja 8.5.
W FrontierCode v1.1 zadania polegają na przygotowaniu zmian nadających się do włączenia do repozytorium. W pomiarze Cognition obejmującym 150 takich zadań Sonnet 5.5 osiągnął 52,1% przy xhigh i 46,2% przy max. Na najwyższym poziomie częściej uruchamiał przegląd kodu z dodatkowymi agentami; w dwóch analizowanych przypadkach skończyło się to przekroczeniem czasu albo zmianami poza zakresem zadania. Claude działał w Claude Code, a modele GPT w Codex CLI, czyli w innym programie prowadzącym agenta. Wykres pokazuje wynik względem tokenów wyjściowych, a nie pełnego kosztu zadania.
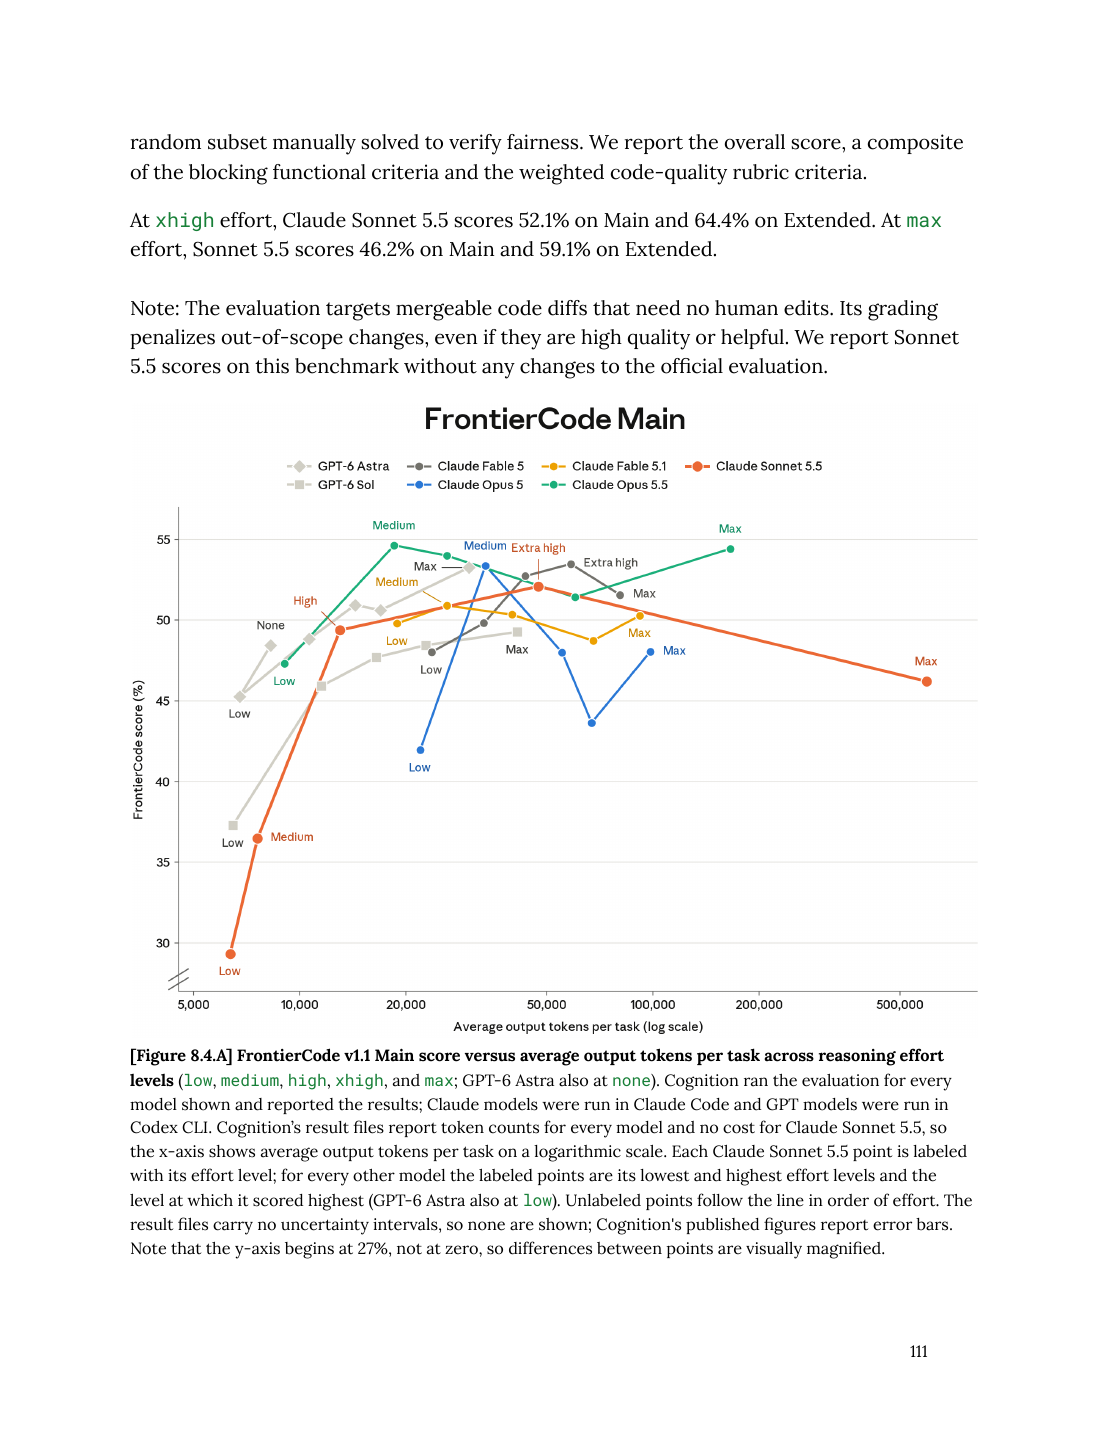
Źródło: Anthropic, karta systemowa Sonnet 5.5, rys. 8.4.A; pomiary Cognition. Oś pionowa: wynik FrontierCode v1.1 Main w procentach, od 27%; pozioma: średnie tokeny wyjściowe na zadanie w skali logarytmicznej. Claude działał w Claude Code, modele GPT w Codex CLI. Wykres nie zawiera przedziałów niepewności.
W CursorBench 4.0, mierzonym przez Cursor w jego środowisku agenta, Sonnet 5.5 uzyskał 55,5% przy max, 53,1% przy xhigh i 47,8% przy high. Opus 5.5 miał 57,8% przy max. Anthropic wyliczyło koszt Sonnet 5.5 z liczby tokenów przekazanej przez Cursor i cen katalogowych.
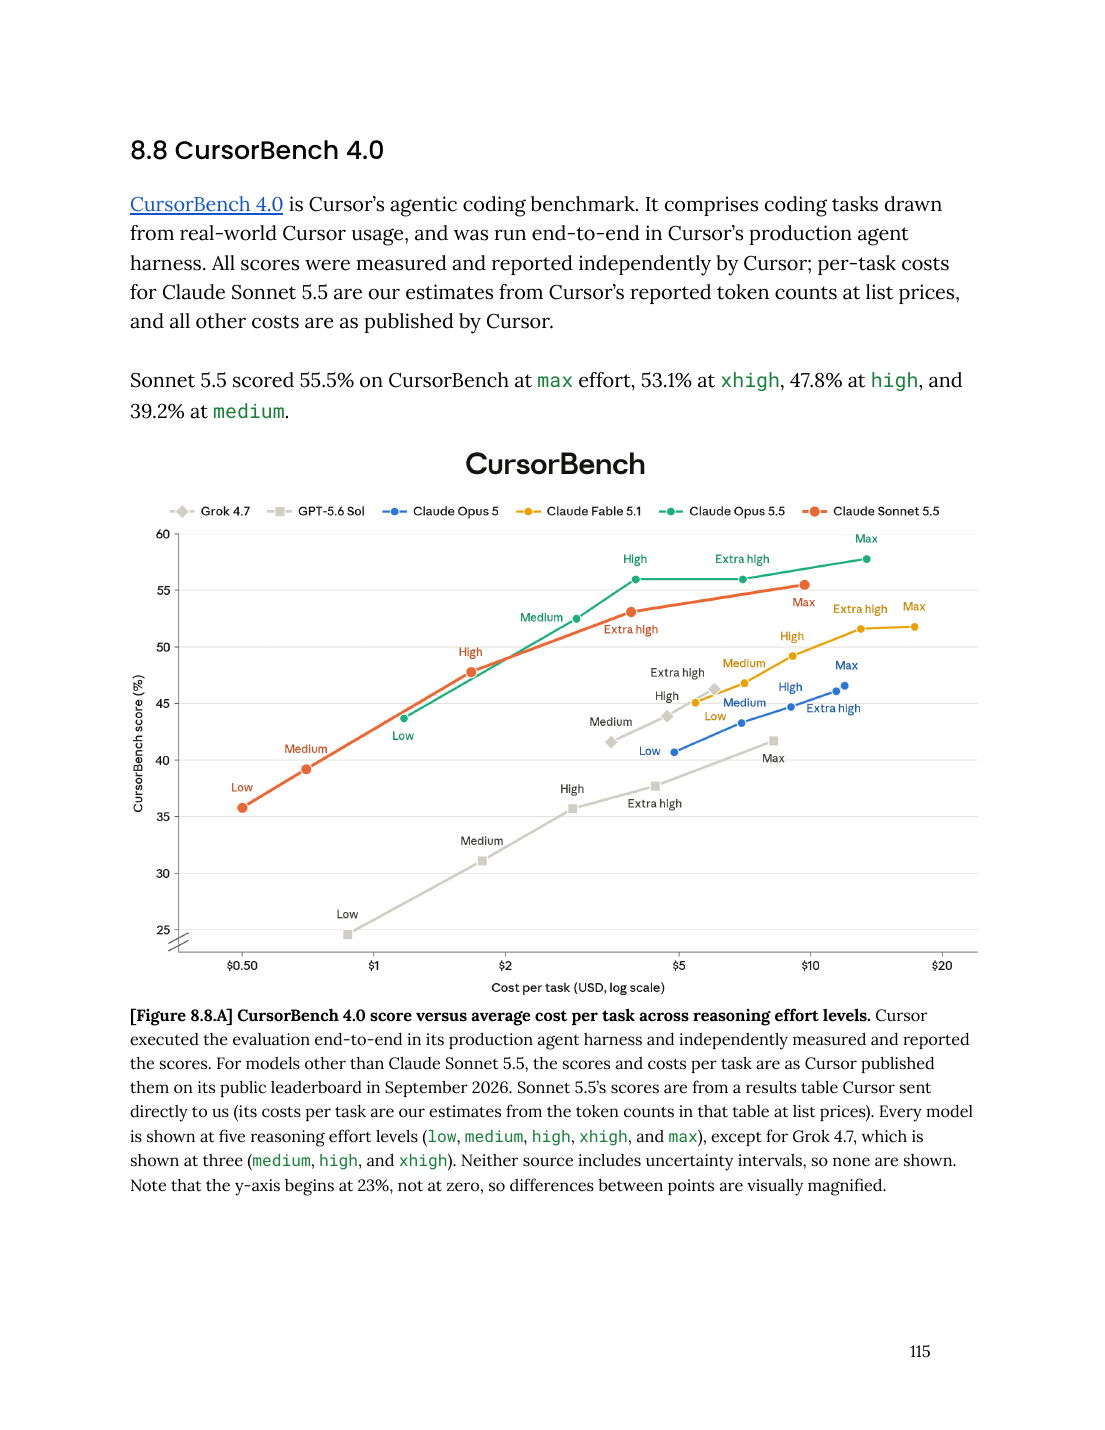
Źródło: Anthropic, karta systemowa Sonnet 5.5, rys. 8.8.A; pomiary Cursor. Oś pionowa: wynik CursorBench 4.0 w procentach, od 23%; pozioma: USD na zadanie w skali logarytmicznej. Koszt Sonnet 5.5 Anthropic oszacowało z tokenów Cursora przy cenach katalogowych; brak przedziałów niepewności.
Niezależne pomiary pokazują koszt najwyższego poziomu rozumowania
Artificial Analysis przy max przyznało Sonnet 5.5 56 punktów w Intelligence Index, o 18 więcej niż Sonnet 5 i o dwa mniej niż Opus 5.5. Nowy Sonnet zużywał w tej konfiguracji średnio około 193 tys. tokenów wyjściowych na zadanie, najwięcej spośród badanych modeli. Średni koszt zadania wyniósł 7,60 USD, około 50% więcej niż dla Sonnet 5. Deklaracja Anthropic o oszczędności do 30% dotyczy jej własnych, typowych zadań; nie opisuje każdego obciążenia ani ustawienia max. Artificial Analysis badało wersję przedpremierową z błędem mogącym pogarszać odpowiedzi o ustrukturyzowanym formacie i zapowiedziało ponowne pomiary wydanej wersji.
Vals AI uzyskało 69,22% ±0,96 punktu w indeksie łączącym zadania z kilku dziedzin, za średnio 20,80 USD na test przy max. Opus 5.5 miał 69,69% za 32,77 USD. To inny zestaw zadań i inny rachunek niż indeks Artificial Analysis. Vals włączyło przełączanie zablokowanych żądań na Sonnet 5. Po zaliczeniu takich przypadków jako porażek wynik Sonnet 5.5 spada do 68,89%; w CyberBench różnica jest większa, z 59,58% do 41,97%. Część odpowiedzi w pierwotnym pomiarze pochodziła więc od Sonnet 5.
Zabezpieczenia cybernetyczne przełączają część żądań na Sonnet 5
W karcie Sonnet 5 Anthropic opisywało słabsze możliwości cybernetyczne i prostszy zestaw ograniczeń. Karta 5.5 podaje znaczny wzrost zdolności tworzenia exploitów, choć nadal niższy niż u Opusa 5.5. Nowy Sonnet używa trzystopniowej kontroli żądań cybernetycznych, podobnej do Opusa 5.5. W produktach Anthropic zablokowane żądanie może zostać jawnie przekazane Sonnet 5; w API programista musi włączyć tę funkcję. Karta uprzedza o częstszych odmowach także przy nieszkodliwych zadaniach bezpieczeństwa. Dotychczasowe ograniczenia biologiczne pozostały, a nowe filtry blokują próby masowego wydobywania rozumowania modelu.
Karta odnotowuje lepszą odporność Sonnet 5.5 na złośliwe instrukcje w kodzie i przeglądarce niż u wcześniejszych Sonnetów, ale także regresję w niektórych testach wieloetapowych dotyczących śledzenia ludzi. Testy bezpieczeństwa są symulacjami, a większość przeprowadzono wewnątrz Anthropic. Przed wdrożeniem warto sprawdzić model na własnych zadaniach przy tym samym oprogramowaniu agenta i poziomie rozumowania oraz osobno policzyć odmowy, przełączenia na Sonnet 5, całkowity koszt i poprawki człowieka.
Źródła
Źródła pierwotne
- Anthropic: premiera Claude Sonnet 5.5.
- Anthropic: karta systemowa Sonnet 5.5 i karta Sonnet 5.
- Claude Platform: specyfikacja Sonnet 5.5 i instrukcja migracji.
Niezależne analizy i relacje
- Artificial Analysis: wyniki, liczba tokenów i koszt zadania.
- Vals AI: wyniki testów i wpływ modelu zastępczego.
Wykorzystuję treści generowane przez AI jako część mojego codziennego procesu nauki.