Chunked Prefill
Serwer już dopisuje odpowiedzi użytkownikom, gdy przychodzi bardzo długi dokument. Przetworzenie go w jednej dużej porcji może zatrzymać bieżące strumienie. Chcesz przeplatać tę nową pracę z dalszym pisaniem odpowiedzi.
Chunked Prefill dzieli przetwarzanie znanego wejścia na mniejsze porcje. Scheduler — program planujący pracę — rozkłada je między iteracjami i może łączyć z krokami generowania dla innych żądań.
Dokument z 1000 tokenami, czyli kawałkami tekstu, można ilustracyjnie obsłużyć w czterech porcjach po 250. Druga porcja nadal korzysta z potrzebnych wyników pierwszej. Nie wyrzucamy wcześniejszej treści i nie skracamy kontekstu modelu.
Mniejsze porcje ułatwiają ograniczenie długich przerw, ale mogą zwiększać narzut i zmieniać czas oczekiwania na pierwszą odpowiedź nowego żądania. Dobór wielkości jest kompromisem. Prefill opisuje etap, a Chunked Prefill sposób jego rozłożenia.
Mechanizm i szczegóły
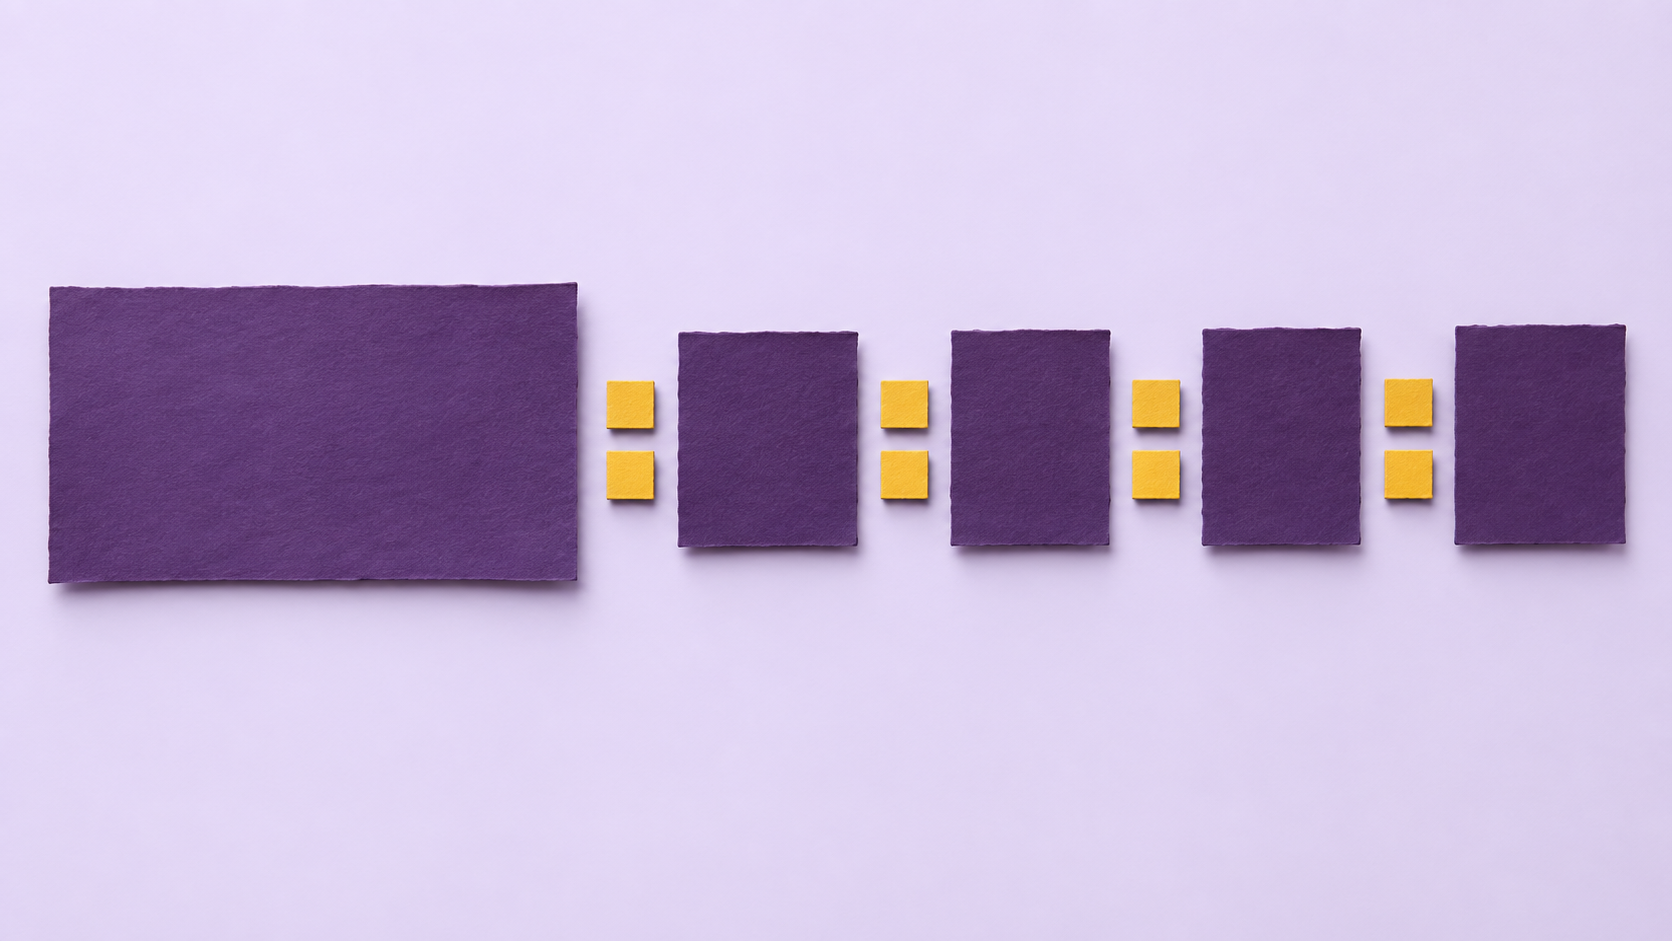
Długi prompt przyjęty do jednej iteracji może opóźnić kolejne tokeny już trwających odpowiedzi. W Sarathi-Serve, §4.1–4.3 i algorytm 3 scheduler najpierw rezerwuje miejsce na aktywne kroki generowania, a pozostały budżet wypełnia porcjami promptów. Autorzy łączą to z mieszaniem obu rodzajów pracy w jednym batchu.
Podziel budżet między trzy żądania
Własny przykład: A i B generują już odpowiedzi, C ma 12 tokenów promptu. Budżet wynosi 8 tokenów wejściowych na iterację. A i B zajmują po jednym miejscu, więc dla C zostaje 6. Dwie iteracje kończą Prefill C, a A i B wykonują po dwa kroki generowania. Przy budżecie 4 dla C zostają tylko dwa miejsca: potrzeba sześciu iteracji. W każdej A i B nadal posuwają się o krok.
W demonstracji zmień budżet, zanim wykonasz kolejną iterację. Zobacz, kiedy C może po raz pierwszy odpowiedzieć. Zliczamy przydzielone pozycje, nie mierzymy milisekund: token promptu i krok generowania mogą mieć różny koszt.
Mniejsza porcja ma swój koszt
Dokumentacja vLLM 0.21.0, „Chunked Prefill” opisuje podobny priorytet i budżet max_num_batched_tokens. Mniejsze porcje mogą poprawić Inter-token Latency trwających odpowiedzi, lecz wydłużyć Time to First Token nowych żądań. Więcej porcji oznacza również narzut uruchomień i ponownych odczytów wcześniejszego cache. Rozmiar dobiera się do modelu, sprzętu i obciążenia; liczba tokenów sama nie gwarantuje czasu iteracji.
Continuous Batching pozwala zmieniać skład batcha między iteracjami. Chunked Prefill dodatkowo ogranicza porcję pracy nad długim promptem wpuszczaną do pojedynczej iteracji.
Wykorzystuję treści generowane przez AI jako część mojego codziennego procesu nauki.