Inter-token Latency
Pierwsze słowo odpowiedzi pojawia się szybko, ale potem czat zastyga na sekundę. Średnia szybkość całej odpowiedzi może wyglądać dobrze, choć czytelnik odczuwa pauzę. Potrzebujesz pomiaru odstępów w strumieniu.
Inter-token Latency (ITL) opisuje czas między kolejnymi tokenami — fragmentami odpowiedzi. Nazwa może oznaczać pojedyncze odstępy lub ich podsumowanie, więc trzeba wskazać sposób liczenia.
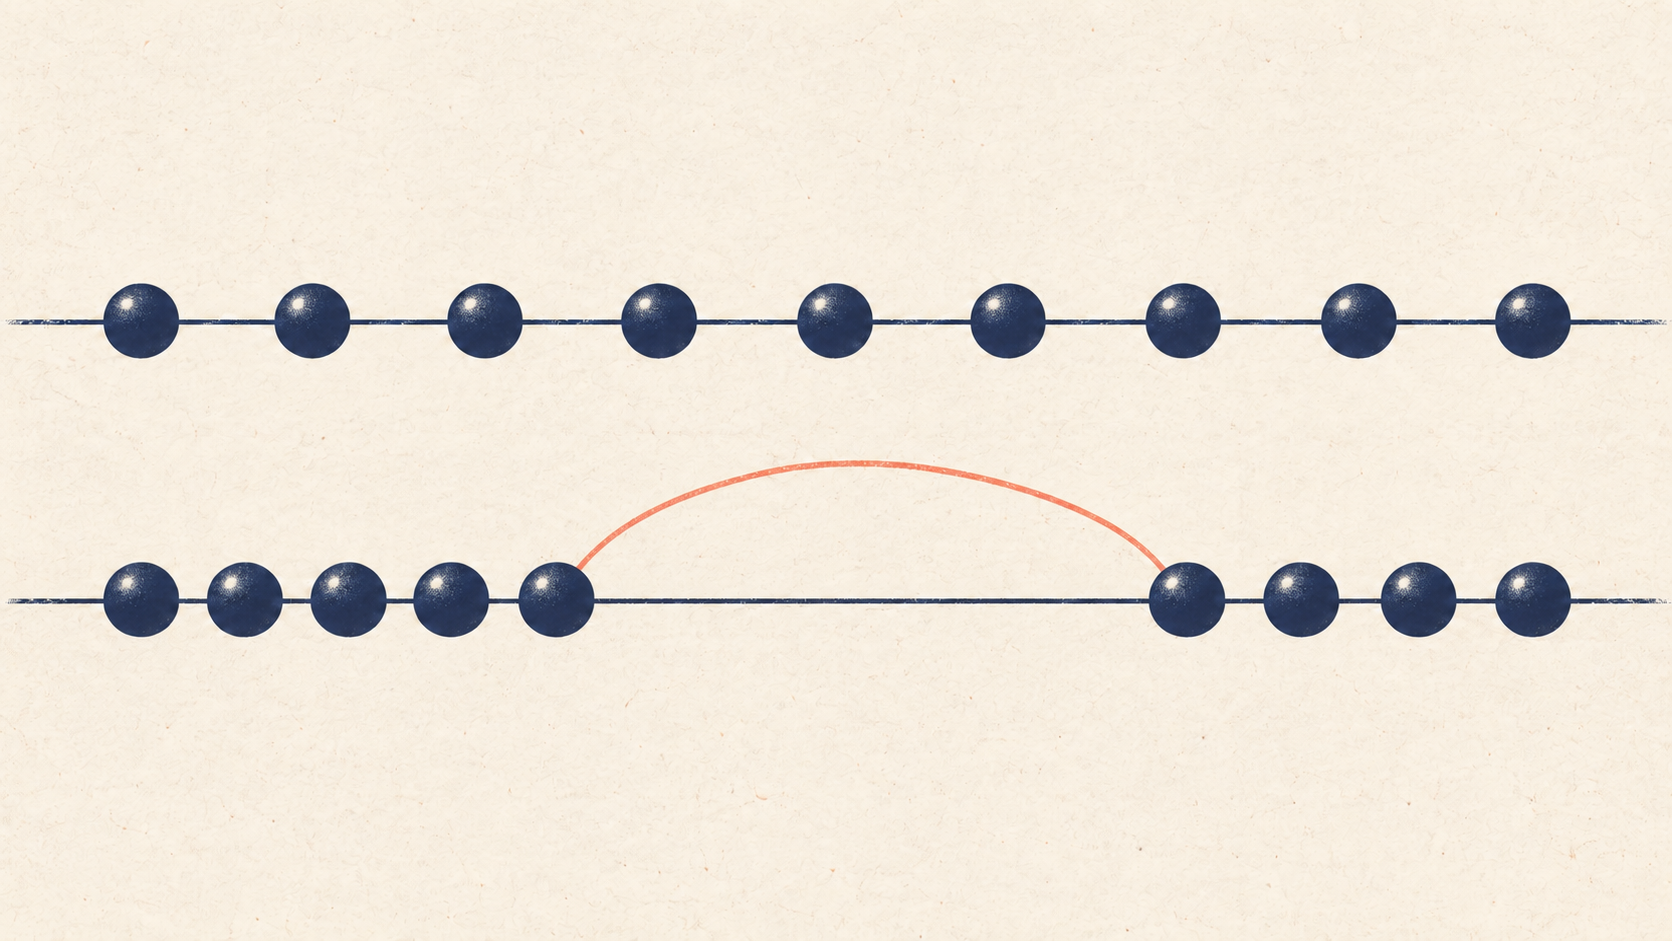
Dla czasów nadejścia 100, 150, 200, 1200 ms odstępy wynoszą 50, 50, 1000 ms. Średnia ukrywa fakt, że jedna pauza jest wyjątkowo długa. Warto więc analizować również rozkład i wysokie percentyle, czyli granice obejmujące większość pomiarów.
Czas oczekiwania na pierwszy fragment to osobne TTFT. Komunikat sieciowy może też zawierać kilka tokenów, dlatego czasu pakietu nie wolno bez objaśnienia traktować jako dokładnego czasu każdego tokena.
Źródło mechanizmu: NVIDIA NIM Benchmarking, „Inter-token Latency”.
Mechanizm i szczegóły
Dla jednej odpowiedzi z tokenami, gdy każdy token ma osobny czas odbioru:
i oznaczają odbiór pierwszego oraz ostatniego tokena. Time to First Token mierzy wcześniejsze oczekiwanie od wysłania żądania. Dodanie tego oczekiwania do licznika zmieni metrykę.
Średnia ukrywa pauzę
Dwa własne ślady pięciu tokenów zaczynają się w 400 ms i kończą w 560 ms. Pierwszy ma odstępy 40, 40, 40, 40 ms. Drugi: 10, 10, 130, 10 ms. Oba dają średnią 40 ms i ten sam czas całej odpowiedzi. W drugim użytkownik doświadcza jednak pauzy ponad trzykrotnie dłuższej niż ta średnia.
Wybierz ślad i odsłoń kolejne odstępy. Czy po poznaniu samego wyniku 40 ms dałoby się odtworzyć taki przebieg?
Token a komunikat strumienia
Klient często odbiera kilka tokenów w jednym komunikacie. Ich indywidualnych czasów powstania nie można odtworzyć z jednego znacznika odbioru. AIPerf, sekcje „Inter Token Latency” i „Inter Chunk Latency” rozdziela średnią normalizowaną liczbą tokenów od odstępów między niepustymi komunikatami. Zapisuj wersję narzędzia, granice pomiaru i sposób agregacji. Percentyl średnich z wielu żądań nie jest percentylem wszystkich odstępów w ich strumieniach.
Obliczenia Decode, scheduler i transport mogą wpływać na rytm odbioru. Chunked Prefill ogranicza porcję nowego promptu współdzielącą iterację z trwającymi odpowiedziami; Disaggregated Serving przenosi te fazy na osobne zasoby.
Wykorzystuję treści generowane przez AI jako część mojego codziennego procesu nauki.