Hasło słownika · · 3 min czytania
ZeRO
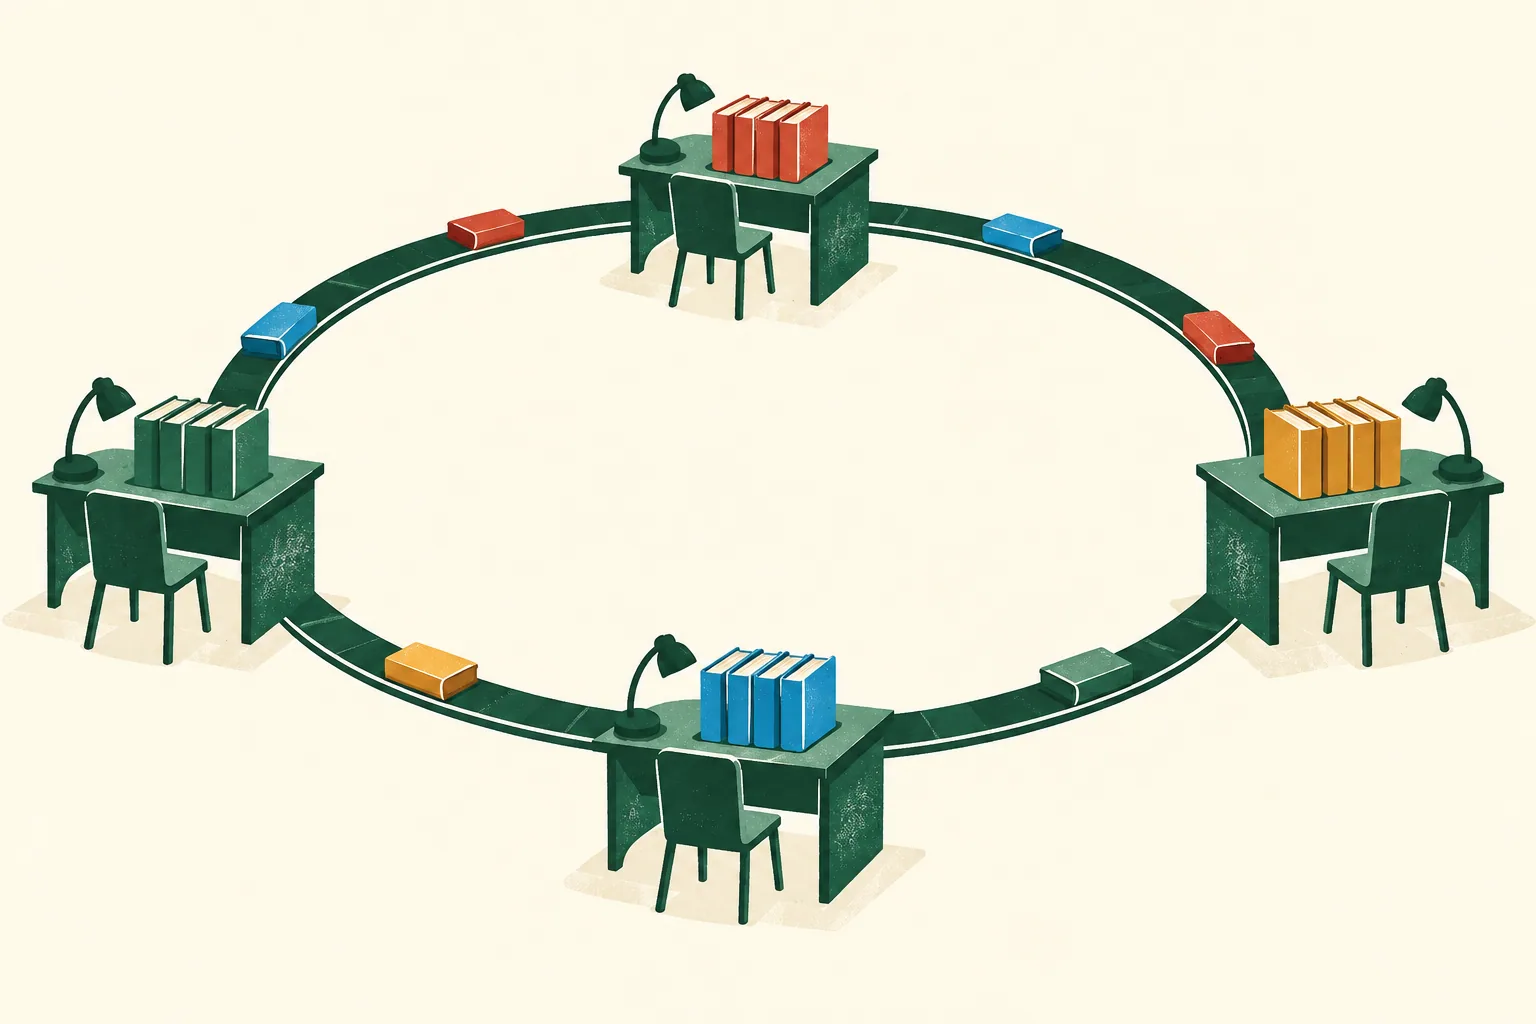
Uczysz model na kilku kartach. Każda przechowuje pełną kopię tych samych wag i pomocniczych danych treningu, więc część pamięci jest wielokrotnie zajęta przez identyczne informacje. Chcesz podzielić te dane bez zamiany pracy w kilka niezależnych treningów.
ZeRO (Zero Redundancy Optimizer) rozdziela wybrane stany treningu między urządzenia. Stan optymalizatora to pamiętane przez algorytm aktualizacji dane, np. średnie gradientów w Adamie. Gradient opisuje wpływ wagi na błąd modelu.
ZeRO-1 dzieli stan optymalizatora. ZeRO-2 dodatkowo dzieli zredukowane gradienty, a ZeRO-3 także wagi. Potrzebne fragmenty są uzgadniane lub zbierane na czas odpowiednich obliczeń.
Zmniejszamy duplikowanie pamięci, ale dokładamy komunikację i organizację danych. ZeRO nie zastępuje Adama nową regułą wyznaczania poprawki ani nie daje automatycznej oszczędności całej pamięci w tej samej proporcji. Pozostają np. wyniki pośrednich obliczeń.
Mechanizm i szczegóły
Przykładem takich pomocniczych danych są dwie statystyki gradientów zapamiętywane dla każdej wagi przez Adama — algorytm obliczający, jak zmieniać wagi podczas nauki. Nazywamy je stanem optymalizatora. Adam określa sposób aktualizacji wag, a ZeRO pozwala rozdzielić potrzebne do niej dane między karty.
Trzy kolejne etapy obejmują coraz więcej danych:
- ZeRO-1: dzieli stan optymalizatora.
- ZeRO-2: dodatkowo dzieli zredukowane gradienty.
- ZeRO-3: dodatkowo dzieli parametry modelu; potrzebne części są zbierane na czas obliczeń i ponownie rozdzielane.
Tak definiuje etapy dokumentacja DeepSpeed. Każdy obejmuje optymalizacje poprzedniego. Offload na CPU lub NVMe jest dodatkową możliwością, nie synonimem ZeRO-3.
Co właściwie znika z pamięci?
W recepturze Mixed Precision Training z optymalizatorem Adam analizowanej przez Rajbhandari et al., §3.1 i §5, na parametr przypada 16 bajtów: 2 na wagę FP16, 2 na gradient oraz 12 na kopię wagi FP32 i dwie statystyki gradientów przechowywane przez Adama. Przy parametrach i procesach idealny rozmiar przechowywanego stanu na proces wynosi:
| Wariant | Bajty na proces |
|---|---|
| Pełne kopie | |
| ZeRO-1 | |
| ZeRO-2 | |
| ZeRO-3 |
Własne podstawienie: miliard parametrów i cztery GPU dają odpowiednio 16, 7, 5,5 i 4 GB na GPU, przy dziesiętnym GB. Zwiększ liczbę GPU w demonstracji: w etapach 1 i 2 pozostaje część niedzielona.
Te liczby nie są szczytowym zużyciem VRAM. Nie obejmują aktywacji, buforów komunikacji ani chwilowego zebrania parametrów. Activation Checkpointing ogranicza inną część rachunku — zapamiętane aktywacje.
Stan potrzebny do obliczeń trzeba dostarczyć. W analizie §7 pracy ZeRO etapy 1–2 zachowują wolumen komunikacji bazowego DP, a etap 3 zwiększa go około 1,5 raza. To model komunikacji z konkretnymi założeniami, nie obietnica czasu treningu. Oszczędność pamięci i szybkość trzeba oceniać osobno.
Zobacz także: Reduce-scatter redukuje gradienty do przydzielonych fragmentów, a All-gather zbiera rozdzielone parametry. Między redukcją gradientów a zebraniem zaktualizowanych parametrów zachodzi krok optymalizatora (§7.2.1 pracy ZeRO).