Hasło słownika · · 2 min czytania
Data Parallelism
Masz dużo danych do treningu i kilka urządzeń. Zamiast przyspieszać pojedynczą warstwę, chcesz, żeby każde urządzenie przetwarzało inne przykłady w tym samym czasie. Wspólnie uczony model powinien jednak pozostać jeden.
Data Parallelism rozdziela dane między kopie modelu. W synchronicznym treningu kopie liczą lokalne gradienty — wskazówki, jak zmiana wag wpływa na błąd — uzgadniają je i wykonują wspólną aktualizację.
Jedna kopia czyta pierwszą porcję tekstu, druga następną. Po połączeniu odpowiednio uśrednionych wkładów obie aktualizują wagi tak samo. Nie tworzymy dwóch niezależnych modeli, których odpowiedzi później głosują.
Każda kopia nadal może potrzebować dużej ilości pamięci, a uzgadnianie wyników kosztuje komunikację. Sam mechanizm synchronizacji nie musi rozdzielać wejściowych danych. ZeRO pozwala dodatkowo ograniczać duplikowanie stanów treningu.
Źródło mechanizmu: PyTorch DistributedDataParallel.
Mechanizm i szczegóły
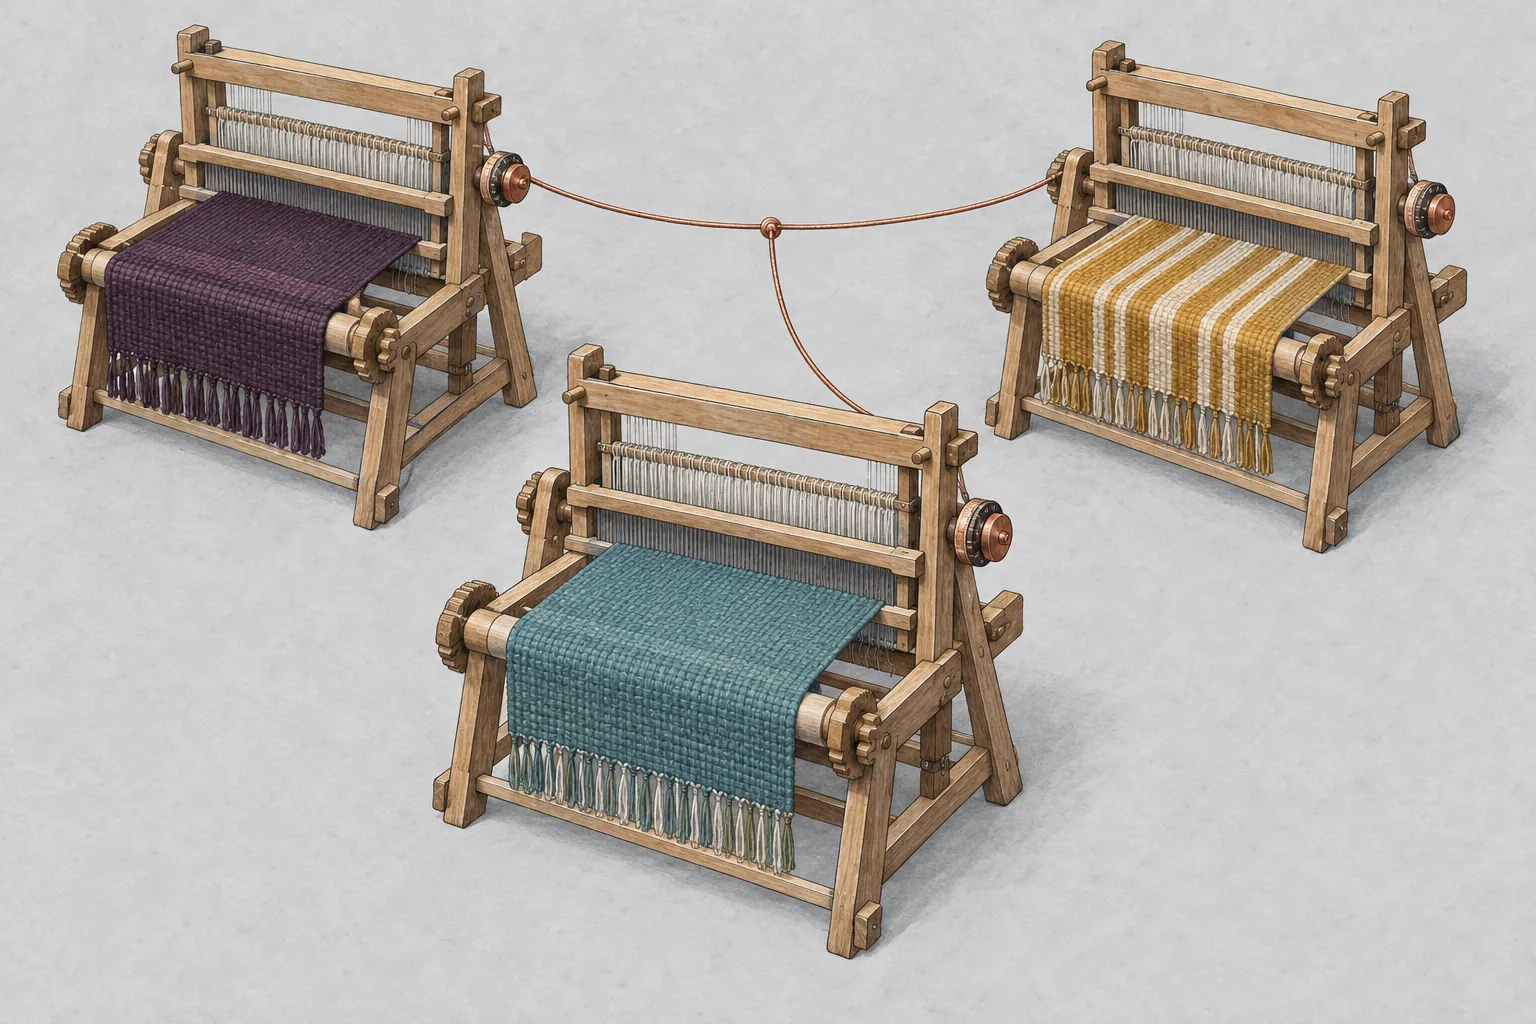
Trzy kopie mają nauczyć się tego samego
Własny przykład sprowadza model do jednego parametru i straty . Gradient wynosi . Trzy repliki dostają cele , więc ich lokalne gradienty to .
Przy kroku uczenia aktualizacja bez uzgodnienia dałaby trzy różne wagi: , i . Średni gradient wynosi jednak , więc każda replika powinna wykonać ten sam krok do . All-reduce może dostarczyć sumę potrzebną do obliczenia tej średniej.
Włącz nierówne porcje: ostatnia replika dostanie cztery przykłady z celem 4. Czy nadal wystarczy średnia trzech lokalnych średnich?
Przy porcjach 1, 1 i 4 gradient średniej straty po wszystkich sześciu przykładach to , a nowa waga wynosi 1,2. Średnia ranków nadal daje −1. To błąd normalizacji, mimo że wszystkie repliki mogą pozostać zgodne. DDP zwykle uśrednia gradienty między rankami; równoważność z jednym dużym batchem zależy także od sposobu liczenia straty i liczby przykładów lub tokenów.
Replika musi się zmieścić
W podstawowym wariancie każda replika przechowuje cały model. Dokładanie GPU nie rozwiązuje więc samo w sobie problemu zbyt dużych wag. Tensor Parallelism dzieli operacje wewnątrz warstw, a Pipeline Parallelism rozdziela grupy warstw. Strategie można łączyć.
Eksperyment pokazuje jeden krok uczenia skalarnej funkcji. Nie mierzy szybkości GPU ani jakości LLM; nie uwzględnia też stanów optymalizatora i kosztu komunikacji.