Hasło słownika · · 2 min czytania
Heteroscedastic Uncertainty
Firma kurierska przewiduje doręczenie dwóch paczek na 12:00. W centrum, przy podobnych adresach i porach nadania, rzeczywiste godziny są zwykle blisko prognozy. Za miastem rozrzut jest większy: w danych brakuje informacji o części lokalnych opóźnień. Jedna miara rozrzutu dla wszystkich paczek ukrywa tę różnicę. Ta sama prognoza nie musi oznaczać tej samej przewidywalności.
Heteroscedastic Uncertainty oznacza modelowanie poziomu szumu jako zależnego od wejścia. Szum to tutaj zmienność wyniku, której nie potrafimy wyjaśnić dostępnymi danymi. Model może więc przypisać różny rozrzut różnym adresom, zamiast używać jednej wspólnej wartości jak w Homoscedastic Uncertainty. Rozróżnienie i sposób uczenia takiego modelu opisują Kendall i Gal, §2.2.
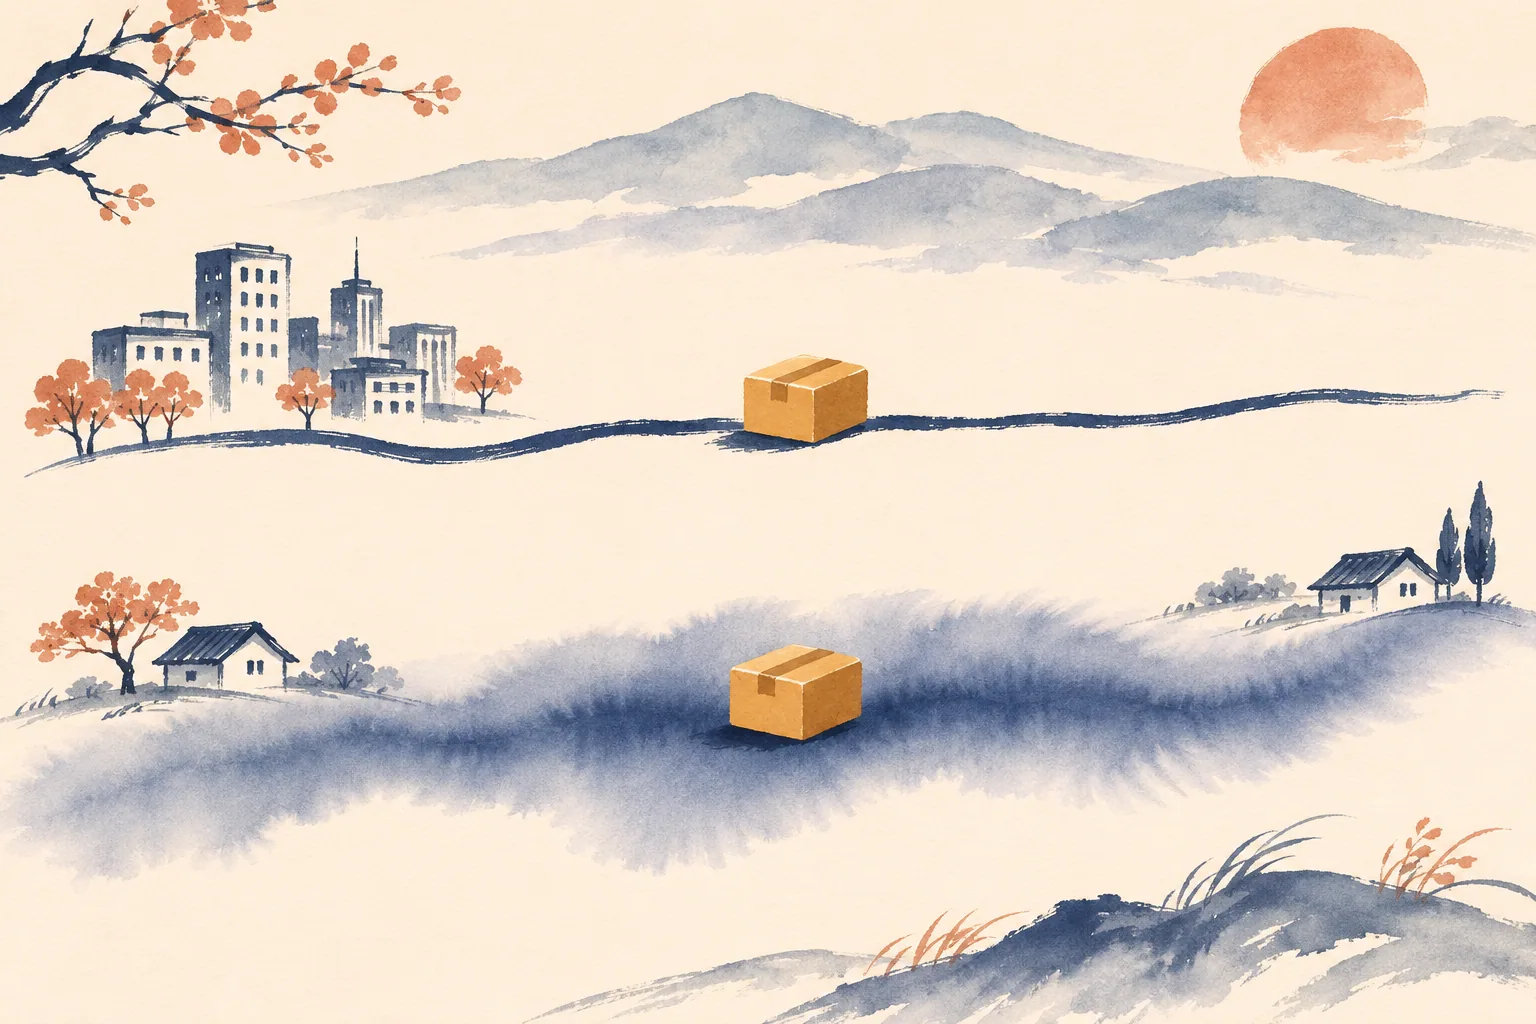
Godzina i rozrzut to dwie informacje
Załóżmy dla przykładu symetryczny, dzwonowy rozkład błędów, czyli rozkład normalny: małe odchylenia są częstsze, duże rzadsze. Jego szerokość opisuje odchylenie standardowe, oznaczane σ. Model zwraca teraz zarówno godzinę, jak i dodatnią wartość σ dla danej paczki.
| Adres | Prognoza | Przewidywany rozrzut |
|---|---|---|
| Centrum | 12:00 | σ = 0,5 godziny |
| Za miastem | 12:00 | σ = 2 godziny |
Godziny i liczby są własnym przykładem, nie pomiarem firmy. Drugi rozrzut jest cztery razy większy, choć środek obu prognoz pozostaje ten sam. Żadna wartość σ nie jest maksymalnym błędem ani gwarancją doręczenia w przedziale „godzina ± σ”.
Skąd model bierze drugą liczbę?
Podczas nauki model widzi dane o wcześniejszych paczkach i ich rzeczywiste godziny doręczenia. Dopasowuje zarówno prognozy, jak i rozrzut. W opisanej metodzie duży błąd przy małym σ mocno podnosi stratę, czyli liczbową ocenę niedopasowania. Zwiększenie σ łagodzi ten składnik, lecz drugi składnik straty karze zbyt szeroki rozrzut. Nie wystarczy więc ogłaszać ogromnej niepewności przy każdej paczce (§3.1, równanie 8, oraz §3.2). To reguła dla przewidywania liczb przy określonym rozkładzie, nie dowolny wskaźnik pewności chatbota.
Ograniczenie: rozrzut zależny od adresu nie gwarantuje rozpoznania zupełnie nowego kraju, którego model nie widział podczas nauki. Opisuje szum, a sam nie mierzy niewiedzy o ustawieniach modelu; autorzy oddzielają te źródła niepewności w §2.2–3.1. W praktyce warto sprawdzić na Test Set, czyli odłożonych przykładach do końcowej oceny, czy zapowiadany rozrzut odpowiada rzeczywistym błędom. Paper bada obrazy; paczki są analogią, a nie wynikiem dotyczącym LLM.
Tekst i ilustrację przygotowano z pomocą AI. Przykład doręczeń jest uproszczeniem edukacyjnym.