Glossarbegriff · · 3 Min. Lesezeit
Heteroscedastic Uncertainty
Ein Kurierunternehmen sagt für zwei Pakete eine Zustellung um 12:00 Uhr voraus. Im Stadtzentrum liegen die tatsächlichen Zeiten bei ähnlichen Adressen und Versandzeiten meist nahe an der Prognose. Außerhalb der Stadt ist die Streuung größer: Die Daten enthalten keine Informationen über manche örtlichen Verzögerungen. Ein gemeinsames Streuungsmaß für alle Pakete verdeckt diesen Unterschied. Dieselbe Prognose muss nicht dieselbe Vorhersagbarkeit bedeuten.
Heteroscedastic Uncertainty bedeutet, den Rauschpegel als abhängig von der Eingabe zu modellieren. Rauschen bezeichnet hier Schwankungen des Ergebnisses, die sich mit den verfügbaren Daten nicht erklären lassen. Das Modell kann verschiedenen Adressen daher unterschiedliche Streuungen zuordnen, statt einen gemeinsamen Wert wie bei Homoscedastic Uncertainty zu verwenden. Kendall und Gal, §2.2 beschreiben diese Unterscheidung und das Training eines solchen Modells.
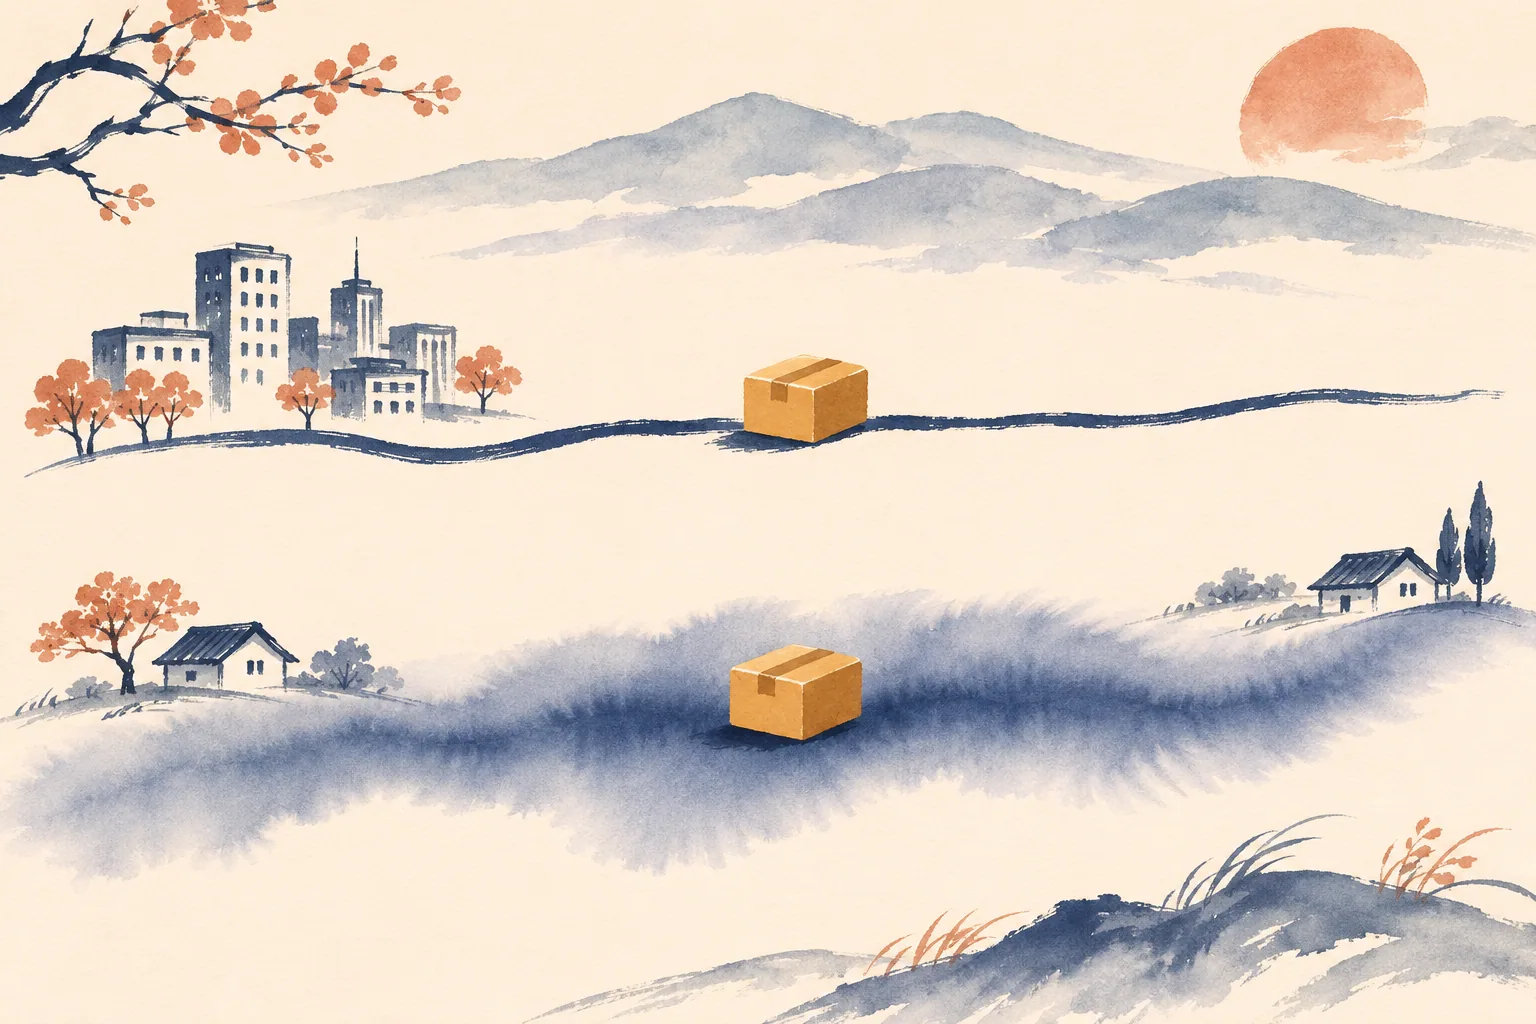
Uhrzeit und Streuung sind zwei Informationen
Nehmen wir als Beispiel eine symmetrische, glockenförmige Fehlerverteilung an, eine Normalverteilung: Kleine Abweichungen sind häufiger, große seltener. Ihre Breite beschreibt die Standardabweichung, bezeichnet mit σ. Das Modell gibt nun sowohl eine Uhrzeit als auch einen positiven σ-Wert für das jeweilige Paket aus.
| Adresse | Prognose | Vorhergesagte Streuung |
|---|---|---|
| Stadtzentrum | 12:00 | σ = 0,5 Stunden |
| Außerhalb der Stadt | 12:00 | σ = 2 Stunden |
Die Zeiten und Zahlen sind ein eigenes Beispiel, keine Messwerte eines Unternehmens. Die zweite Streuung ist viermal so groß, obwohl die Mitte beider Prognosen gleich bleibt. Kein σ-Wert ist ein maximaler Fehler oder eine Garantie für die Zustellung im Intervall „Uhrzeit ± σ“.
Woher nimmt das Modell die zweite Zahl?
Beim Training sieht das Modell Daten früherer Pakete und deren tatsächliche Zustellzeiten. Es passt sowohl die Prognosen als auch die Streuung an. Bei der beschriebenen Methode erhöht ein großer Fehler bei kleinem σ stark den Loss, eine numerische Bewertung der Abweichung. Ein größeres σ schwächt diesen Bestandteil ab, doch ein zweiter Bestandteil des Loss bestraft eine zu breite Streuung. Es genügt also nicht, für jedes Paket enorme Unsicherheit anzugeben (§3.1, Gleichung 8, und §3.2). Das ist eine Regel für die Vorhersage von Zahlen bei einer bestimmten Verteilung, kein beliebiger Vertrauenswert eines Chatbots.
Einschränkung: Eine adressabhängige Streuung garantiert nicht, dass ein völlig neues Land erkannt wird, das dem Modell beim Training nie begegnet ist. Sie beschreibt Rauschen und misst allein nicht die Unsicherheit über die Einstellungen des Modells; die Autoren unterscheiden diese Unsicherheitsquellen in §2.2–3.1. In der Praxis sollte man an einem Test Set, also für die abschließende Bewertung zurückgehaltenen Beispielen, prüfen, ob die angekündigte Streuung zu den tatsächlichen Fehlern passt. Die Arbeit untersucht Bilder; die Pakete sind eine Analogie, kein Ergebnis über LLMs.
Text und Illustration wurden mit KI-Unterstützung erstellt. Das Zustellbeispiel ist eine didaktische Vereinfachung.