Mistral udostępnił Large 4 przez API
Mistral udostępnił 6 października 2026 roku publiczną wersję testową Mistral Large 4. Model przyjmuje tekst i obrazy, generuje tekst i obsługuje pracę z narzędziami. Komunikat premierowy zapowiada udostępnienie wag pod koniec miesiąca; dziś można korzystać z API przez Mistral Studio. Własne wdrożenie pozostaje zapowiedzią.
Karta modelu w dokumentacji opisuje architekturę Mixture-of-Experts: przy przetwarzaniu tokenu model uruchamia część dostępnych sieci eksperckich. To kolejny duży model europejskiego producenta, który ma być dostępny także poza jego usługą. W rozmowie z Axios Pierre Stock przyznał jednak, że Mistral nadal nie dorównuje czołowym modelom zamkniętym.
Dostęp, ceny i rozbieżności w specyfikacji
Dokumentacja podaje identyfikator mistral-large-4, obsługę wywołań funkcji oraz odpowiedzi o zadanej strukturze. Dziennik zmian potwierdza dwutygodniową obniżkę cen o połowę:
| Milion tokenów | Cena katalogowa w USD | Cena premierowa w USD |
|---|---|---|
| Wejście | 1,36 | 0,68 |
| Wejście z pamięci podręcznej | 0,14 | 0,07 |
| Wyjście | 4,18 | 2,09 |
Komunikat podaje bilion parametrów i 49 mld aktywnych, a karta produktu — 1,05 biliona i 52 mld aktywnych. Karta deklaruje kontekst 1 mln tokenów, podczas gdy Artificial Analysis opisuje oceniany model z oknem około 524 tys. Materiały nie wyjaśniają tych różnic. Nie należy traktować ich jako jednej potwierdzonej konfiguracji ani zakładać, że każda usługa udostępnia milion tokenów. Karta produktu nie określa też jednoznacznie maksymalnej długości odpowiedzi.
Wyniki kodowania i koszt rozumowania
Mistral publikuje następujące wyniki wersji Preview:
| Ewaluacja | Wynik |
|---|---|
| DeepSWE 1.1 | 61,7% |
| SWE-Atlas-QnA | 59,4% |
| Terminal-Bench 4 | 28,3% |
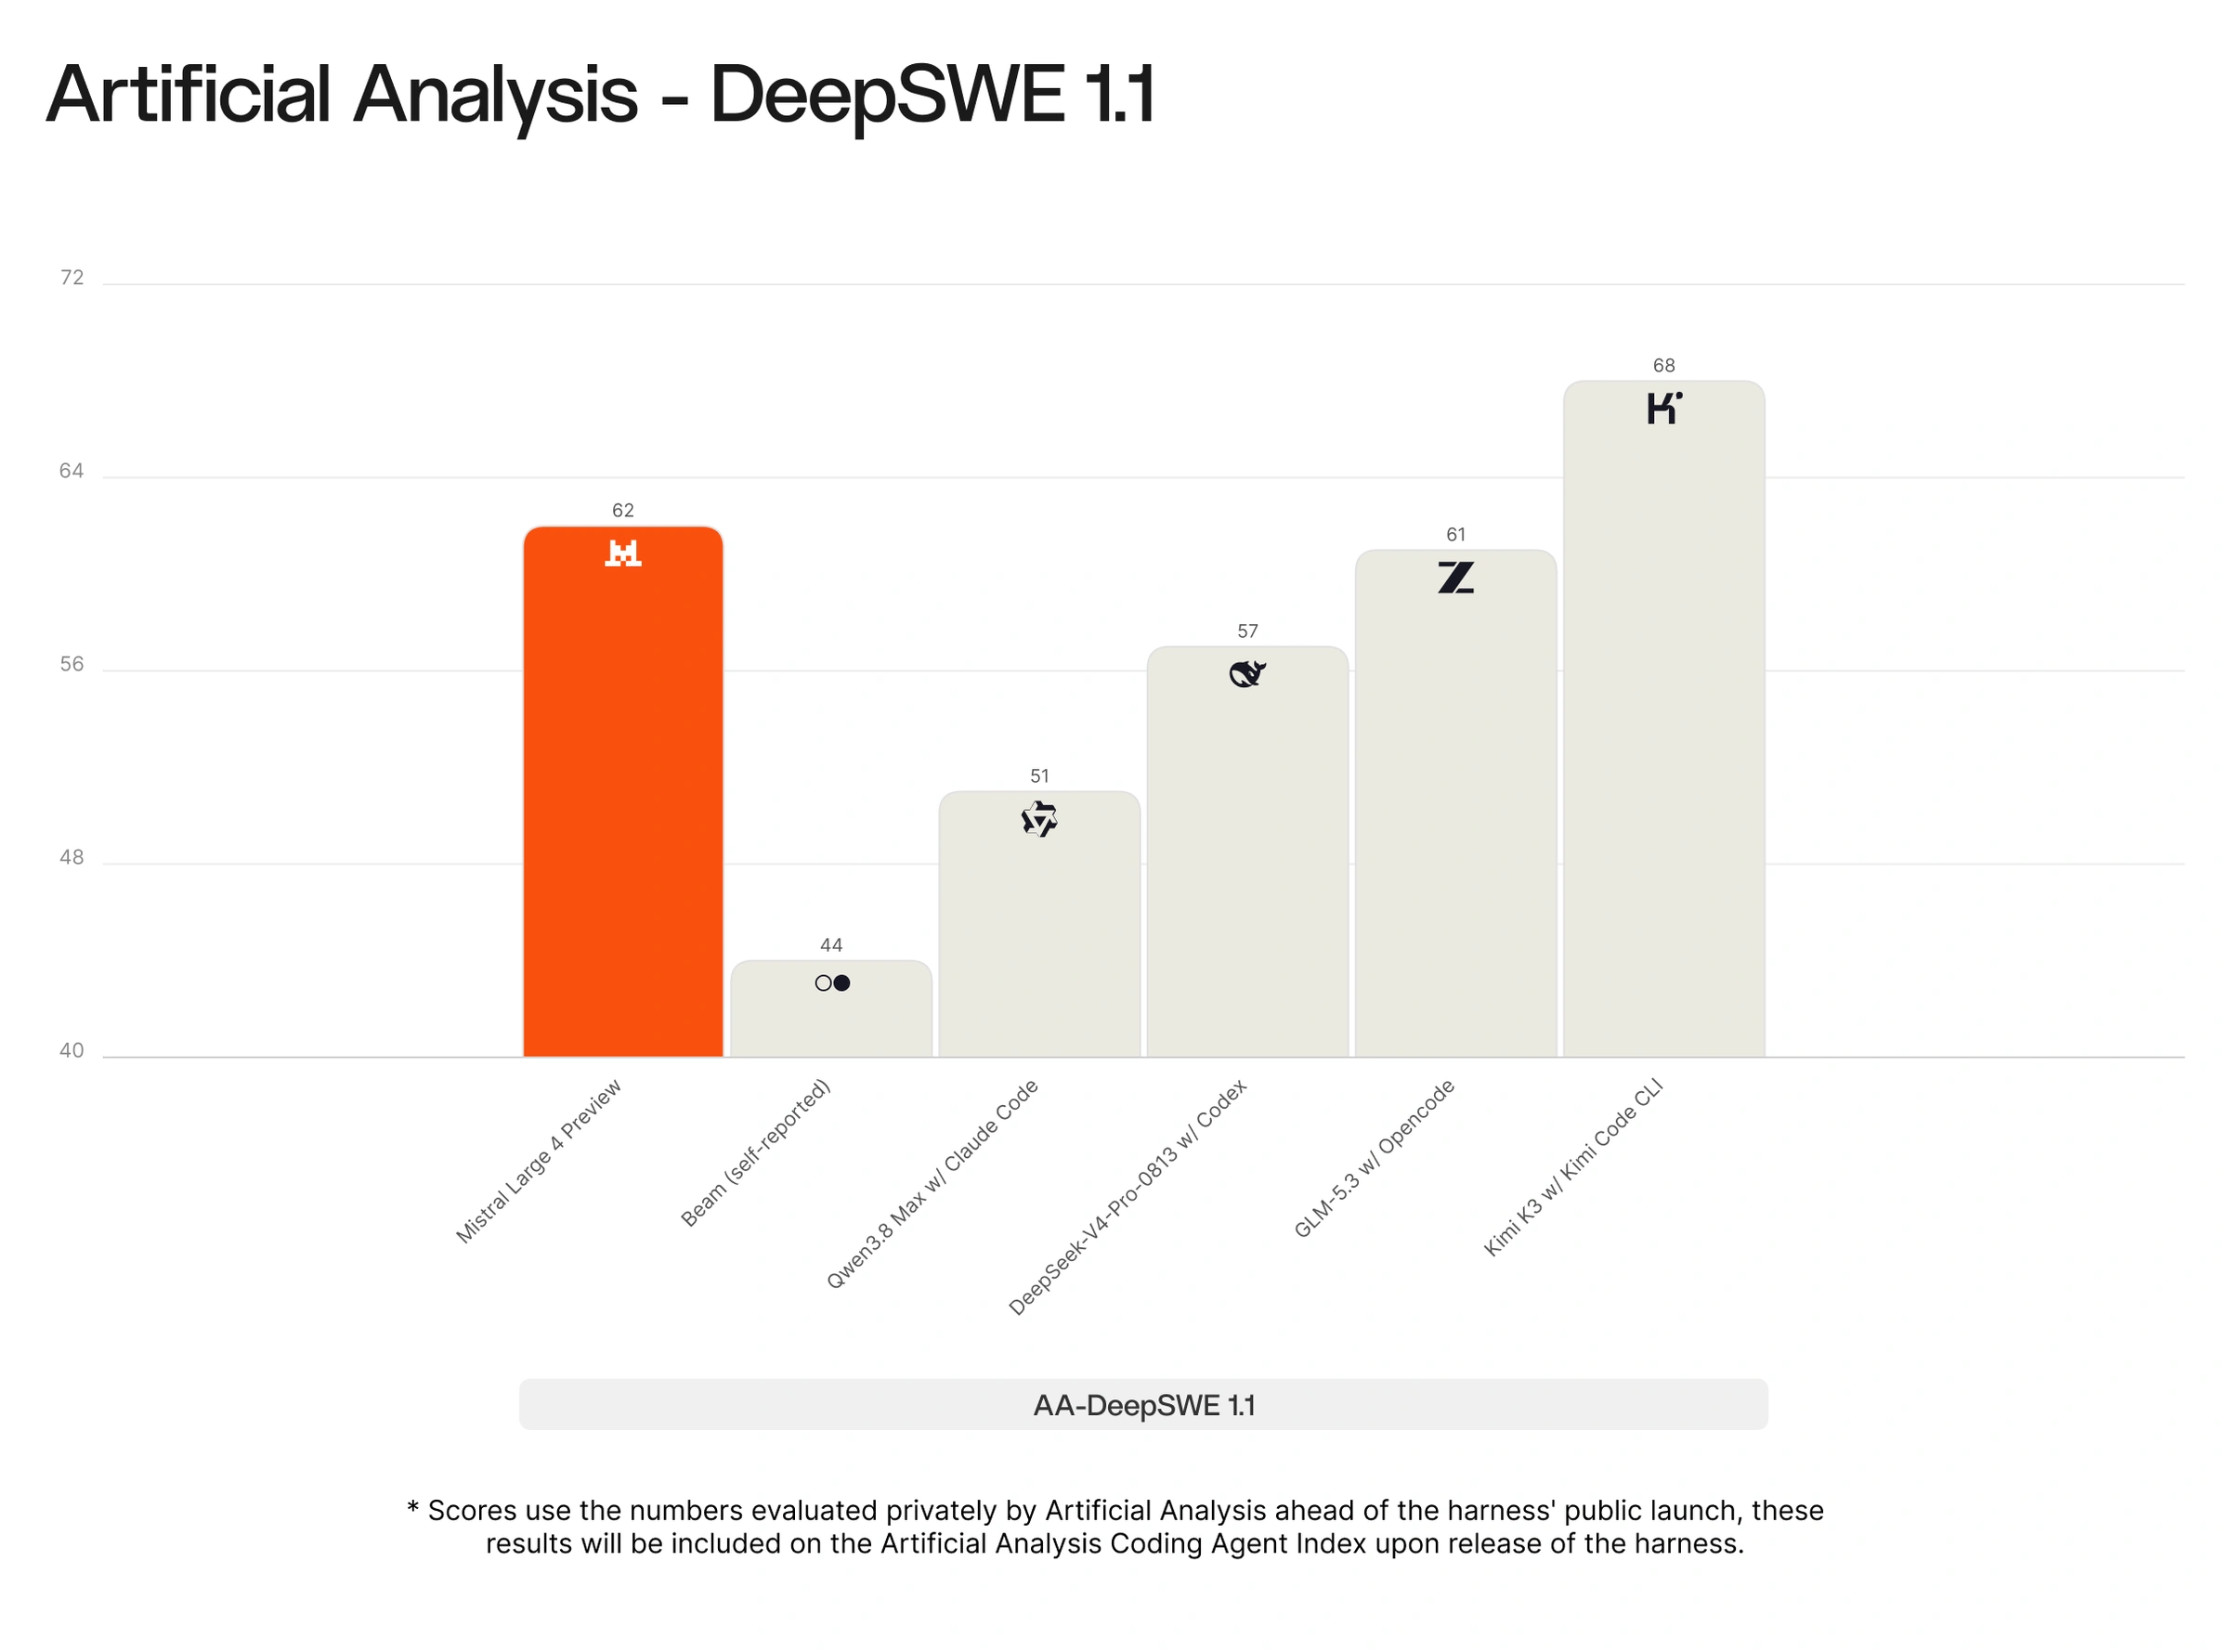
Źródło: Mistral, DeepSWE 1.1, odsetek rozwiązanych zadań; wynik Preview zaokrąglono do 62%. Przypis opisuje prywatną ewaluację Artificial Analysis przed publicznym wydaniem środowiska testowego. Porównywane modele korzystają z różnych programów prowadzących pracę agentów; wynik Beam jest oznaczony jako deklarowany przez jego producenta.
Wykres porównuje systemy z Claude Code, Codex, OpenCode i Kimi Code CLI. Bez odtworzenia środowiska pracy agenta, narzędzi i budżetu nie można przypisać różnic samym modelom. Komunikat nie podaje kompletnej receptury ani ustawienia wysiłku rozumowania dla tych trzech pomiarów.
Artificial Analysis niezależnie ocenia wersję rozumującą na 38 punktów w Intelligence Index v4.3.2. W zestawie dziesięciu ewaluacji model wygenerował łącznie 200 mln tokenów wyjściowych; podany średni ważony koszt zadania wynosi 1,13 dolara. Strona stosuje ceny katalogowe 1,36 i 4,18 dolara, więc tej wartości nie należy przenosić bez przeliczenia na promocję. Metodyka indeksu opisuje zestaw zadań; wynik zbiorczy nie jest procentem poprawnych odpowiedzi ani pomiarem kosztu konkretnej aplikacji.
Zabezpieczenia i warunki przyszłego wdrożenia
Mistral raportuje 93,3% odporności na ataki w B3 Agent Security Benchmark. Odnośnik producenta prowadzi do publicznego zbioru Lakera „weak”, zawierającego 630 ataków z dziesięciu aplikacji. Komunikat nie przedstawia pełnej konfiguracji próby; nie jest to niezależny audyt bezpieczeństwa wdrożeń klientów.
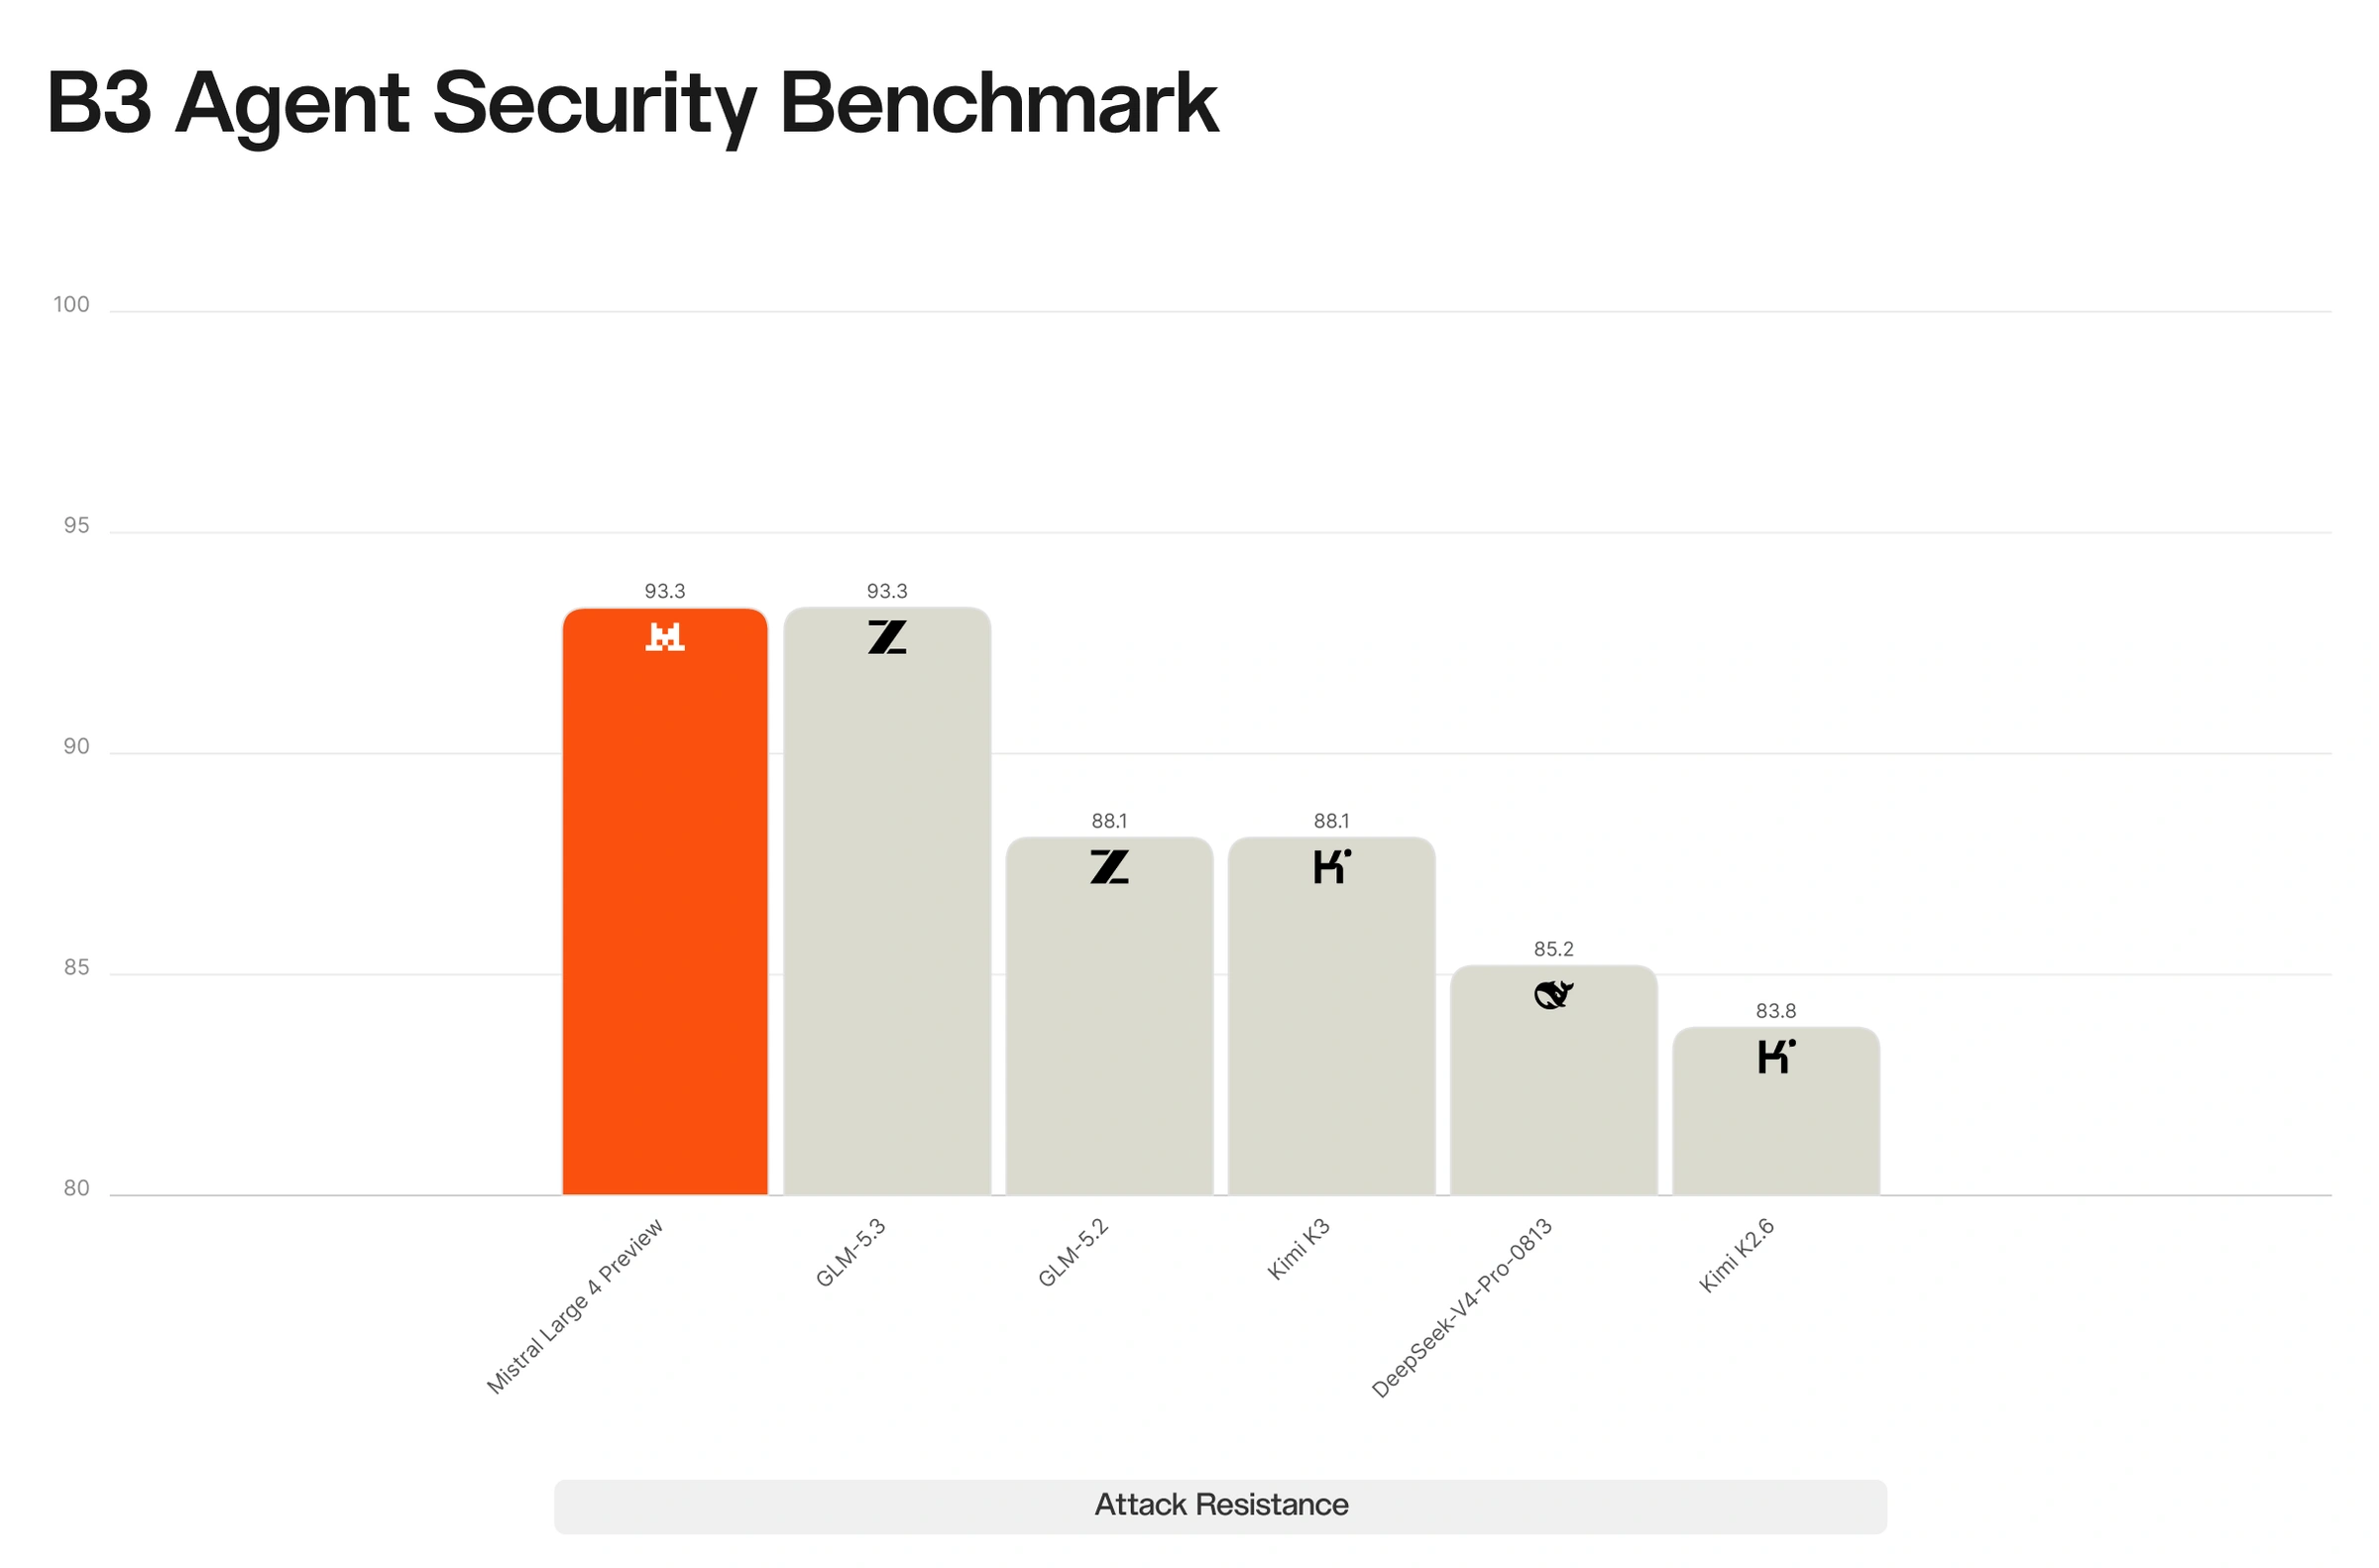
Źródło: Mistral, B3 Agent Security Benchmark, odsetek odpartych ataków. Wyniki producenta dla wersji Preview; wykres nie podaje ustawienia rozumowania ani pełnej konfiguracji agenta.
Przed udostępnieniem wag wybrani partnerzy i instytucje państwowe mają testować wariant z ograniczoną moderacją i rozszerzonymi możliwościami cybernetycznymi. Takie warunki różnią się od publicznego API. Opublikowanych wyników nie należy automatycznie przypisywać obu wariantom.
Karta poprzednika, Large 3 Instruct 2512, podawała 675 mld parametrów, 41 mld aktywnych, kontekst 256 tys. i licencję Apache 2.0. Wymieniała brak dedykowanego rozumowania, słabsze wyniki od modeli wyspecjalizowanych w obrazach oraz trudność efektywnego wdrażania. Dokumentowała też uruchomienie FP8 na ośmiu H200 i konieczność konfiguracji parsera narzędzi. Tych wymagań sprzętowych ani licencji nie można przenieść na Large 4: wagi i odpowiadające im warunki użycia nie zostały jeszcze udostępnione.
„Le Monde” relacjonuje plany dalszego rozwoju na tej samej architekturze. Ocena własnego wdrożenia wymaga opublikowanych wag, licencji i pomiarów docelowej wersji.
Źródła
Źródła pierwotne
- Mistral, komunikat o premierze i oficjalne wykresy Large 4.
- Mistral, karta Large 4 i dziennik zmian z zasadami promocji.
- Mistral, karta Large 3 Instruct 2512.
- Artificial Analysis, pomiar Large 4 Preview i metodyka Intelligence Index.
- Lakera, opis publicznego zbioru ataków B3 „weak”.
Niezależne analizy i relacje
- Ina Fried, Axios, nowe modele i rozmowa z Pierre’em Stockiem.
- Alexandre Piquard, „Le Monde”, premiera Large 4 i plany Mistrala.
Wykorzystuję treści generowane przez AI jako część mojego codziennego procesu nauki.