Anthropic wydało Claude Opus 5.5
22 września 2026 Anthropic udostępniło Claude Opus 5.5 w płatnych planach Claude Pro, Max, Team i Enterprise oraz przez API i platformy AWS, Google Cloud i Microsoft. Standardowe API kosztuje 4 USD za milion tokenów wejścia i 20 USD za milion tokenów wyjścia. Model przyjmuje tekst i obrazy, odpowiada tekstem, mieści milion tokenów kontekstu i generuje do 128 tys. tokenów. Obsługuje narzędzia i sterowanie komputerem. Zapowiedź premiery oraz specyfikacja opisują dostępność i limity.
Opus 5.5 poprawia wyniki części zadań agentowych przy niższych stawkach niż Opus 5, ale ma też bardziej rozbudowane ograniczenia. Karta systemowa Opusa 5.5 opisuje przekazywanie wybranych żądań starszym modelom i regresję w obsłudze złośliwych instrukcji we wklejanym tekście. Te warunki wpływają zarówno na zastosowania, jak i na interpretację testów.
Wyniki programistyczne zależą od poziomu rozumowania
W Terminal-Bench 4.0 Anthropic uzyskało 66,4% dla Opusa 5.5 przy xhigh, wobec 52,3% dla Opusa 5 przy max. Test obejmuje 66 zadań wykonywanych w terminalu. Opus 5.5 działał w Claude Code z opcją --bare, po pięć prób na zadanie; Opus 5 miał ich piętnaście. Błąd standardowy nowego wyniku wynosił 2,6 punktu procentowego. Zabezpieczenia były włączone, a model zastępczy obsłużył część żądań w 10% przebiegów. Wynik opisuje więc cały działający system. Karta systemowa, sekcja 8.5.
Cursor testuje modele we własnym oprogramowaniu prowadzącym agenta, które dostarcza narzędzia, zarządza rozmową i wykonuje kolejne kroki. W CursorBench 4.0 Opus 5.5 uzyskał 57,8% przy max, za 13,43 USD na zadanie. Przy high osiągnął 56,0% za 3,97 USD. Opus 5 przy max miał 46,6% za 11,95 USD. Tutaj dodatkowe wydatki na najwyższy poziom dały nowemu modelowi tylko 1,8 punktu więcej niż high.
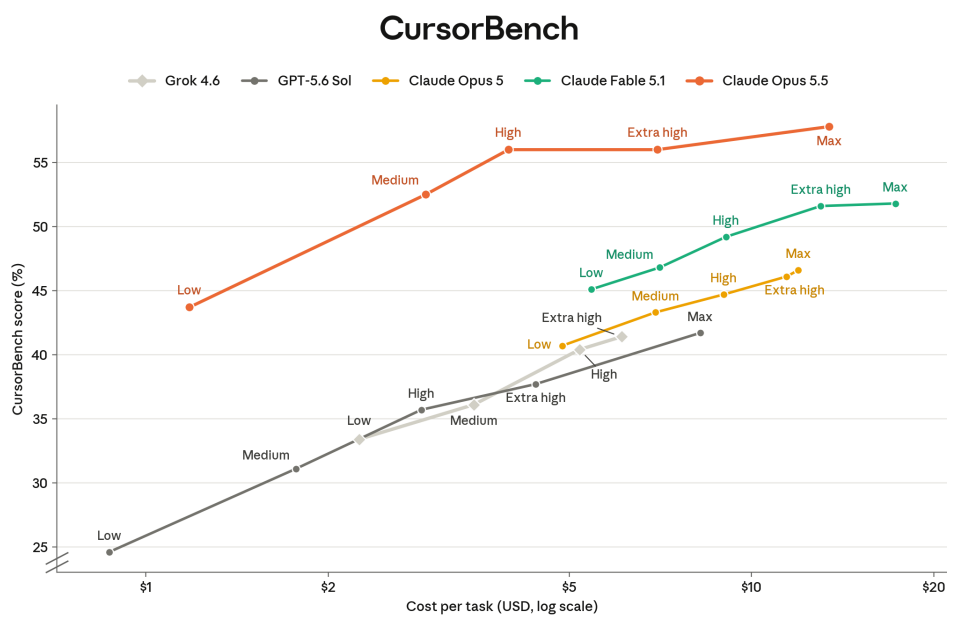
Źródło: Anthropic, karta systemowa, rys. 8.8.A; pomiary Cursor. Oś pionowa: wynik CursorBench 4.0 w procentach; pozioma: USD na zadanie, logarytmicznie. Punkty oznaczają poziomy rozumowania. Anthropic obliczyło koszt Opusa 5.5 z liczby tokenów; wykres nie pokazuje przedziałów niepewności, a oś wyniku zaczyna się od 23%.
Koszt w tabeli Cursora uwzględnia tokeny wejściowe, zapis i odczyt ponownie używanego kontekstu oraz wyjście. To pomiar z niejednoznacznych zadań obejmujących wiele plików, a nie cena pojedynczej odpowiedzi. Nie należy przenosić tych kwot na projekt z inną historią rozmowy, narzędziami i sposobem skracania kontekstu.
Automatyzacja pracy i badania naukowe dają różne wyniki
W AutomationBench 1.0.6 Opus 5.5 przy max osiągnął 40,0%, wobec 26,9% Opusa 5 i 41,4% GPT-6 Astra, również przy max. Zadania wymagają zmian w symulowanych aplikacjach firmowych zgodnych z zestawem reguł. W tym pomiarze Zapiera zablokowane próby liczono jako porażki, bez przełączania na starszy model. Opis testów Anthropic.
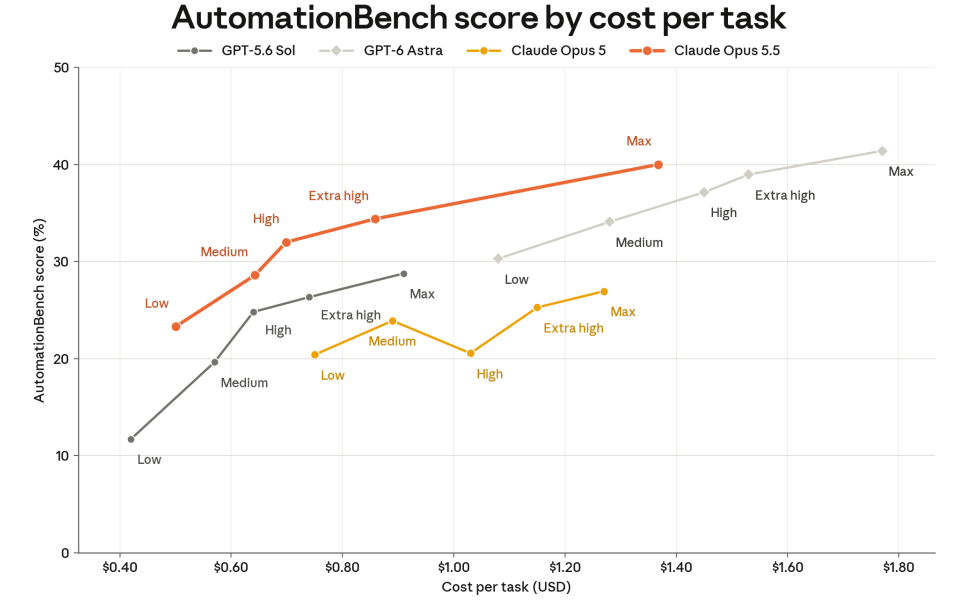
Źródło: Anthropic, karta systemowa, rys. 8.14.6.A. Oś pionowa: procent zaliczonych zadań AutomationBench 1.0.6; pozioma: USD na zadanie. Koszt Opusa 5.5 wyliczono z tokenów zarejestrowanych przez Zapier, według cen katalogowych z ponownym użyciem kontekstu. Pozostałe koszty pochodzą z zestawienia Zapiera. Punkty obejmują różne poziomy rozumowania. Kwoty na tym wykresie z karty różnią się od obecnej tabeli Zapiera, która podaje 1,28 USD dla Opusa 5.5 max; nie należy łączyć obu zestawów kosztów.
W Terminal-Bench-Science 0.1 producent podaje 58,7% dla Opusa 5.5 i 64,6% dla Astry, przy max. Opus działał w Claude Code --bare: po dziesięć prób dla 70 zadań, z zastępstwem w 5% przebiegów. Błąd standardowy, liczony z grupowaniem prób według zadania, wyniósł 4,8 punktu. Wynik Astry pochodzi z pomiaru OpenAI. To inny zestaw niż Terminal-Bench 4.0, więc wysokiego wyniku w terminalu nie można traktować jako przewagi we wszystkich zadaniach badawczych. Tabela premiery i sekcja 8.6 karty opisują te warunki.
Sonar zmierzył mniej kodu, bez poprawy odsetka zaliczonych testów
Sonar zbadał Opusa 5.5 przy High, porównując go z konfiguracją opisaną jako Opus 5 Thinking. W 544 zadaniach Java z HumanEval i MBPP, które miały wykonywalne testy, wyniki wyniosły odpowiednio 87,68% i 88,6%. Pełny zbiór 4444 zadań obejmował również ComplexCodeEval, używany do analizy kodu, lecz nie do wyliczenia tego odsetka.
Nowy model wygenerował 27,5% mniej wierszy. Liczba usterek wskazanych przez analizator spadła z 528 do 428, ale ich gęstość wzrosła z 576 do 644 na milion wierszy. Mniejszy wynik bezwzględny wynika więc częściowo z mniejszej ilości kodu. Sonar sprzedaje użyty analizator SonarQube; badanie jest niezależne od Anthropic, ale ma komercyjny kontekst. Obejmuje jeden język i określone konfiguracje, a nie całą pracę agenta nad repozytorium. Nie daje podstaw do obietnicy ogólnego spadku liczby błędów.
Zabezpieczenia obejmują zmianę modelu i oznaczanie wklejonego tekstu
W karcie Opusa 5 Anthropic opisywało możliwości cybernetyczne niższe niż Mythos 5 i dopuszczenie szukania luk w kodzie źródłowym. Opus 5.5 zachowuje możliwość takiej pracy, lecz stosuje szersze ograniczenia. W produktach Anthropic wybrane zadania cybernetyczne przechodzą do Opusa 4.8, biologiczne i niektóre prace nad zaawansowanymi modelami do Opusa 5. W API zastępstwo trzeba włączyć lub obsłużyć samodzielnie. Odmowa może mieć status HTTP 200 i stop_reason: "refusal". Dokumentacja migracji.
Karta 5.5 opisuje też pomyłkę wyuczoną podczas treningu: model uznawał instrukcje wewnątrz wiadomości użytkownika za zaufane, nawet gdy pochodziły z wklejonego cudzego tekstu. Po poprawkach wydany model nadal wykonywał lub przekazywał takie instrukcje w około 2% prób przy ustawieniu domyślnym i 7,4% przy max. Dopiero dodatkowe oznaczanie wklejanej treści i usuwanie niewidocznych znaków wyeliminowało wykonania w opisanym teście. Była to symulacja, nie pomiar częstości ataków u klientów. Karta, sekcja 6.5.1.
Migracja zmienia parametry API i rachunek za zadanie
StationX zwraca uwagę na niezgodności API, które łatwo przeoczyć przy samej zmianie identyfikatora modelu. Dokumentacja Anthropic potwierdza, że nie można wyłączyć rozumowania ani wymusić wywołania narzędzia przez tool_choice: any lub tool. Domyślny poziom zmienił się z high na medium. Na Claude API i Google Cloud nie działa już computer_20251124.
Dla kont utworzonych od 31 sierpnia 2026 ponowne wysłanie bloku rozumowania po zmianie wcześniejszych wiadomości, narzędzi lub polecenia systemowego domyślnie kończy się błędem 400. Własna implementacja skracania rozmowy wymaga więc sprawdzenia przed migracją. Instrukcja przejścia na Opusa 5.5.
Odczyt ponownie używanego kontekstu kosztuje 0,20 USD za milion tokenów, wobec 0,50 USD dla Opusa 5. Standardowe wejście i wyjście potaniały o 20%; podawane przez Anthropic około 40% oszczędności na typowych zadaniach to odrębna deklaracja uwzględniająca sposób używania modelu. Tryb Fast ma stawki 8/40 USD, a przetwarzanie wsadowe 2/10 USD. Specyfikacja i cennik.
Ars Technica opisuje premierę przez pryzmat kosztu użytecznej pracy. W przypadku własnego agenta warto porównać medium i high na tych samych zadaniach, zachowując narzędzia i zasady skracania rozmowy. Do rachunku trzeba włączyć nieudane próby i poprawki człowieka.
Źródła
Źródła pierwotne
- Anthropic: premiera Claude Opus 5.5.
- Anthropic: karta systemowa Opusa 5.5 oraz karta poprzedniego Opusa 5.
- Claude Platform: specyfikacja Opusa 5.5 i instrukcja migracji.
- Zapier: wyniki i metoda AutomationBench 1.0.6.
- Cursor: wyniki i metoda CursorBench 4.0.
- Sonar: własne pomiary kodu generowanego przez Opusa 5.5.
Niezależne analizy i relacje
- Nathan House, StationX: analiza kosztów, ograniczeń i zmian API.
- Samuel Axon, Ars Technica: premiery modeli i obniżki cen.
Wykorzystuję treści generowane przez AI jako część mojego codziennego procesu nauki.