OpenAI wydało GPT-5.2-Codex
OpenAI wydało 18 grudnia 2025 roku GPT-5.2-Codex, wersję GPT-5.2 dostrojoną do agentowego programowania. Model pojawił się w płatnych planach Codex — w CLI, IDE, chmurze i przeglądzie kodu — a dostęp przez API miał nadejść później.
Karta systemowa GPT-5.2-Codex opisuje model, izolację agenta, dostęp do sieci oraz oceny ryzyka. Codex nadal korzysta z kompakcji, aby prowadzić duże refaktoryzacje i migracje przez wiele okien kontekstu. OpenAI podkreśla też lepszą pracę w środowisku Windows i rozwój możliwości cybernetycznych.
Benchmarki
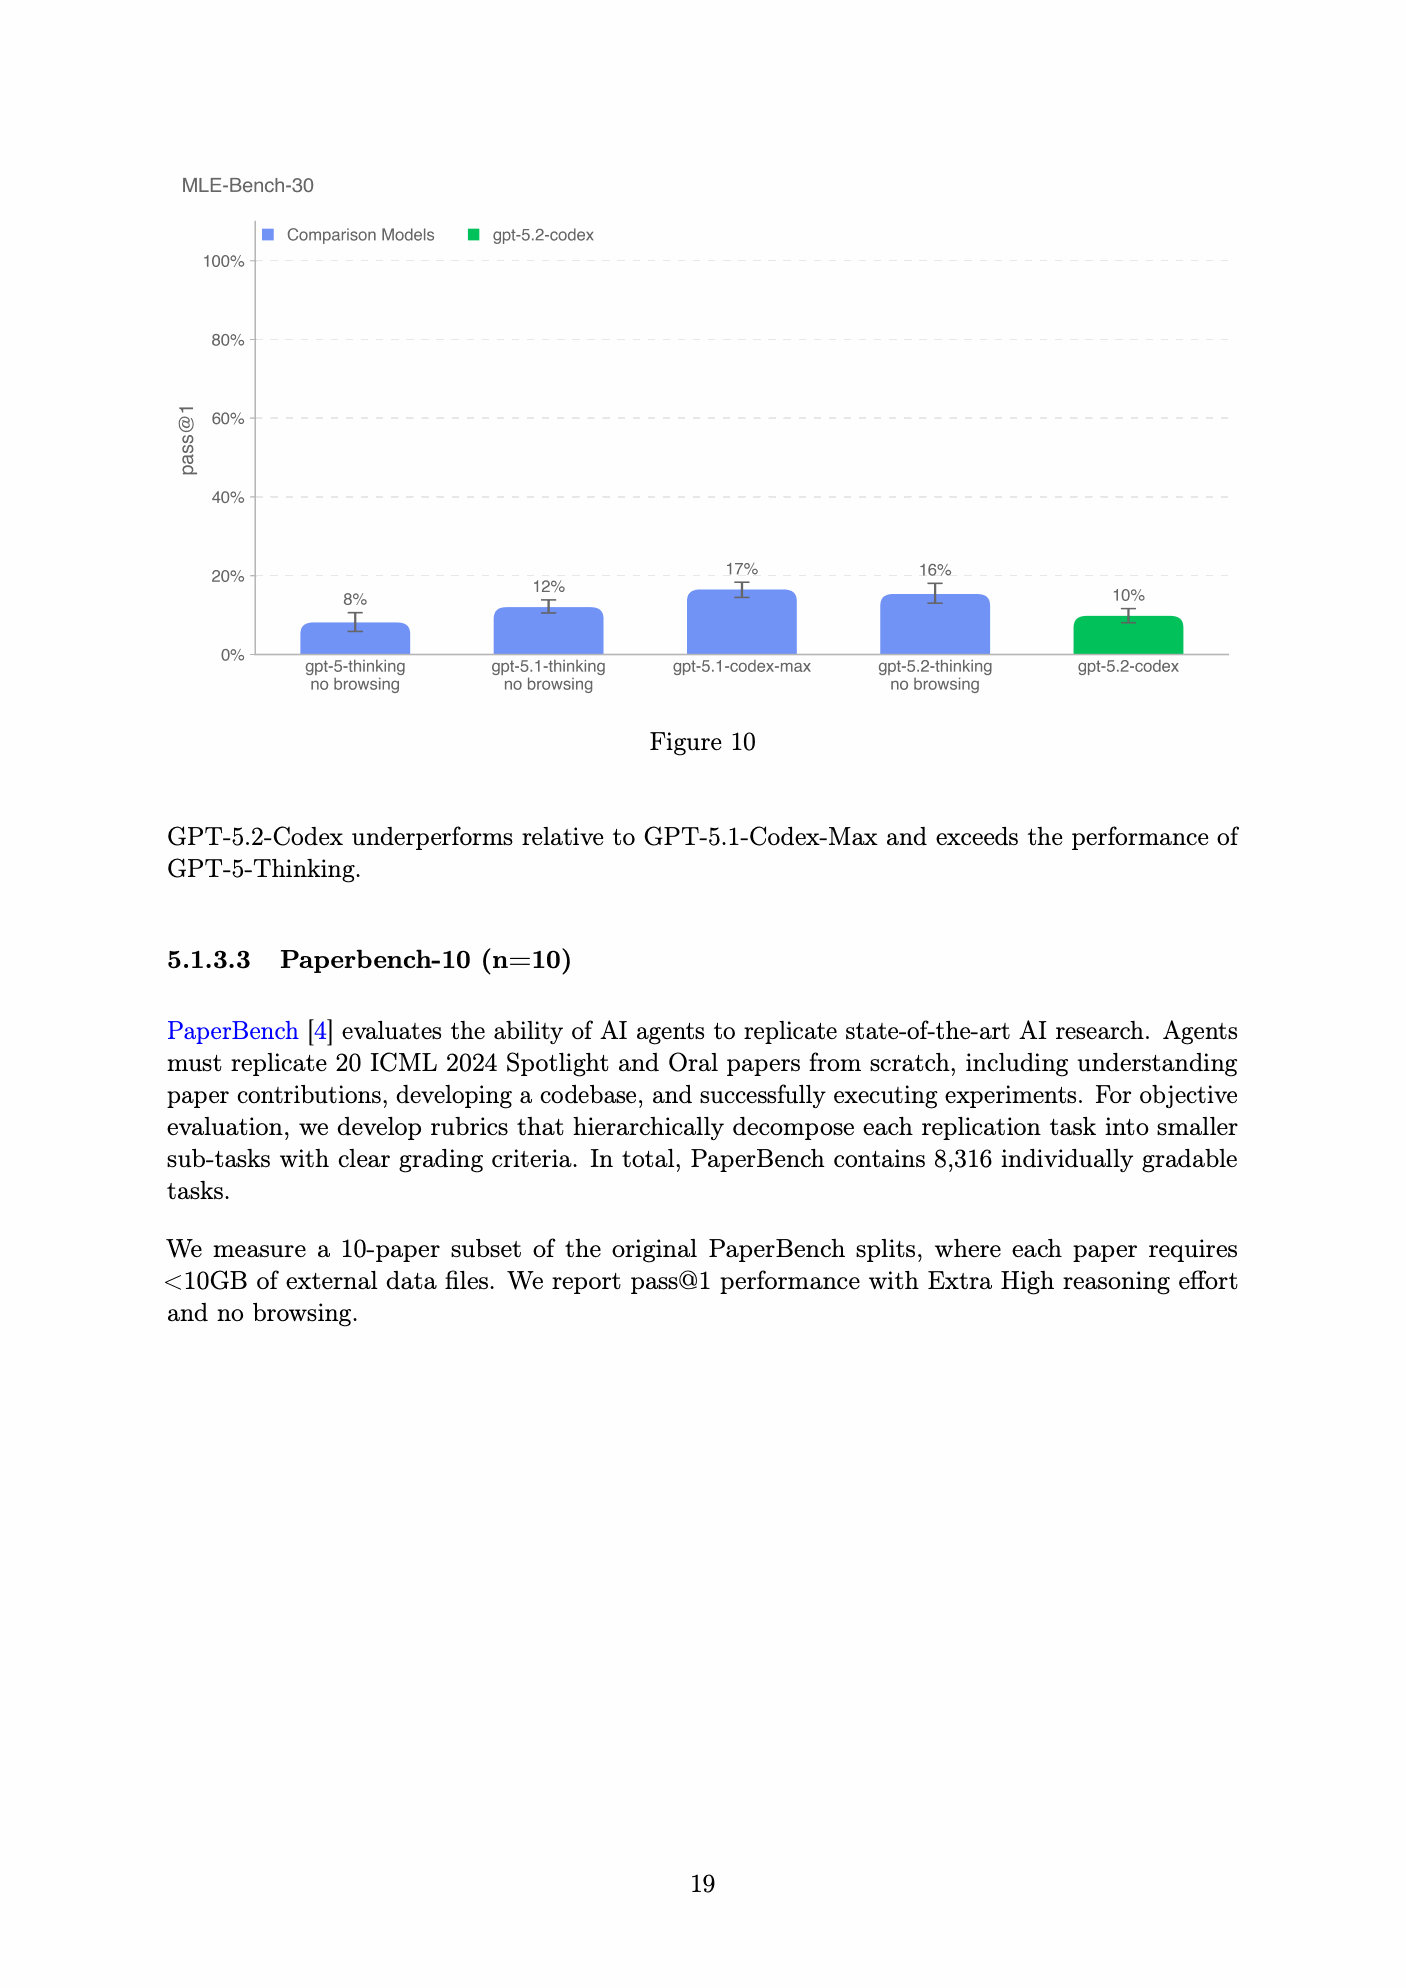
GPT-5.2-Codex nie poprawił każdego testu: w MLE-Bench-30 uzyskał 10%, wobec 17% GPT-5.1-Codex-Max. Źródło: karta systemowa OpenAI.
Materiał premierowy mówi o poprawie w dużych, rzeczywistych zadaniach programistycznych, ale nie daje jednej tabeli, która uczciwie streszczałaby wszystkie obszary. Karta systemowa pokazuje wynik bardziej złożony: nowy model ustanawia lepszy rezultat w części testów pracy badawczej, pozostaje na poziomie poprzednika w innych i przegrywa w MLE-Bench-30.
To bardziej użyteczne niż narracja o liniowym postępie. Dostrojenie do programowania nie musi poprawić autonomicznego trenowania modeli ani każdego testu cyberbezpieczeństwa.
Na co patrzeć w praktyce
W przypadku Codex jednostką oceny jest cały agent. Kompakcja, sandbox, dostęp do sieci, polecenia systemowe i narzędzia do edycji kodu współtworzą rezultat. Dlatego własny test powinien używać tego samego repozytorium, systemu operacyjnego i zasad zatwierdzania, które będą obowiązywały po wdrożeniu.
Karta wskazuje także, że model nie osiągnął progu High dla cyberbezpieczeństwa. Nie oznacza to braku ryzyka: agent z prawem zapisu i dostępem do sieci nadal wymaga minimalnych uprawnień oraz przeglądu zmian.
Źródła
Wykorzystuję treści generowane przez AI jako część mojego codziennego procesu nauki.