Hasło słownika · · 2 min czytania
Gradient Clipping
Zwykle model wykonuje umiarkowane poprawki, ale czasem gradient staje się bardzo duży. Jeden krok może wtedy mocno zmienić wagi i rozchwiać trening. Potrzebujesz ograniczyć siłę takiej wskazówki przed aktualizacją.
Gradient Clipping ogranicza gradient — listę liczb opisującą wpływ wag na błąd. W wariancie norm clipping skraca całą listę proporcjonalnie, jeśli jej długość przekracza ustalony próg. Kierunek pozostaje ten sam.
Lista [6, 8] ma długość 10. Przy progu 5 dostajemy [3, 4]. To jak skrócenie strzałki bez jej obracania. Obcinanie każdej współrzędnej osobno jest innym wariantem i może zmienić kierunek.
Ograniczenie gradientu nie jest automatycznie tym samym ograniczeniem ostatecznego kroku każdego optymalizatora, np. Adama. Nie rozwiązuje też zanikających gradientów. Przy Loss Scaling kolejność odskalowania i clippingu ma znaczenie.
Mechanizm i szczegóły
Dla gradientu , normy euklidesowej i progu :
Pascanu, Mikolov i Bengio, §3.2, algorytm 1 opisują tę strategię wobec gwałtownych wzrostów gradientu w RNN. Sam clipping nie rozwiązuje problemu zanikających gradientów.
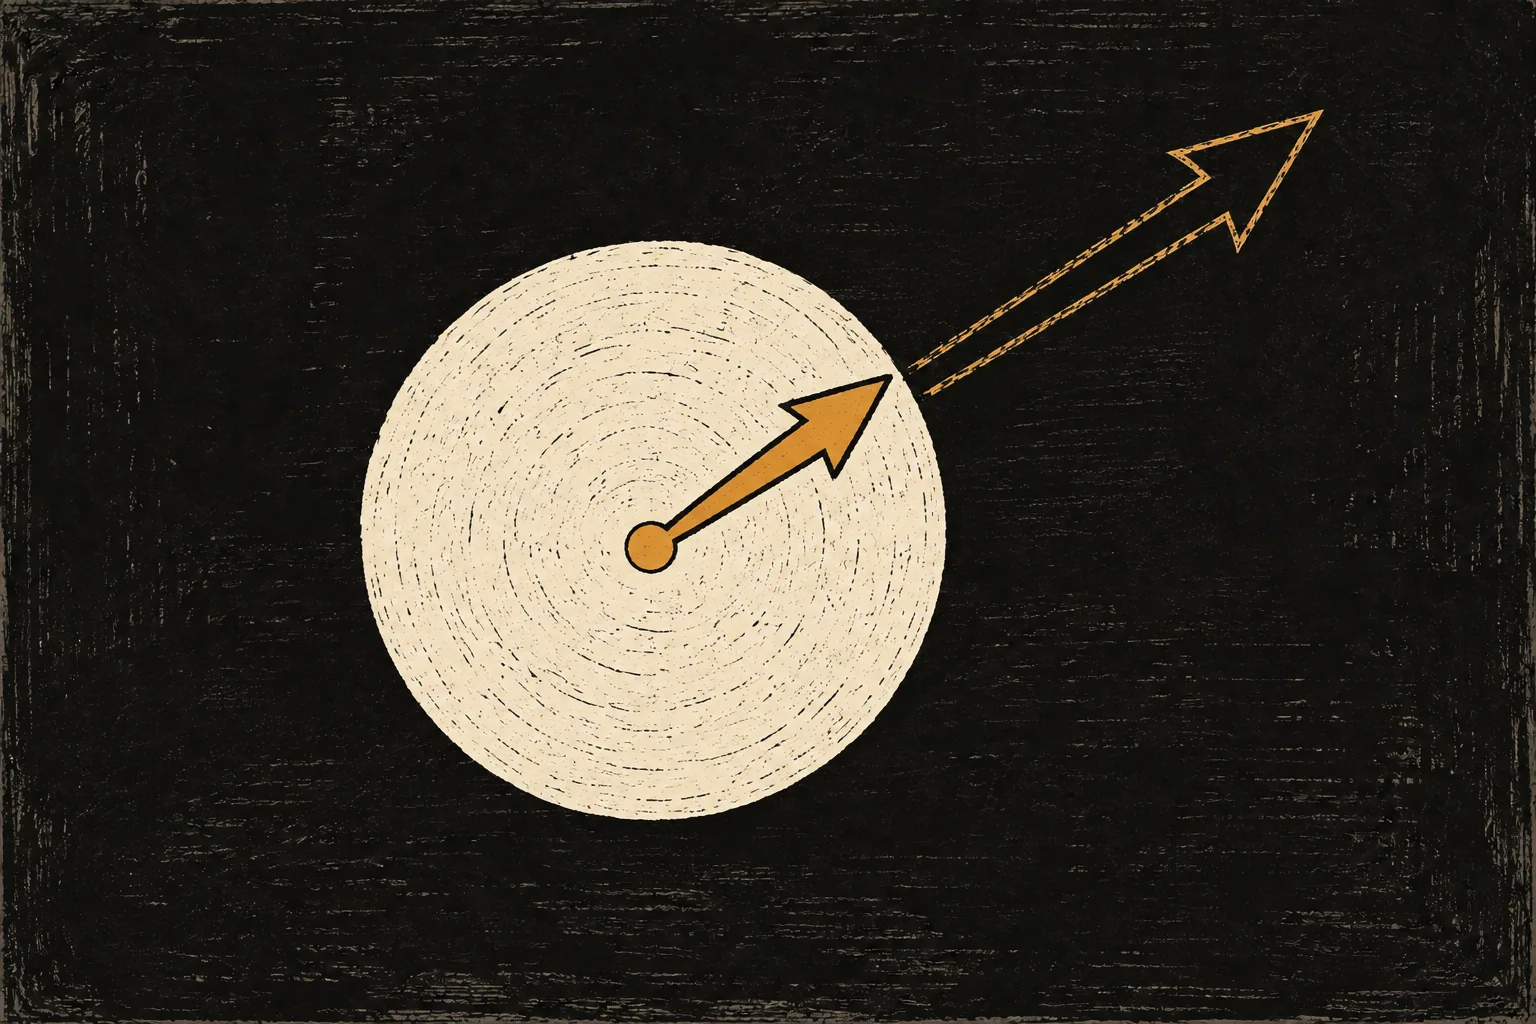
Skróć strzałkę, zachowaj kierunek
Własny przykład: ma normę 10. Przy progu 5 otrzymujemy . Dla zwykłego SGD bez momentum i learning rate 0,1 krok ma długość 0,5 zamiast 1. Tego ograniczenia długości kroku nie można automatycznie przenieść na Adam, który przekształca gradient za pomocą własnego stanu.
Przycinanie każdej współrzędnej osobno do przedziału daje natomiast : zmienia kierunek i pozostawia normę około 7,07. Oba warianty są użyteczne, lecz próg oznacza w nich coś innego.
W PyTorch clip_grad_norm_ norma obejmuje łącznie gradienty przekazanych parametrów. Liczenie osobnego limitu dla każdej warstwy da inne ograniczenie. Wartość NaN lub infinity wymaga diagnostyki; error_if_nonfinite=True pozwala jawnie zatrzymać taką aktualizację.
Kolejność zmienia wynik
Przy Loss Scaling najpierw odskaluj gradienty, aby próg odnosił się do ich rzeczywistej wielkości. Przy Gradient Accumulation zrób to po zebraniu całej efektywnej porcji, potem zastosuj clipping i krok. Taką kolejność podają przykłady AMP w PyTorch.
Clipping jest nieliniowy. Dwa wkłady 10 i −9 sumują się do 1; przycięcie sumy do przedziału [−5,5] zachowa 1. Przycięcie wkładów osobno da 5 i −5, czyli sumę 0. To własny kontrprzykład pokazujący, dlaczego granica akumulacji ma znaczenie.