术语 · · 1 分钟阅读
Elastic Weight Consolidation
一个模型负责把客户的提问分派给“配送”和“退货”两个部门。现在它要学会识别投诉,可旧的消息已经不允许再保存了。所以学习时没法回放它们。旧任务留下的唯一东西就是模型本身:在早先的训练中调好的数以百万计的数字,称为权重。
可以不加任何限制地让模型学习投诉。那样,权重会朝着对新任务有利的方向移动,其中也包括识别配送和退货所依赖的那些权重。也可以对每一处改动施以同样的惩罚,但那样模型会死死守住旧的设置,新东西学不好。我们需要回答的问题是:哪些权重可以动,哪些最好别动?
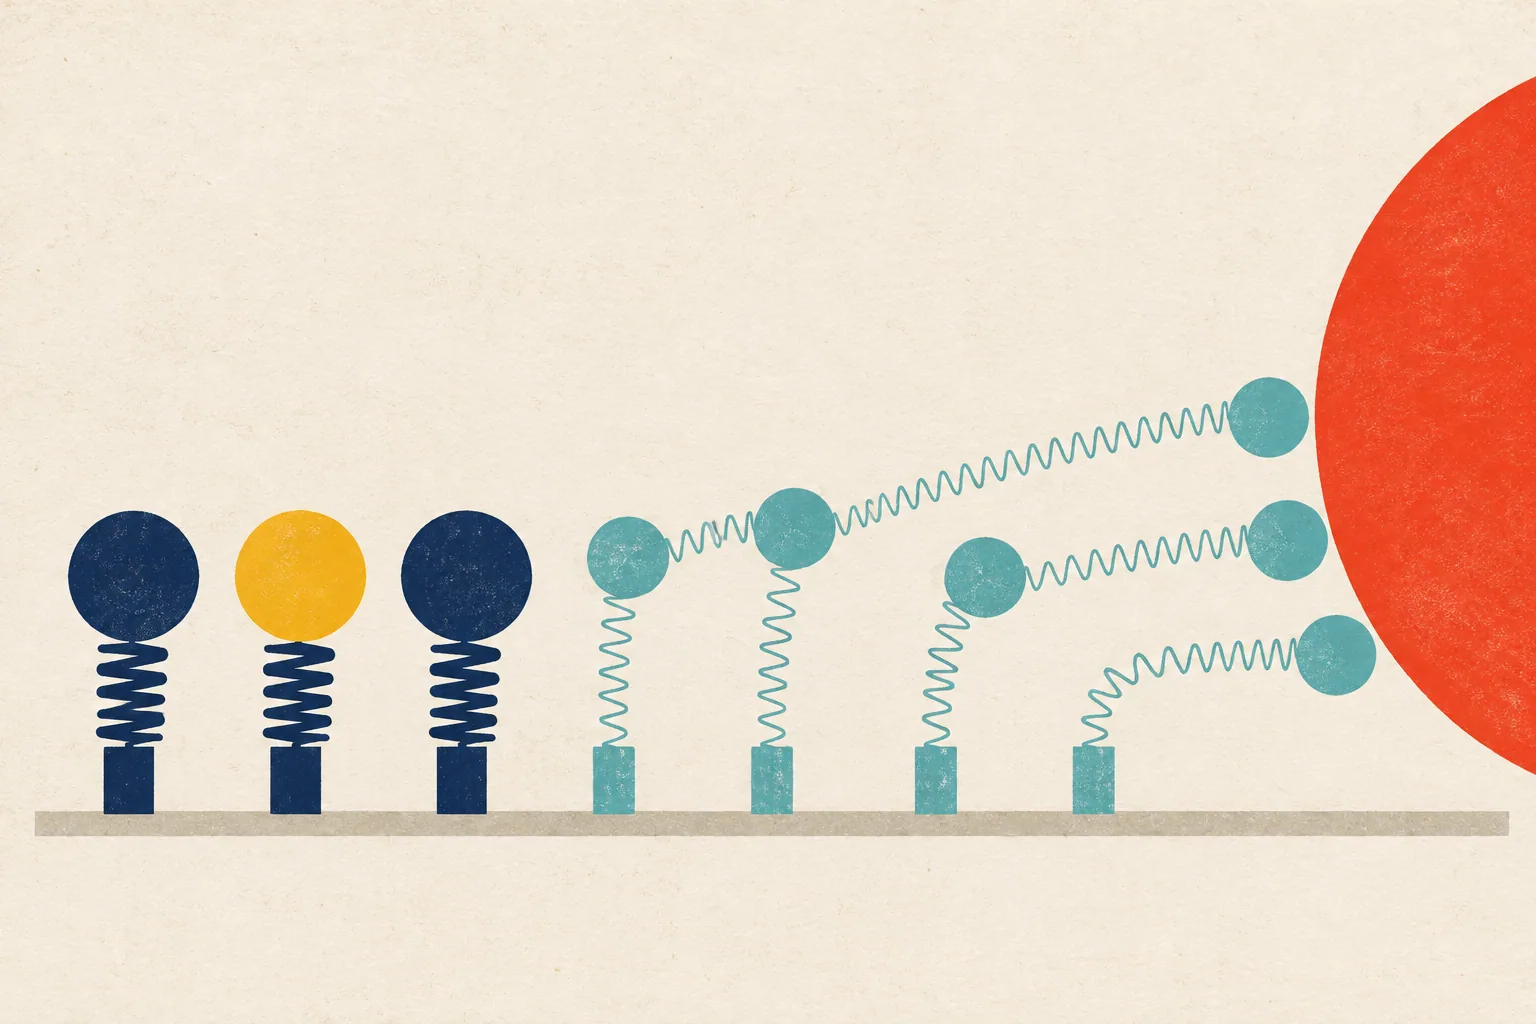
Elastic Weight Consolidation (EWC) 在新任务的学习中加入一项惩罚,惩罚权重偏离旧任务结束时的取值,而且某个权重对旧任务越重要,惩罚就越大。作者把它比作系在每个权重上的弹簧:重要的权重上弹簧硬,其余的权重上弹簧松(Kirkpatrick et al., Overcoming catastrophic forgetting in neural networks, §2)。
两个权重,一项新任务
我们只取两个权重。学完配送和退货之后,两者的值都是 1。第一个对旧部门非常重要(重要性 10),第二个几乎无关紧要(重要性 0.1)。新任务只要求两个权重之和等于 4。满足这一点的设置有很多:(2, 2) 可以,(1, 3) 也可以。
- 不加保护时,学习让两个权重移动同样的距离,到达 (2, 2)。新任务学会了,但重要的权重跑开了 1,旧任务上的损失从 0 升到 5.05。
- 对两个权重施加同等惩罚,会让它们停在半路,停在 (1.67, 1.67)。旧任务受的损害小一些,但和是 3.33 而不是 4。
- EWC 把几乎全部的移动都转到不太重要的权重上:(1.02, 2.80)。和为 3.82,旧任务上的损失只有 0.16。
损失是一个数字,表示模型错得有多厉害;越小越好。在下面的实验中,你可以改变惩罚强度 λ 和保护方式。结果是针对这个两权重的例子精确算出来的;这不是对真实网络的模拟。
怎么知道哪个权重重要
在真实的网络里,没有人事先给出重要性。它是在旧任务结束之后、其数据还可以取得的时候估计出来的:考察某个权重的微小变化会在多大程度上改变模型对旧样本的回答。论文为此使用了 Fisher 信息矩阵的对角线,也就是每个权重对应一个重要性数字。之后数据就可以删除;留下的是权重的旧值和它们的重要性。
在新的学习过程中,被最小化的是两项之和(论文中的公式 3):
是新任务上的损失, 是第 个权重的当前值, 是它在旧任务结束时的值, 是它的重要性,而 表示旧任务相对于新任务有多大分量。在我们的例子中,,。
方法的边界
重要性是在一个点上、对每个权重分别计算的近似值。作者自己就指出,他们的估计在判断哪些权重无关紧要时往往过于自信,并把这称为该方法的主要弱点(§2.2 和 §3)。在他们的 Atari 游戏实验中,带 EWC 的智能体依次学会了许多游戏,但没有赶上为每个游戏单独训练的网络。这些结果针对的是数字识别和游戏,而不是大型语言模型。我们的两个权重和客户消息是自拟的简化。
- Catastrophic Forgetting [Polski] 是新的学习之后旧能力的显著退化;EWC 试图在无法取得旧数据的情况下减轻它。
- Experience Replay 用另一种方式解决同一个问题:它保存的是一部分旧样本,而不是权重的重要性。
- Continual Learning 确定的是目标,也就是在保留原有任务的同时学习后续的任务;EWC 是其中一种方法。
- Fine-tuning [Polski] 是对现成模型的继续训练;EWC 改变了它的目标,为改动重要权重加上惩罚。
文字和插图在 AI 的协助下完成。两个权重、它们的重要性和演示是自拟的简化教学示例;插图是比喻,而不是模型构造的示意图。