Gemini 4 Argon. Milion tokenów wyjścia i ograniczona premiera
Google DeepMind ogłosiło 30 września 2026 roku Gemini 4 Argon, model do wieloetapowej pracy nad kodem, dokumentami i bezpieczeństwem systemów. Na początek otrzymują go wybrani partnerzy od cyberbezpieczeństwa. Pozostali użytkownicy dostają zapowiedź dostępu, wyniki testów i przyszłe ceny API.
Kto dostanie Argon i ile będzie kosztować
Pierwszy etap przebiega przez Fairwind Program. Google sprawdza organizacje ubiegające się o dostęp i priorytetowo traktuje instytucje chroniące infrastrukturę krytyczną. Partnerzy mogą używać modelu samodzielnie albo w CodeMender, agencie wyszukującym i naprawiającym luki.
Szersze udostępnianie ma zacząć się od płacących klientów API i abonentów Google AI Ultra. Komunikat nie podaje daty tego etapu ani harmonogramu dla innych planów konsumenckich.
Zapowiedziane ceny dotyczą miliona tokenów:
| Okres | Wejście | Wyjście |
|---|---|---|
| Promocyjny | 2 USD | 10 USD |
| Po promocji | 4 USD | 20 USD |
Nie podano terminu zakończenia promocji. Odczyt wejścia z pamięci podręcznej ma być tańszy o 95%; przy cenie promocyjnej daje to 0,10 USD za milion tokenów — własne obliczenie. Rachunek za zadanie agenta obejmuje wszystkie jego wywołania, a nie tylko ostatnią odpowiedź.
Milion tokenów generowania
Google podnosi limit tokenów wyjściowych do miliona, aby model mógł dłużej rozumować i generować w jednym przebiegu. Nie oznacza to miliona tokenów gotowego tekstu w każdej odpowiedzi.
Limit generowania określa, ile model może wytworzyć, a okno kontekstu — ile informacji może przetwarzać. Artificial Analysis podaje dla badanej konfiguracji Argon high okno kontekstu 1 mln tokenów, wejście tekstowe i obrazowe oraz wyjście tekstowe. Opis nie stanowi pełnej specyfikacji przyszłego publicznego API; Google pokazuje także testy rozumienia wideo.
Dla porównania karta Gemini 3.1 Pro podawała już milion tokenów kontekstu, ale tylko 64 tys. wyjścia. Nowość dotyczy więc przede wszystkim długości generowania. W zadaniu programistycznym większy limit może pozwolić dłużej analizować błędy i sprawdzać kolejne poprawki.
DeepSWE pokazuje przewagę, inne testy kodowania — słabszy wynik
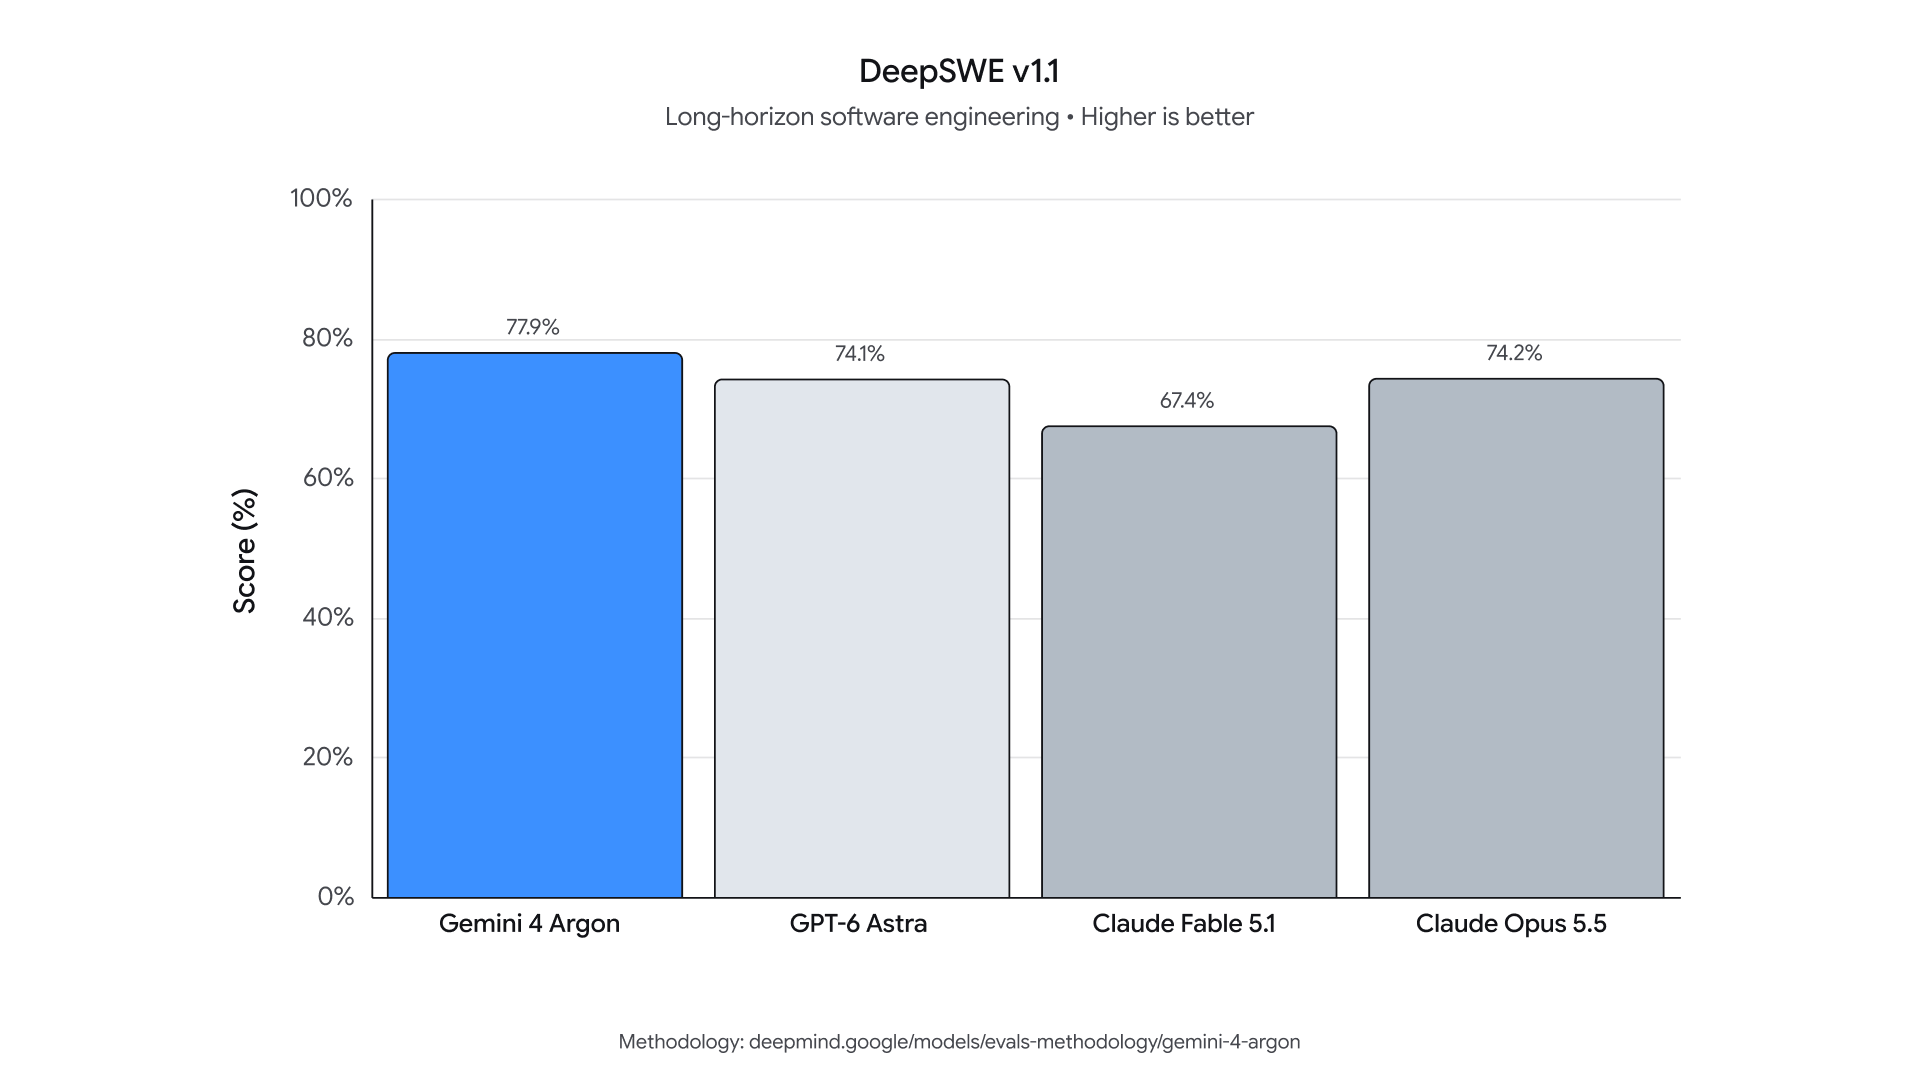
Źródło: Google, komunikat premierowy. DeepSWE v1.1 mierzy skuteczność w długich zadaniach programistycznych; wyższy wynik jest lepszy. Google zmierzyło Argon w mini-swe-agent, a wyniki konkurentów zaczerpnęło z publicznego rankingu i kart systemowych. Wykres nie pokazuje kosztów ani przedziałów niepewności.
Argon uzyskał 77,9%, wobec około 74% dla Astry i Opusa. Metodologia Google opisuje pomiary zasadniczo jako pass@1, czyli skuteczność pojedynczej próby, bez głosowania między odpowiedziami i równoległego uruchamiania wielu prób. Model pracował na najwyższym poziomie rozumowania, o ile opis danego testu nie wskazuje wyjątku. Dla DeepSWE dobierano najwyżej punktowane poziomy rozumowania poszczególnych modeli.
W tej samej oficjalnej tabeli inne testy programowania dają odmienną kolejność:
| Test | Gemini 4 Argon | GPT-6 Astra | Claude Opus 5.5 |
|---|---|---|---|
| FrontierSWE v2 | 55,0% | 65,5% | 62,3% |
| Terminal-Bench 4.0 | 57,4% | 58,2% | 66,4% |
FrontierSWE pochodzi z rankingu Proximal. Terminal-Bench dla Argon zmierzyło Google, a wyniki pozostałych modeli pobrało z publicznej tabeli. Nie jest to eksperyment, w którym wszystkie modele podmieniono w identycznym programie prowadzącym agenta.
Rozbieżność nie dowodzi trenowania pod benchmark. Pokazuje za to, że wynik DeepSWE nie wystarcza do ogłoszenia Argon najlepszym modelem do dowolnego programowania. Przy porównaniu na własnym repozytorium trzeba zachować te same narzędzia, zadania i budżet, a następnie policzyć poprawnie zakończone zmiany oraz czas poprawek człowieka.
Vals AI pokazuje także cenę i czas pracy
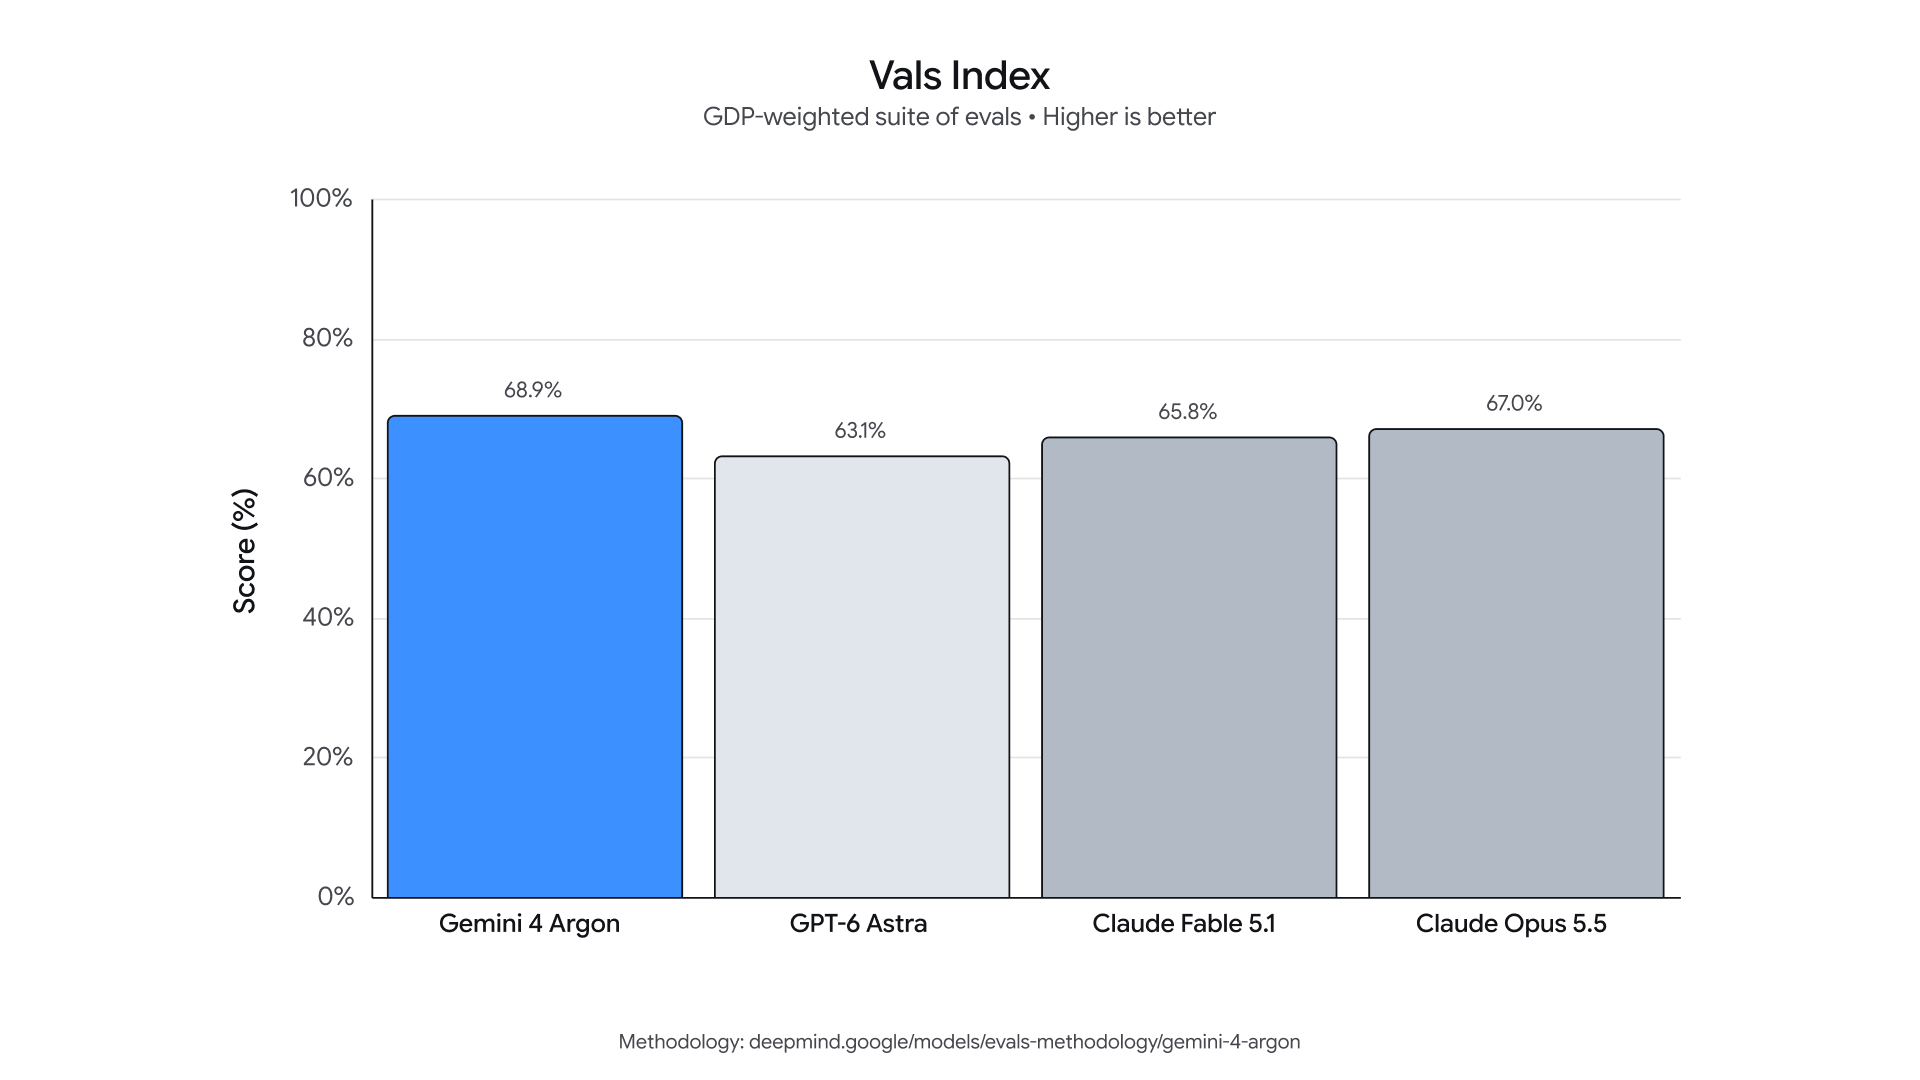
Źródło obrazu: Google, komunikat premierowy; źródło pomiarów: Vals AI. Oś pionowa przedstawia wynik Vals Index w procentach. Indeks waży sektory według udziału w PKB USA; wykres pomija koszty i czas wykonania.
W rankingu Vals AI Argon osiąga 68,90%, przy średnim koszcie 15,68 USD na test i czasie 46 min 33 s. Serwis liczy koszt według stawek 4 i 20 USD, czyli cen po promocji. Opus 5.5 ma 66,97%, koszt 32,14 USD i czas około 79 minut. To osobny pomiar zadań zawodowych, który pozwala ocenić więcej niż wysokość słupka.
Vals Index v2.1 łączy zadania finansowe, programistyczne, prawne i podatkowe. Wagi odpowiadają udziałom sektorów w amerykańskim PKB, a część zadań dotyczy amerykańskiego prawa i podatków. 68,90% nie oznacza automatyzacji takiej części gospodarki ani potwierdzonej skuteczności w polskim prawie.
Niezależny indeks i koszt promocji
Artificial Analysis, w stanie sprawdzonym 1 października, przyznaje konfiguracji high 53 punkty w Intelligence Index v4.3.2. Indeks łączy dziesięć ewaluacji i nie jest procentem poprawnych odpowiedzi. W jego pomiarze model wygenerował około 110 mln tokenów wyjściowych, a ważony średni koszt zadania wyniósł 1,99 USD przy cenach promocyjnych.
Jeżeli liczba tokenów pozostanie taka sama, a stosowane stawki podwoją się po promocji, analogiczny koszt wyniesie około 3,98 USD. To własne przeliczenie tego samego zużycia, nie nowy pomiar. Nie należy porównywać tej kwoty z 15,68 USD w Vals: oba serwisy używają innych zadań i sposobów agregacji.
Dostęp cybernetyczny ma osobne zasady
W oficjalnej tabeli Argon osiąga 68% w CWE-bench v1, teście naprawiania luk bezpieczeństwa. Taki sam wynik ma GPT-6 Astra, a Opus 5.5 — 67%. Metodologia wskazuje publiczny ranking jako źródło tych pomiarów.
Google zapowiada wyłączenie ograniczeń cybernetycznych dla zaufanych obrońców i własnych zespołów. Fairwind wymaga za to uwierzytelniania użytkowników, odpornego na phishing MFA oraz kontroli i ewidencji dostępu pracowników. Organizacja może udostępnić Argon swoim zespołom bezpieczeństwa, reagowania na incydenty i testów penetracyjnych; nie może odsprzedawać ani przekazywać dostępu dalej. Program dopuszcza autoryzowane badania i obronę systemów.
Na stronie modelu Google opisuje zabezpieczenia przed nadużyciami, odporność na złośliwe instrukcje ukryte w zewnętrznych treściach, monitorowanie rozumowania i działań agenta oraz izolowanie środowisk testowych. Monitor ma zatrzymywać wykonanie, gdy model wykracza poza zamiar użytkownika. Odporność na takie instrukcje jest szczególnie istotna dla agenta czytającego repozytoria i dokumenty: treść pliku nie może samodzielnie nadawać mu nowych uprawnień.
Karta wcześniejszego Gemini 3.1 Pro rozróżniała próg ostrzegawczy i krytyczny próg możliwości w cyberbezpieczeństwie. Model przekraczał pierwszy, ale pozostawał poniżej drugiego. Materiały premierowe Argon nie podają analogicznej tabeli ocen tych progów, więc nie pozwalają przypisać mu tej samej oceny ryzyka. Przy wdrażaniu agenta kontrolę dostępu do plików, poleceń i usług trzeba utrzymać również poza modelem.
Źródła
- Google DeepMind: Gemini 4 Argon — komunikat premierowy i strona modelu.
- Google DeepMind: Gemini 4 Argon — metodologia ewaluacji, wyniki z października 2026.
- Google DeepMind: Fairwind Program — dostęp i zasady użycia.
- Google DeepMind: karta Gemini 3.1 Pro, luty 2026.
- Vals AI: Vals Index v2.1 — wyniki, koszty i metodologia.
- Artificial Analysis: Gemini 4 Argon przy
high— wyniki, specyfikacja i koszt zadania, Intelligence Index v4.3.2.
Wykorzystuję treści generowane przez AI jako część mojego codziennego procesu nauki.