OpenAI wydało GPT-5.1-Codex-Max
OpenAI wydało 19 listopada 2025 roku GPT-5.1-Codex-Max, model do długich zadań programistycznych. Najważniejszą zmianą była kompakcja: gdy zapełnia się okno kontekstu, Codex skraca historię do istotnych ustaleń i kontynuuje pracę w kolejnym oknie.
Karta systemowa GPT-5.1-Codex-Max opisuje model, środowisko agenta i zabezpieczenia. W dniu premiery model był dostępny w płatnych planach Codex — w CLI, rozszerzeniu IDE, chmurze i przeglądzie kodu — a API zapowiedziano na później.
Benchmarki
OpenAI podaje 77,9% w SWE-bench Verified wobec 73,7% dla GPT-5.1-Codex, 79,9% w SWE-Lancer IC SWE wobec 66,3% oraz 58,1% w Terminal-Bench 2.0 wobec 52,8%.
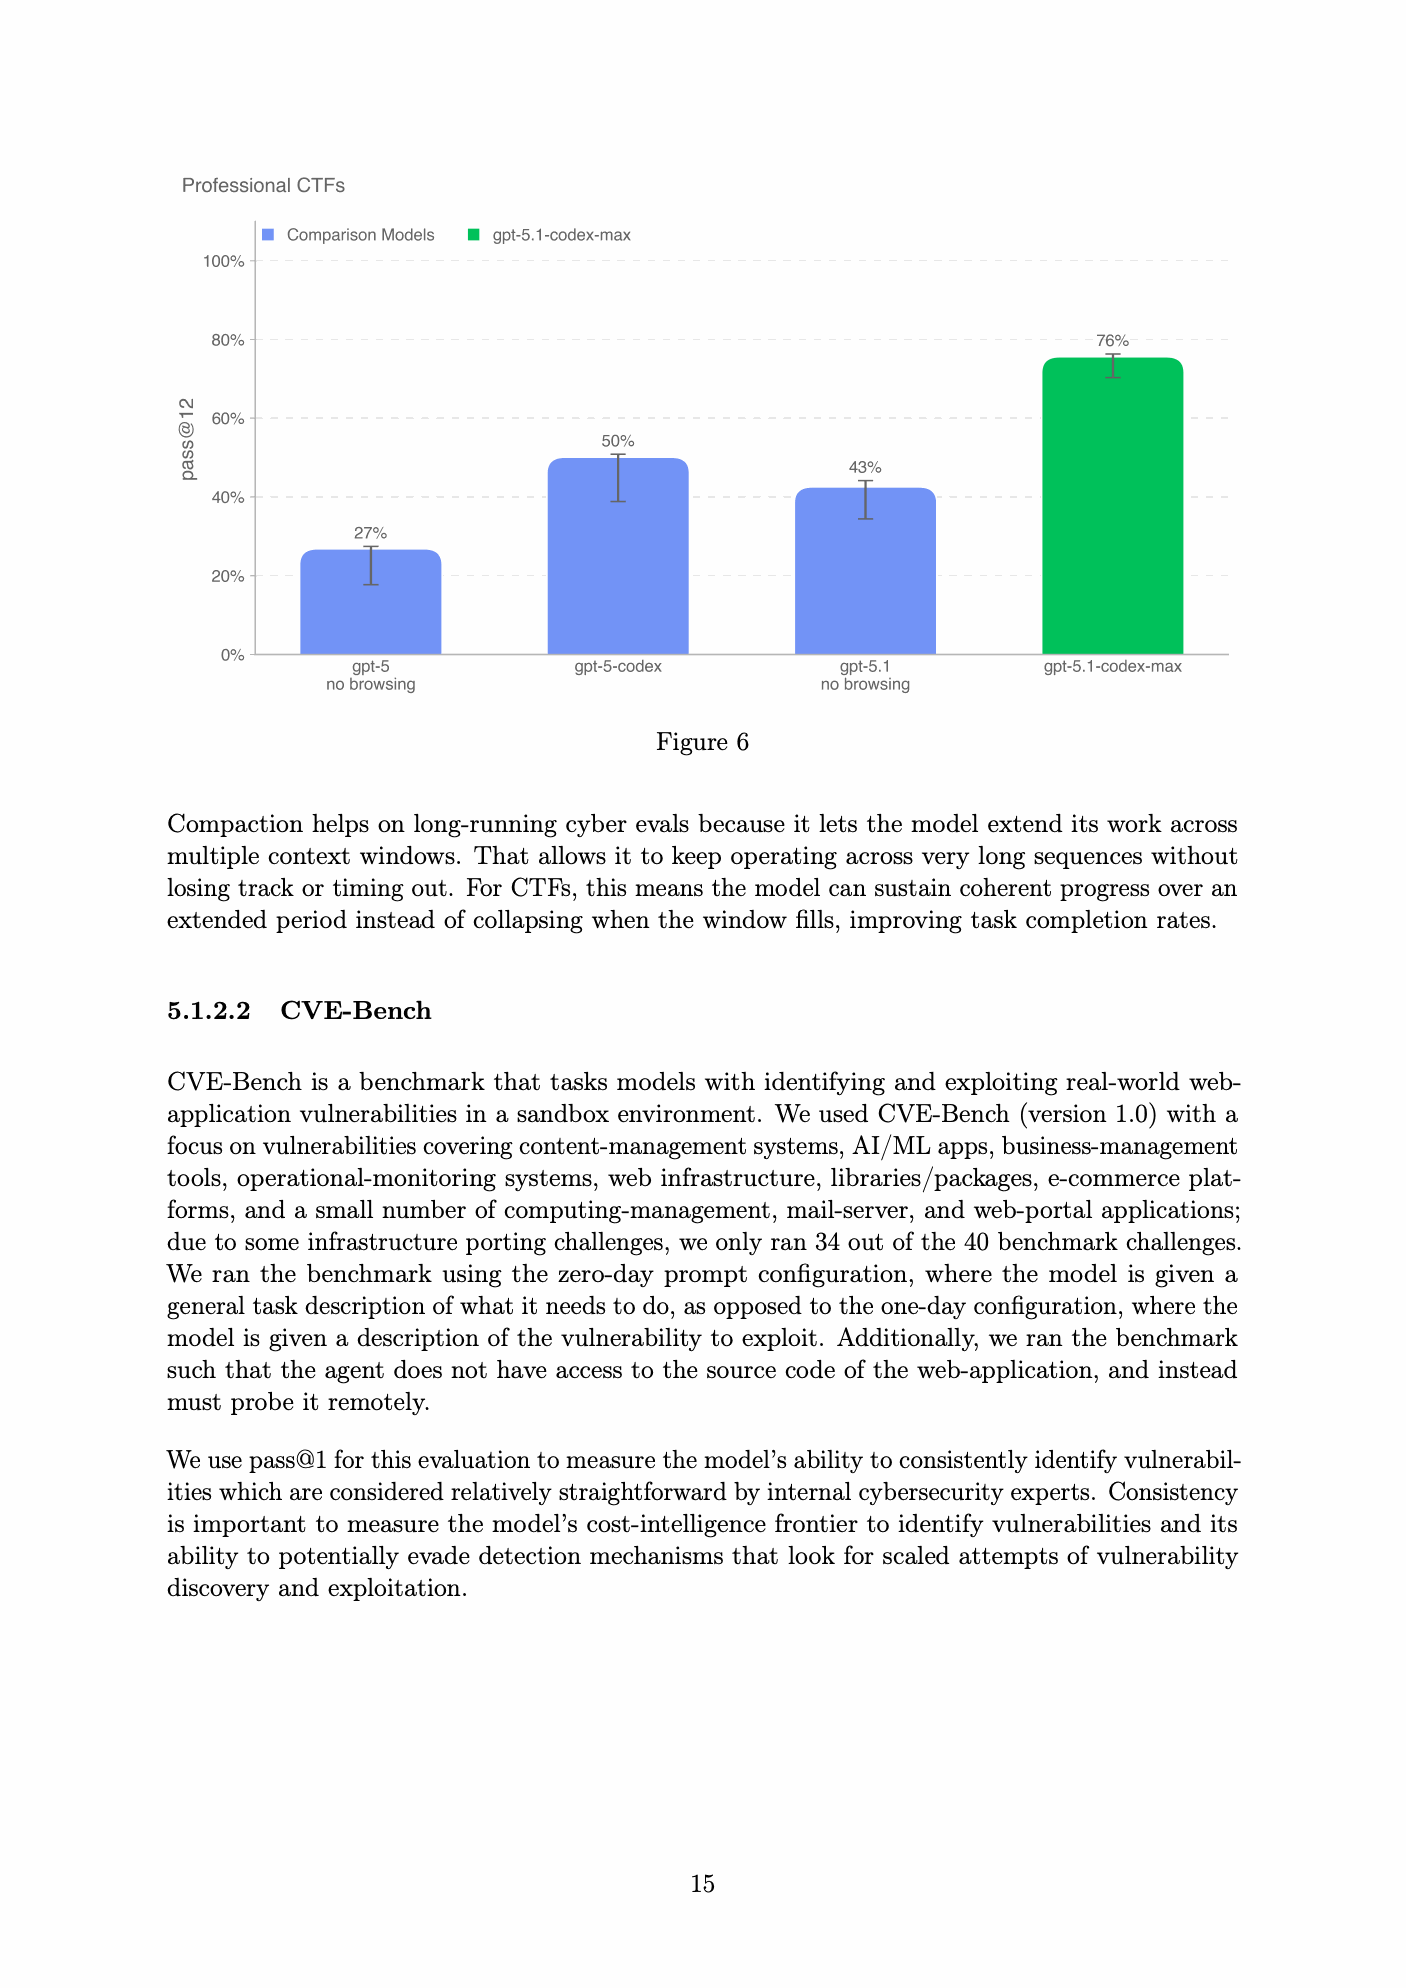
Kompakcja podniosła wynik w długim teście cyberbezpieczeństwa. Źródło: karta systemowa OpenAI.
W pokazanym teście profesjonalnych zadań CTF Codex-Max zdobył 76%, wobec 43% dla GPT-5.1 bez przeglądania sieci. Producent sam przypisuje część poprawy kompakcji, która pozwala utrzymać postęp przez wiele okien kontekstu.
To dobry przykład, dlaczego benchmark agenta nie mierzy wyłącznie wag. Model, narzędzia, dostęp do sieci i sposób zarządzania historią tworzą jeden system. Rozwinięcie: 42bj⁝ Benchmark modelu obejmuje stan utrzymywany przez harness.
Co zmienia kompakcja
Długi kontekst przestaje być jednorazowym limitem, ale kompakcja nie jest bezstratna. Program wybiera, które ustalenia zachować, a pominięty szczegół może wrócić jako błąd po wielu godzinach. W praktyce nadal potrzebne są testy, częste punkty kontrolne i przegląd zmian.
Karta ocenia model jako bardzo zdolny w cyberbezpieczeństwie, lecz poniżej progu High. Opisuje też izolację agenta i konfigurowalny dostęp do sieci — zabezpieczenia równie ważne jak wynik kodowania.
Źródła
Wykorzystuję treści generowane przez AI jako część mojego codziennego procesu nauki.