OpenAI wydało GPT-5.1
OpenAI wydało 12 listopada 2025 roku GPT-5.1 Instant i GPT-5.1 Thinking w ChatGPT, a dzień później udostępniło GPT-5.1 przez API. Instant ma sam decydować, kiedy potrzebuje krótkiego rozumowania, a Thinking dokładniej dopasowuje jego długość do trudności pytania.
Dodatek do karty systemowej GPT-5.1 opisuje zmiany w bezpieczeństwie i zachowaniu. Dokument dla deweloperów zawiera parametry API oraz wyniki zadań programistycznych.
Benchmarki
W SWE-bench Verified GPT-5.1 uzyskał 76,3%. OpenAI przeprowadziło test na wszystkich 500 zadaniach, korzystając z własnego harnessu i narzędzia apply_patch przyjmującego ustrukturyzowane poprawki. Wynik opisuje więc konkretny system programistyczny, nie sam model w dowolnej aplikacji.
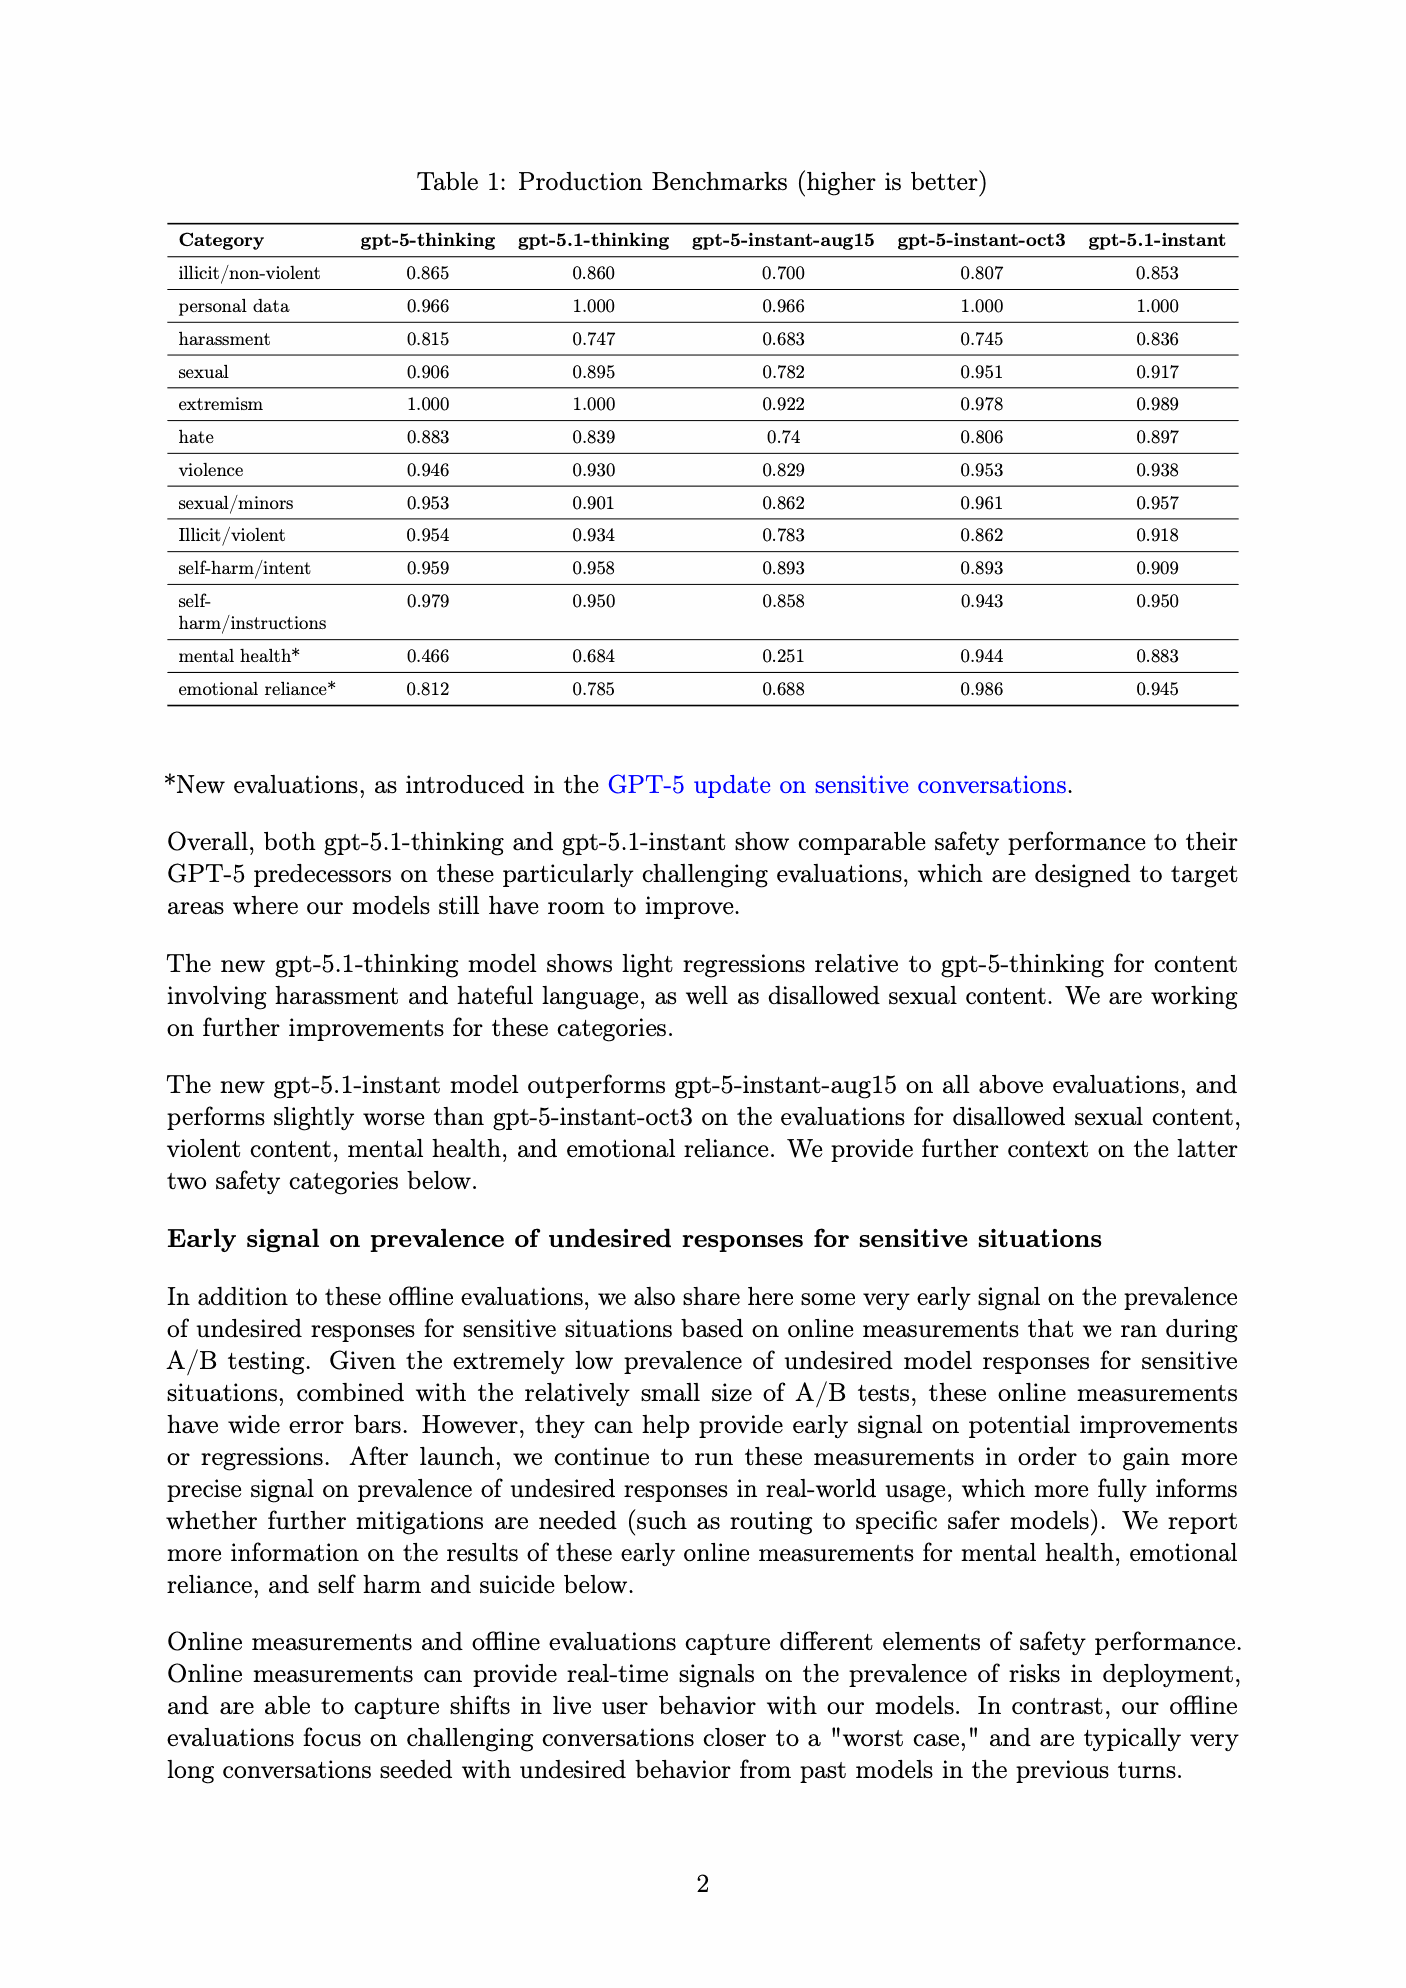
Benchmarki bezpieczeństwa GPT-5.1 z oficjalnej karty systemowej. Źródło: OpenAI.
Karta nie pokazuje wyłącznie jakości odpowiedzi. Rozszerza testy m.in. o zdrowie psychiczne i ryzyko budowania niezdrowej zależności emocjonalnej. To ważne, bo zmiana tonu na bardziej rozmowny może poprawić odbiór modelu, ale wymaga osobnego sprawdzenia zachowania w wrażliwych rozmowach.
Zmiany praktyczne
W API pojawił się tryb bez rozumowania, adaptacyjne rozumowanie i pamięć podręczna promptów działająca do 24 godzin. OpenAI dodało też narzędzia apply_patch i shell. Te funkcje mogą mieć większe znaczenie dla kosztu oraz niezawodności agenta niż kilka punktów w jednej tabeli.
Pierwszego dnia nie zauważyłem w zwykłej rozmowie wyraźnej różnicy. To nie przeczy testom producenta: premiera była nastawiona przede wszystkim na lepsze dopasowanie wysiłku i pracę z narzędziami, czyli cechy, których krótka rozmowa prawie nie sprawdza.
Źródła
20251113123357b⁝ LLM
Modele LLM
Wykorzystuję treści generowane przez AI jako część mojego codziennego procesu nauki.