Elastic Weight Consolidation
एक model ग्राहकों के सवालों को "डिलीवरी" और "वापसी" विभागों में भेजता है। अब उसे शिकायतें पहचानना सीखना है, लेकिन पुराने संदेशों को सँभालकर रखने की अब इजाज़त नहीं है। इसलिए training के दौरान उन्हें दोहराया नहीं जा सकता। पुराने task से जो कुछ बचा है, वह सिर्फ़ model ख़ुद है: पहले की training में तय हुई लाखों संख्याएँ, जिन्हें weights कहते हैं।
Model को शिकायतें बिना किसी रोक-टोक के सिखाई जा सकती हैं। तब weights उधर खिसकते हैं जिधर नए task को फ़ायदा हो, वे weights भी जिन पर डिलीवरी और वापसी की पहचान टिकी थी। हर बदलाव पर एक जैसी penalty भी लगाई जा सकती है, लेकिन तब model पुरानी settings से इतना चिपका रहता है कि नई चीज़ ठीक से सीख नहीं पाता। ज़रूरत इस सवाल के जवाब की है: किन weights को छेड़ा जा सकता है, और किन्हें न छेड़ना बेहतर है?
Elastic Weight Consolidation (EWC) नए task की training में इस बात की penalty जोड़ता है कि weights पुराने task के बाद वाले मानों से कितनी दूर जाते हैं, और कोई weight पुराने task के लिए जितना अहम था, penalty उतनी ही बड़ी होती है। लेखक इसकी तुलना हर weight से बँधी spring से करते हैं: अहम weights पर सख़्त, बाकी पर ढीली (Kirkpatrick et al., Overcoming catastrophic forgetting in neural networks, §2)।
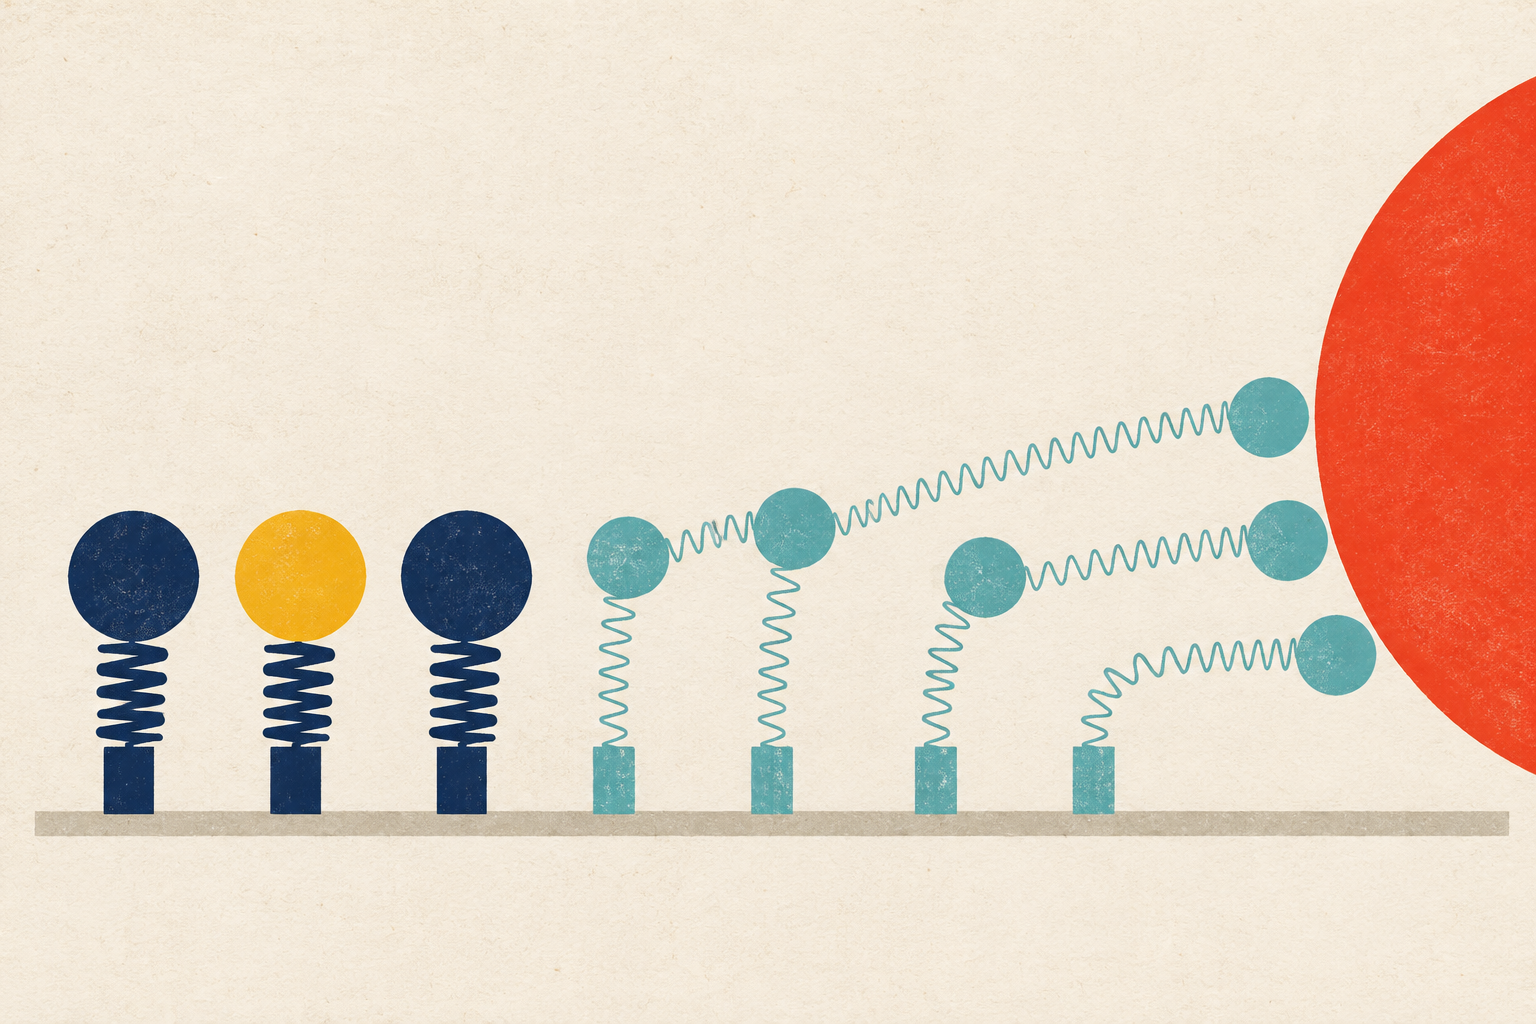
दो weights, एक नया task
सिर्फ़ दो weights लेते हैं। डिलीवरी और वापसी सीखने के बाद दोनों का मान 1 है। पहला पुराने विभागों के लिए बहुत अहम है (महत्व 10), दूसरा लगभग बेअसर (महत्व 0.1)। नया task बस इतना चाहता है कि दोनों weights का जोड़ 4 हो। यह कई settings से पूरा होता है: (2, 2), लेकिन (1, 3) भी।
- बिना सुरक्षा training दोनों weights को बराबर खिसकाती है, (2, 2) तक। नया task सीख लिया गया है, लेकिन अहम weight 1 से हट गया और पुराने task पर loss 0 से बढ़कर 5.05 हो जाता है।
- दोनों weights पर एक जैसी penalty उन्हें आधे रास्ते में, (1.67, 1.67) पर रोक देती है। पुराने task को कम नुक़सान होता है, लेकिन जोड़ 4 की जगह 3.33 है।
- EWC लगभग सारी हरकत कम अहम weight पर डाल देता है: (1.02, 2.80)। जोड़ 3.82 है, और पुराने task पर loss सिर्फ़ 0.16।
Loss वह संख्या है जो बताती है कि model कितना ग़लत है; यह जितनी छोटी हो, उतना अच्छा। नीचे के प्रयोग में आप penalty की ताक़त λ और सुरक्षा का तरीका बदल सकते हैं। नतीजा ठीक इसी दो weights वाले उदाहरण के लिए निकाला जाता है; यह किसी असली network का simulation नहीं है।
कैसे पता चलता है कि कौन-सा weight अहम है
असली network में महत्व कोई पहले से नहीं बताता। उसका अनुमान पुराना task ख़त्म होने के बाद लगाया जाता है, जब तक उसका data उपलब्ध है: यह देखा जाता है कि किसी weight में छोटा-सा बदलाव पुराने उदाहरणों पर model के जवाबों को कितना बदल देता है। पेपर इसके लिए Fisher information matrix के diagonal का इस्तेमाल करता है, यानी हर weight के लिए महत्व की एक संख्या। इसके बाद data हटाया जा सकता है; weights के पुराने मान और उनके महत्व बचे रहते हैं।
नई training के दौरान दो हिस्सों का जोड़ minimize किया जाता है (पेपर में समीकरण 3):
नए task पर loss है, weight संख्या का मौजूदा मान है, पुराने task के बाद उसका मान, उसका महत्व, और बताता है कि नए task के मुकाबले पुराना task कितना मायने रखता है। हमारे उदाहरण में और है।
इस तरीके की सीमाएँ
महत्व एक अनुमान है, जो एक ही बिंदु पर और हर weight के लिए अलग से निकाला जाता है। लेखक ख़ुद दिखाते हैं कि उनका अनुमान कभी-कभी इस बारे में ज़रूरत से ज़्यादा आश्वस्त होता है कि कौन-से weights ग़ैर-ज़रूरी हैं, और इसे इस तरीके की मुख्य कमज़ोरी बताते हैं (§2.2 और §3)। Atari games पर उनके प्रयोगों में EWC वाला agent एक के बाद एक कई games सीखता गया, लेकिन हर game के लिए अलग से train किए गए networks की बराबरी नहीं कर पाया। नतीजे अंकों की पहचान और games के बारे में हैं, बड़े language models के बारे में नहीं। हमारे दो weights और ग्राहकों के संदेश हमारा अपना सरलीकरण हैं।
- Catastrophic Forgetting [Polski] नई training के बाद पुरानी क्षमताओं में भारी गिरावट है; EWC पुराने data तक पहुँच के बिना इसे कम करने की कोशिश करता है।
- Experience Replay इसी समस्या को दूसरे ढंग से हल करता है: वह weights के महत्व की जगह कुछ पुराने उदाहरण सँभालकर रखता है।
- Continual Learning लक्ष्य बताता है, यानी पहले के tasks को बचाए रखते हुए नए tasks सीखना; EWC उसके तरीकों में से एक है।
- Fine-tuning [Polski] तैयार model की आगे की training है; EWC अहम weights को छेड़ने पर penalty जोड़कर उसका लक्ष्य बदल देता है।
पाठ और चित्र AI की मदद से तैयार किए गए हैं। दो weights, उनके महत्व और demonstration सिखाने के लिए बनाया गया मेरा अपना सरल उदाहरण हैं; चित्र एक रूपक है, model की बनावट का आरेख नहीं।